 FlowBoard
Mermaid slop: jak sprawdzać i poprawiać diagramy generowane przez AI, zanim je opublikujesz
Zespół FlowBoardNapisane z pomocą AI13 min czytaniaW skrócie:
- „Mermaid slop” to nazwa, która upowszechniła się w 2026 roku dla diagramów generowanych przez AI, które są poprawne składniowo, ale nieczytelne albo wprost fałszywe; termin wyszedł z projektu Diagram Design, który przedstawiał się hasłem „no Figma, no generic rounded boxes, no Mermaid-slop” i w sierpniu 2026 roku miał już ponad 11 000 gwiazdek na GitHubie (explainX, 16 sierpnia 2026).
- Problem urósł wraz z dystrybucją: VS Code 1.121 (20 maja 2026) renderuje Mermaid natywnie w podglądzie Markdown, bez rozszerzenia, a asystenci generują go domyślnie (Visual Studio Code).
- Model optymalizuje poprawność gramatyczną, a nie poprawność systemu: plik
.mmdsię parsuje, ale duplikuje węzły, pomija gałąź „nie” decyzji albo odwraca kierunek przepływu danych. - Sprawdzanie diagramu przez czytanie linii
-->nie działa: wady, które mają znaczenie, są topologiczne i widać je dopiero na narysowanym diagramie. - Cykl, który działa: zaimportować
.mmdna płótno, uporządkować warstwami, opisać to, co budzi wątpliwości, linkiem do kodu lub zgłoszenia, które to potwierdza, poprawić ręcznie i wyeksportować z powrotem, żeby do repozytorium trafiła wersja poprawiona.
Od połowy 2026 roku pytanie w zespołach inżynierskich nie brzmi już, jak wygenerować diagram, ale kto za niego odpowiada. Agenci piszą Mermaid w locie, GitHub i VS Code rysują go bez konfiguracji, a wynik trafia do README równie naturalnie jak blok kodu. Brakuje warstwy audytu. Ten artykuł omawia typowe wady, techniczny powód ich pojawiania się i powtarzalny cykl przeglądu, który kończy się na wizualnym płótnie — u nas jest to FlowBoard, nieskończona tablica do diagramów od AIsToHire, która importuje i ponownie eksportuje Mermaid — żeby opublikowany diagram był tym poprawionym, a nie pierwszym, jaki wypluł model.
Czym dokładnie jest „Mermaid slop”?
Mermaid slop to diagram wygenerowany przez AI, który kompiluje się bez błędów i mimo to na nic się nie przydaje: identyczne zaokrąglone pola dla różnych pojęć, strzałki bez etykiet albo z mętnymi etykietami, domyślne kolory, które nic nie mówią, i generowanie z odruchu — rysuje się, bo ktoś poprosił, a nie dlatego, że jest potrzebne. Definicję ustala przegląd explainX poświęcony temu terminowi (16 sierpnia 2026), który wywodzi go z projektu Diagram Design autorstwa Cathryn Lavery.
Ważny niuans polega na tym, że istnieją dwie warstwy „slopu” i często się je myli:
| Warstwa | Co zawodzi | Jak wykryć | Koszt naprawy |
|---|---|---|---|
| Estetyczna | Generyczne kształty, domyślna paleta, wszystko takie samo | Na pierwszy rzut oka | Niski: motyw, kształty, grupowanie |
| Semantyczna | Diagram opisuje system, który nie istnieje | Tylko przez porównanie z prawdziwym kodem | Wysoki: trzeba ponownie otworzyć repozytorium |
Publiczna dyskusja w 2026 roku skupiła się prawie całkowicie na pierwszej. Narzędzia, które się pojawiły — od skilli do redakcyjnego diagramowania po generatory tworzące natywne elementy Excalidraw zamiast tekstu Mermaid — atakują przede wszystkim wygląd. Druga warstwa, ta, przez którą diagram kłamie o twojej architekturze, wciąż jest pracą człowieka.
Dlaczego LLM tworzy Mermaid doskonały składniowo i ubogi semantycznie?
Ponieważ to dwa różne cele, a tylko jeden ma obfity sygnał treningowy. Gramatyka Mermaid jest zamknięta, niewielka i masowo reprezentowana na GitHubie: model odtwarza ją prawie bez błędów. Poprawność diagramu natomiast zależy od konkretnego systemu, którego model zwykle nie przeczytał w całości, więc wypełnia luki najczęstszą formą diagramu architektury, a nie twoją.
Do tego dochodzą trzy efekty praktyczne:
- Prompt jest jedynym źródłem. Jeśli opiszesz system w trzech zdaniach, agent zwróci diagram o szczegółowości trzech zdań i będzie go ozdabiał, aż wyda się kompletny. Jak ujmuje to sam Mermaid, pisząc o vibe diagramming, „diagram wygenerowany z niejasnego promptu odzwierciedli niejasność promptu” (Mermaid, 24 marca 2026).
- Nie ma kompilatora semantycznego. Czerwony test cię ostrzeże; niepoprawny diagram renderuje się równie ładnie jak poprawny. Nie istnieje odpowiednik
tscdla stwierdzenia „ta usługa nie istnieje”. - Układ wybiera silnik, a nie autor. Mermaid rozmieszcza węzły swoim algorytmem i nie daje wygodnego sposobu poprawienia układu po wyrenderowaniu. Jeśli rzeczywista hierarchia nie zgadza się z tym, co rysuje auto-layout, przegrywasz spór z narzędziem.
A kontekst branżowy mówi, że weryfikacja nie jest opcjonalna. Ankieta wśród programistów 2026 z Stack Overflow (opublikowana 6 października 2026, ponad 30 000 odpowiedzi ze 169 krajów) wykazała, że blisko połowa ufa wynikom AI tylko wtedy, gdy może je łatwo zweryfikować, a zaledwie 6,6 % uznałoby je za wiarygodne przy ważnych decyzjach. Diagram architektury w oficjalnej dokumentacji jest niemal z definicji ważną decyzją.
Siedem powtarzających się wad diagramu generowanego przez AI
Oto siedem, które pojawiają się raz po raz przy audycie plików .mmd generowanych przez agentów. Wszystkie się parsują; wszystkie są błędne. Wspólny wzorzec to wypełnianie przez model wiarygodną strukturą miejsc, w których brakuje mu wiedzy o domenie.
| # | Wada | Objaw w .mmd | Konsekwencja |
|---|---|---|---|
| 1 | Zduplikowane węzły | Dwa różne ID z podobnymi etykietami dla tej samej usługi | Wygląda, jakby były dwa komponenty tam, gdzie jest jeden |
| 2 | Decyzja bez gałęzi „nie” | Romb z jedną krawędzią wyjściową | Ścieżka błędu pozostaje nieudokumentowana |
| 3 | Przepływ bez terminatora | Łańcuchy kończące się na węźle procesu | Nie wiadomo, kiedy kończy się przypadek użycia |
| 4 | Odwrócony kierunek | Strzałka wskazuje na źródło danych | Odwraca się to, kto kogo wywołuje |
| 5 | Pole generyczne | Pojedynczy węzeł „Baza danych” | Ukrywa trzy magazyny o różnych gwarancjach |
| 6 | Fałszywa głębia | Warstwy lub subgraph, które nie istnieją w kodzie | Nadaje autorytet wymyślonej architekturze |
| 7 | Etykiety z promptu | Węzły powtarzają twoje słowa, a nie słownictwo domeny | Diagram nie jest wyszukiwalny ani rozpoznawalny |
1. Zduplikowane węzły, które są tą samą usługą
Model widział „auth” i „usługa uwierzytelniania” w dwóch różnych zdaniach i utworzył dwa węzły.
flowchart LR
  API[API Gateway] --> AUTH[Auth]
  API --> AUTHSVC[Usluga uwierzytelniania]
  AUTH --> DB[(Baza danych)]
  AUTHSVC --> DB
Po poprawce: jeden węzeł, jedno ID, nazwa, której używa zespół.
flowchart LR
  API[API Gateway] --> AUTH[auth-service]
  AUTH --> USERS[(postgres: users)]
2. Decyzje bez gałęzi „nie”
flowchart TD
  REQ[Request] --> Q{Token wazny?}
  Q -->|Tak| OK[Przetworz]
Romb z jednym wyjściem nie jest decyzją: to ozdoba. Każdy warunek potrzebuje obu ścieżek, a ścieżka błędu potrzebuje celu.
flowchart TD
  REQ[Request] --> Q{Token wazny?}
  Q -->|tak| OK[Przetworz]
  Q -->|nie| R401[Odpowiedz 401]
  OK --> FIN([Koniec])
  R401 --> FIN
3. Strzałki odwracające kierunek danych
Klasyk przy kolejkach i webhookach: model rysuje hierarchię organizacyjną zamiast rzeczywistego przepływu.
flowchart LR
  WORKER[Worker] --> QUEUE[Kolejka zadan]
Worker nie wpycha do kolejki: konsumuje z niej. Błędne narysowanie tego kierunku zamienia projekt pull w push, czyli inny system z innymi gwarancjami.
flowchart LR
  API[API] -->|kolejkuje| QUEUE[Kolejka zadan]
  QUEUE -->|konsumuje| WORKER[Worker]
4. Generyczne pole „Baza danych”
To najdroższa wada, bo znika dokładnie ta informacja, dla której ktoś w ogóle otwiera diagram. Węzeł [(Baza danych)], który w rzeczywistości oznacza Postgres do transakcji, Redis do sesji i S3 do załączników, nie dokumentuje: ukrywa. Reguła praktyczna: jeśli dwa magazyny mają różne gwarancje trwałości, to są dwa węzły.
5, 6 i 7: wymyślone warstwy i pożyczone etykiety
Podgrafy subgraph nazwane „Warstwa prezentacji”, „Warstwa biznesowa” i „Warstwa danych” są zwykle mentalnym szablonem modelu, a nie strukturą twojego repozytorium. Tak samo etykiety: jeśli węzeł nazywa się „moduł przetwarzania płatności”, a w kodzie jest to billing-worker, nikt nie skrzyżuje diagramu z projektem. A jeśli brakuje terminatora, czytelnik nie wie, czy przepływ kończy się tutaj, czy model urwał w połowie.
Dlaczego przegląd diagramu w tekście nie działa?
Ponieważ wady, które mają znaczenie, są topologiczne, a tekst ich nie ujawnia. Czytając listę linii A --> B, możesz sprawdzić, czy każda krawędź z osobna jest wiarygodna, ale nie zobaczysz, że dwie strzałki się krzyżują, że węzeł został osierocony, że hierarchia jest odwrócona ani że istnieje cykl o trzech skokach. Te właściwości są widoczne dopiero wtedy, gdy graf jest narysowany i rozmieszczony.
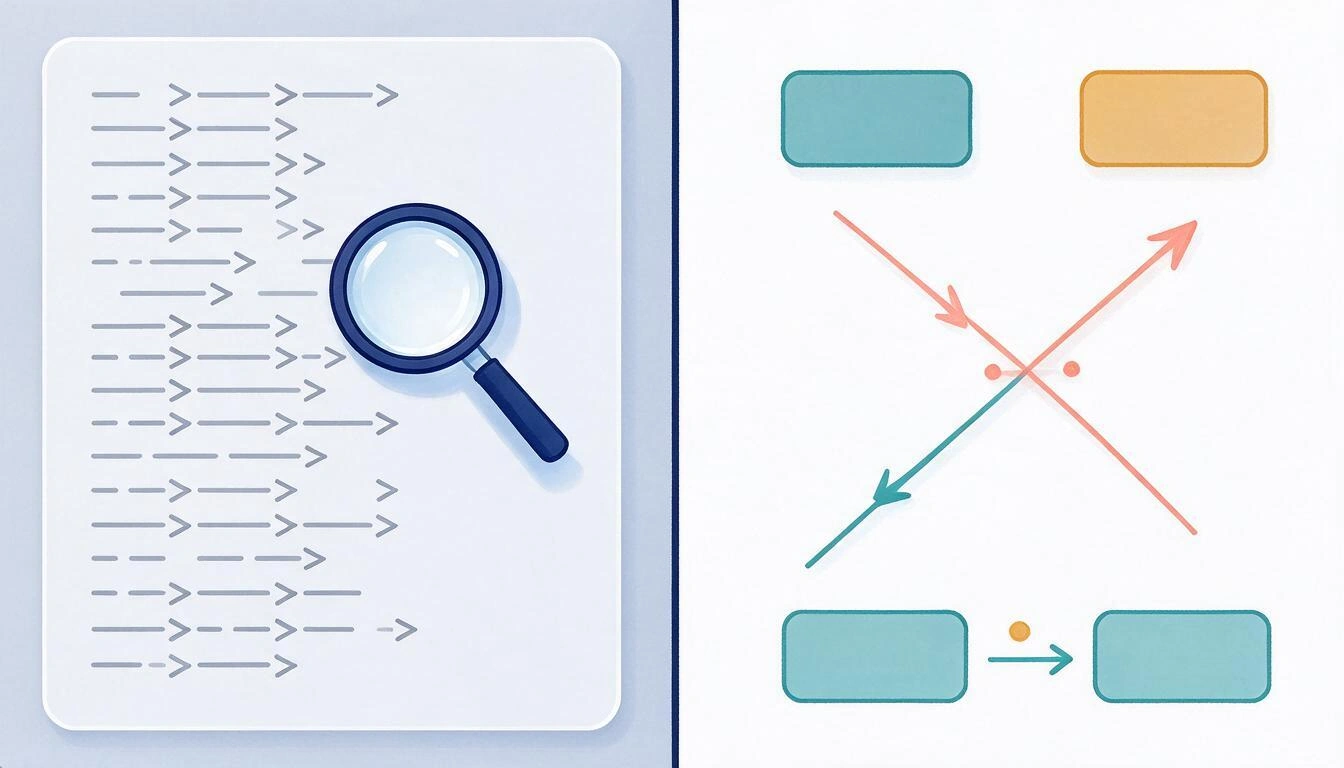
Jest też drugi, subtelniejszy powód: czytając .mmd, sprawdzasz to, co napisał autor; patrząc na render, sprawdzasz to, co zrozumie czytelnik. To różne rzeczy. Diagram z piętnastoma poprawnymi krawędziami i auto-layoutem, który je zagęszcza, jest technicznie dobry, a komunikacyjnie zepsuty, i to dokładnie ten, który recenzent pull requesta zatwierdza bez patrzenia, bo „blok mermaid jest poprawnie sformowany”.
Sama branża poszła w tę stronę. Anthropic uruchomił Claude Whiteboards w becie 10 listopada 2026: płótno w czasie rzeczywistym, na którym asystent zamienia dyskusję w tablicę, grupuje notatki tematycznie i pozwala potem przenieść całość do Lucid, Miro lub Vani od Zoho (unite.ai). A Miro na wydarzeniu Canvas 26 oświadczyło, że już „nie zajmuje się biznesem tablic” i chce być „warstwą wspólnego podejmowania decyzji dla przedsiębiorstwa agentowego” (Forrester, 1 czerwca 2026). Naturalnym wyjściem AI staje się płótno, a nie blok tekstu. Dla osoby audytującej diagramy to dobra wiadomość: przegląd należy do miejsca, w którym widać kształt.
Cykl przeglądu: od .mmd do płótna i z powrotem do .mmd
Cykl ma pięć kroków, a jego kluczową cechą jest to, że się zamyka: do repozytorium trafia diagram poprawiony na płótnie, a nie oryginał od agenta. Jeśli poprawka zostaje w zrzucie ekranu lub komentarzu do pull requesta, błędny .mmd przetrwa i znów nakarmi następnego agenta.
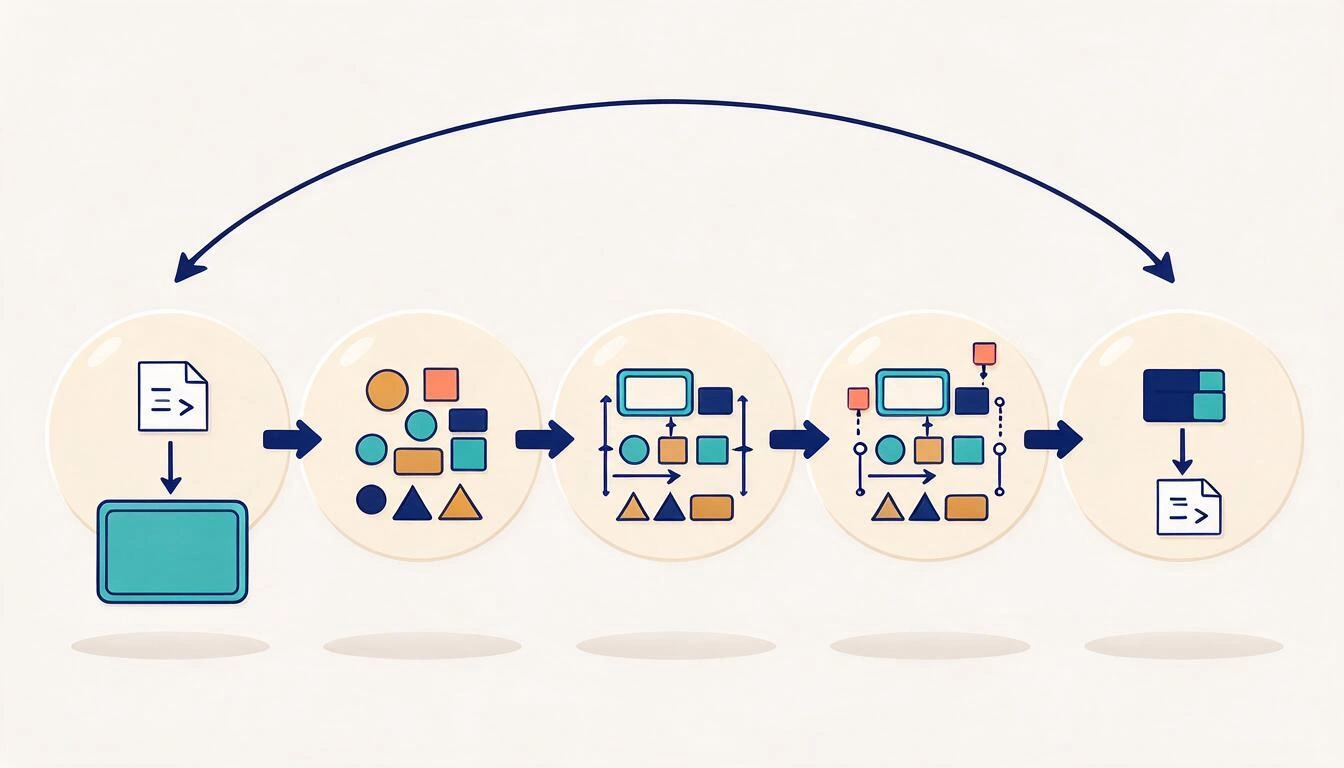
- Importuj. Wklej
.mmd, który dał ci agent, na wizualne płótno albo wczytaj go jako plik. Cel: oddzielić przegląd od edytora kodu, w którym kusi, żeby czytać zamiast patrzeć. - Rozłóż i uporządkuj. Ułóż węzły w poziomych warstwach według odpowiedzialności (wejście, orkiestracja, domena, magazyn). Prawie wszystkie wady kierunku i fałszywej głębi zdradzają się tutaj: strzałka, która idzie o dwie warstwy w górę, zwykle jest strzałką odwróconą.
- Oznacz wątpliwe. Każdy węzeł lub łącznik, którego nie możesz potwierdzić, czytając kod, opisujesz notatką, a notatka zawiera link do dowodu: plik, zgłoszenie, ADR. Zaudytowany diagram to nie diagram bez wątpliwości, tylko taki, w którym wątpliwości są oznaczone i prześledzone.
- Popraw ręcznie. Połącz zduplikowane węzły, rozbij pole generyczne na rzeczywiste magazyny, dodaj gałąź „nie”, zamknij terminatorem, zmień typ kształtu tak, by romb był rombem, a magazyn walcem, i zakotwicz łączniki w prawidłowych punktach.
- Wyeksportuj z powrotem. Zrzuć wynik do
.mmdi zastąp oryginalny plik w repozytorium, w tym samym commicie co przegląd. To krok, który większość zespołów pomija i który zapobiega ponownemu wprowadzeniu błędu.
W praktyce to krok 3 zamienia to w proces inżynierski, a nie w sesję składania. Boczna notatka z linkiem do konkretnego pliku, który dowodzi, że worker konsumuje z kolejki, jest weryfikowalną dokumentacją; „chyba ta strzałka jest odwrotnie” w wątku na Slacku już nie.
Lista kontrolna: 10 sprawdzeń przed merge’em diagramu wygenerowanego przez AI
Zamknięta lista, pomyślana do wklejenia w szablon pull requesta. Jeśli któreś sprawdzenie zawiedzie, diagram nie wchodzi.
- Unikalność: żaden rzeczywisty komponent nie występuje jako dwa węzły. Jedno ID na usługę, nazwa z repozytorium lub wdrożenia.
- Kompletne decyzje: każdy romb ma co najmniej dwie krawędzie wyjściowe, opisane, a gałąź błędu ma cel.
- Terminatory: każda ścieżka kończy się jawnym węzłem końcowym; nie ma łańcuchów urwanych na kroku procesu.
- Kierunek danych: każda strzałka biegnie w stronę, w którą podróżuje informacja, a nie zgodnie z hierarchią organizacyjną. Szczególnie sprawdź kolejki, webhooki i polling.
- Rozbite magazyny: żadnego generycznego pola typu „Baza danych”, „Usługi” czy „Infrastruktura”. Jeden węzeł na magazyn z technologią i zawartością.
- Prawdziwe warstwy: każdy
subgraphodpowiada granicy, która istnieje (wdrożenie, repozytorium, konto, sieć), a nie podręcznikowej abstrakcji. - Słownictwo domeny: etykiety używają nazw, które zespół pisze w kodzie i zgłoszeniach, a nie słów z twojego promptu.
- Bez sierot i zbędnych skrzyżowań: żaden węzeł nie jest odłączony, a pozostałe skrzyżowania są uzasadnione i nie da się ich usunąć przez przestawienie.
- Czytelny w rozmiarze publikacji: da się go zrozumieć w szerokości
READMElub portalu dokumentacji, a nie tylko po powiększeniu. - Identyfikowalność: każdy nieoczywisty element ma notatkę z linkiem do kodu, zgłoszenia lub ADR, który go potwierdza; a
.mmdw repozytorium jest tym wyeksportowanym po poprawce.
Spec-driven development: jeśli diagram jest błędny, kod dziedziczy błąd
To powód, dla którego audyt przestał być kosmetyczny w 2026 roku. W rozwoju sterowanym specyfikacją specyfikacja w Markdown — z diagramami Mermaid architektury i sekwencji — jest artefaktem, z którego agent generuje implementację, a nie komentarzem do niej. Niepoprawny diagram w takiej specyfikacji nie jest już nieaktualną dokumentacją: to wadliwe dane wejściowe generatora kodu.
Podejście to opisuje Spec Kit od GitHuba, którego teza brzmi: „specyfikacje nie służą kodowi; kod służy specyfikacjom”, a produkowane przez niego plany implementacji zawierają diagramy architektury i sekwencji w Mermaid obok modelu danych i trybów awarii.
W codziennej praktyce: romb bez gałęzi „nie” w specyfikacji to z dużym prawdopodobieństwem nieimplementowany przypadek błędu w wygenerowanym kodzie. Odwrócona strzałka między API a kolejką to projekt push tam, gdzie chciałeś pull. A pole „Baza danych”, które przykrywało Postgres, Redis i S3, staje się jednym repozytorium z trzema odpowiedzialnościami. Diagram przestał być zdjęciem systemu, a stał się częścią planu, a plany się sprawdza.
Najczęstsze pytania
Co oznacza „Mermaid slop”?
To diagram wygenerowany przez AI z poprawną składnią Mermaid, ale bez wartości komunikacyjnej: generyczne i identyczne kształty, domyślna paleta, źle opisane strzałki, a w najgorszych przypadkach komponenty lub relacje, które nie istnieją w systemie. Termin upowszechnił się dzięki projektowi Diagram Design i dokumentuje go przegląd explainX z sierpnia 2026.
Czy można automatycznie zweryfikować diagram Mermaid wygenerowany przez AI?
Tylko częściowo. Linter lub sam parser wykrywa błędy składni i można zautomatyzować sprawdzenia strukturalne: osierocone węzły, romby z jednym wyjściem, ścieżki bez terminatora albo ID z podejrzanie podobnymi etykietami. Czego żadne narzędzie nie zweryfikuje samo, to czy diagram opisuje twój system; to wymaga skonfrontowania go z kodem, dlatego lista kontrolna z tego artykułu łączy sprawdzenia możliwe do zautomatyzowania z przeglądem ludzkim.
Dlaczego nie wystarczy przejrzeć bloku mermaid w pull requeście?
Bo w diffie czytasz krawędzie jedna po drugiej, a istotne wady dotyczą całego grafu: skrzyżowań, odwróconych hierarchii, cykli, odizolowanych węzłów, nieczytelnej gęstości. Poza tym czytając tekst, oceniasz intencję autora, a nie to, co zobaczy czytelnik renderu. Przydatny przegląd robi się na narysowanym diagramie.
Jakiego narzędzia użyć do ręcznego poprawiania diagramu Mermaid?
Potrzebujesz płótna, które obsłuży całą drogę: zaimportować .mmd, pozwolić przesuwać i zmieniać kształty oraz łączniki, opisywać elementy i eksportować z powrotem do Mermaid. Ten ostatni krok odrzuca większość przeglądarek, które renderują, ale nie zwracają poprawionego kodu. FlowBoard obejmuje cały cykl: importuje Mermaid z pliku lub przez wklejenie kodu, rozkłada diagram na nieskończonym płótnie z powiększaniem i przesuwaniem, pozwala ręcznie poprawiać kształty, łączniki i zakotwiczenia z przyciąganiem do punktów kotwiczenia, dodawać boczne notatki z linkami do poszczególnych elementów i eksportować z powrotem do Mermaid.
Ile trwa audyt diagramu wygenerowanego przez AI?
To zależy od rozmiaru, ale rząd wielkości dla diagramu z 15-25 węzłami to 20-40 minut za pierwszym razem, a znacznie mniej, gdy zespół ma już opanowaną listę kontrolną i ustalone nazwy domeny. W porównaniu z kosztem tego, że błędna architektura trafi do oficjalnej dokumentacji — albo, w przepływie sterowanym specyfikacją, do wygenerowanego kodu — jest tanio.
Czy trzeba przestać używać AI do robienia diagramów?
Nie. Wygenerowanie pierwszego szkicu przez agenta oszczędza żmudnej pracy przy wpisywaniu węzłów i krawędzi, a do poznawania nieznanego systemu jest przydatne. Nie wolno tylko pomijać kolejnego kroku: żaden diagram wygenerowany przez AI nie jest publikowany bez przejścia przez płótno i listę kontrolną. AI robi szkic; odpowiedzialność za diagram nadal ponosi zespół, który go podpisuje.
Podsumowanie: diagram, który publikujesz, to ten, który zaudytowałeś
Zmiana roku 2026 nie polega na tym, że AI rysuje diagramy, tylko na tym, że rysuje je szybciej, niż je sprawdzamy. Dopóki VS Code rysuje je bez konfiguracji, Claude zamienia je w tablice, a specyfikacje w Markdown zasilają generatory kodu, jedyną pozostałą kontrolą jakości jest kontrola ludzka: spojrzeć na kształt, oznaczyć to, czego nie da się udowodnić, i zwrócić do repozytorium poprawioną wersję. Dziesięć sprawdzeń i cykl, który się zamyka, wystarczą, by diagram znów był wiarygodną dokumentacją, a nie wiarygodnie wyglądającą dekoracją.
Ten cykl potrzebuje miejsca, w którym może się odbyć. W AIsToHire rozwiązujemy to za pomocą FlowBoard, naszej nieskończonej tablicy do diagramów: wkleja się lub importuje .mmd od agenta, rozkłada go na nieskończonym canvasie, przestawia kształty — prostokąty, elipsy, romby decyzyjne, dokumenty, karteczki samoprzylepne i tekst — oraz łączniki z prostymi lub ortogonalnymi strzałkami, kotwiczy każde połączenie z przyciąganiem do punktów elementów, opisuje wątpliwości bocznymi notatkami i linkami weryfikacyjnymi i eksportuje z powrotem do Mermaid. Tablica zapisuje się sama, więc audyt zostaje zarejestrowany i można do niego wrócić.
Otwórz FlowBoard, wklej plik .mmd, który dał ci agent, i zaudytuj diagram tam, gdzie naprawdę go widać: uporządkuj warstwami, popraw kształty i łączniki ręcznie, opisz to, co budzi wątpliwości, linkami weryfikującymi i wyeksportuj z powrotem do Mermaid. Zacznij swoją pierwszą tablicę za darmo.
Otwórz FlowBoard, wklej plik .mmd, który dał ci agent, i zaudytuj diagram tam, gdzie naprawdę go widać: uporządkuj warstwami, popraw kształty i łączniki ręcznie, opisz to, co budzi wątpliwości, linkami weryfikującymi i wyeksportuj z powrotem do Mermaid. Zacznij swoją pierwszą tablicę za darmo.Czytaj dalej
Zobacz wszystkie artykuły →
Symbole schematu blokowego: co oznacza każdy z nich i jak narysować własny krok po kroku

Kłótnia na WhatsAppie czy rozmowa na żywo: co mówi nauka o konfliktach w parze przez wiadomości

Mapa myśli, mapa pojęć i konspekt: różnice i kiedy używać każdego z nich
