 FlowBoard
Mermaid slop:發布前,如何檢查並修正 AI 為你生成的圖表
团队: FlowBoard在 AI 协助下撰写13 分鐘閱讀重點摘要:
- 「Mermaid slop」是 2026年流行起來的名稱,指的是 AI 生成、語法有效但難以閱讀或根本不實的圖表;這個詞出自 Diagram Design 專案,其口號是「no Figma, no generic rounded boxes, no Mermaid-slop」,到 2026年8月,該專案在 GitHub 上已超過 11,000 顆星(explainX,2026年8月16日)。
- 這個問題隨著散布而擴大:VS Code 1.121(2026年5月20日)在 Markdown 預覽中原生算圖 Mermaid,不需要擴充功能,而且助理預設就會生成它(Visual Studio Code)。
- 模型最佳化的是語法有效性,而不是系統的正確性:
.mmd能解析,卻會重複節點、漏掉決策的「否」分支,或把資料的方向弄反。 - 逐行閱讀
-->來檢查圖表是行不通的:真正重要的缺陷是拓樸上的,只有畫出來才看得見。 - 真正有效的循環:把
.mmd匯入畫布、依層次重新排列、用指向程式碼或證明它的工單的連結標註可疑之處、手動修正,並重新匯出,讓進入儲存庫的是修正後的版本。
自 2026年中起,工程團隊的問題已經不再是如何生成圖表,而是誰要為它負責。代理程式隨手寫出 Mermaid,GitHub 和 VS Code 不用設定就能繪出,結果就像程式碼區塊一樣自然地進入 README。缺少的是稽核這一層。本文介紹典型的缺陷、它們出現的技術原因,以及一個可重現的審查循環,並在視覺畫布上完成這個循環:我們使用的是 FlowBoard,AIsToHire 的無限白板圖表工具,它能匯入並重新匯出 Mermaid,讓發布的是修正後的圖表,而不是模型吐出的第一版。
「Mermaid slop」究竟是什麼?
Mermaid slop 是 AI 生成的圖表:編譯時沒有錯誤,卻依然沒用:不同概念用一模一樣的圓角方塊、沒有標籤或標籤含糊的箭頭、毫無意義的預設顏色,以及反射性的生成(畫它只是因為有人要求,而不是因為需要)。這個定義出自 explainX 對這個詞的回顧(2026年8月16日),它將這個詞追溯到凱瑟琳·拉弗里(Cathryn Lavery)的 Diagram Design 專案。
重要的細微差別在於,「slop」有兩層,而且常被混為一談:
| 層次 | 哪裡出問題 | 如何察覺 | 修正成本 |
|---|---|---|---|
| 美學 | 通用的形狀、預設色盤、一切都一樣 | 一眼就看得出 | 低:主題、形狀、分組 |
| 語意 | 圖表描述的是一個不存在的系統 | 只有對照實際程式碼才能發現 | 高:必須重新打開儲存庫 |
2026年的公開討論,幾乎都集中在第一層。已經出現的工具,從編輯式製圖的 skills,到產生 Excalidraw 原生元素而非 Mermaid 文字的生成器,攻克的主要是外觀。第二層,也就是讓圖表對你的架構說謊的那一層,仍然是人的工作。
為什麼 LLM 產生的 Mermaid 語法完美,語意卻很差?
因為這是兩個不同的目標,而且只有一個有大量的訓練訊號。Mermaid 的文法是封閉、小巧的,而且在 GitHub 上大量存在:模型幾乎不會出錯地重現它。但圖表的正確性,取決於某個具體系統,而模型通常並沒有讀完整個系統,所以它用架構圖最常見的樣子來填補空缺,而不是用你的樣子。
再加上三種實際效應:
- 提示詞是唯一的來源。 如果你用三句話描述系統,代理程式就會回傳顆粒度只有三句話的圖表,並加以裝飾,直到看起來完整為止。正如 Mermaid 自己在談到 vibe diagramming 時所總結:「由含糊提示詞生成的圖表,會反映出提示詞的含糊」(Mermaid,2026年3月24日)。
- 沒有語意編譯器。 紅燈的測試會警告你;不正確的圖表算圖出來,和正確的一樣漂亮。沒有針對「這個服務不存在」的
tsc對應物。 - 版面由引擎決定,不是作者。 Mermaid 用自己的演算法放置節點,並不提供在算圖後方便修正配置的方法。如果真實的階層和自動版面畫出來的不一致,你就是爭不過工具。
而業界的脈絡顯示,驗證不是可有可無的。Stack Overflow 2026年開發者調查(2026年10月6日發布,來自 169 個國家、超過 30,000 份回覆)發現,近一半的人只在能輕易驗證時才信任 AI 的輸出,而僅有 6.6% 的人會把它視為重大決策的依據。官方文件中的架構圖,幾乎可以說就是一項重大決策。
AI 生成圖表的七個常見缺陷
這是在稽核代理程式生成的 .mmd 時一再出現的七個缺陷。全都能解析;全都是錯的。共通的模式是,模型在缺少領域資訊的地方,填入看似合理的結構。
| # | 缺陷 | .mmd 中的症狀 | 後果 |
|---|---|---|---|
| 1 | 重複的節點 | 兩個不同的 ID,標籤相似,卻是同一個服務 | 明明只有一個元件,看起來卻像有兩個 |
| 2 | 決策沒有「否」分支 | 菱形只有一條出邊 | 錯誤路徑沒有記錄 |
| 3 | 流程沒有終止點 | 鏈條終止在處理節點上 | 不知道這個使用情境何時結束 |
| 4 | 方向顛倒 | 箭頭指向資料的來源 | 誰呼叫誰被倒轉了 |
| 5 | 通用方塊 | 單一個「資料庫」節點 | 隱藏了三個保證各不相同的儲存區 |
| 6 | 虛假的深度 | 程式碼中並不存在的層次或 subgraph | 讓虛構的架構顯得有權威 |
| 7 | 提示詞的標籤 | 節點重複你的用詞,而不是領域的詞彙 | 圖表無法搜尋,也無從辨識 |
1. 重複的節點,其實是同一個服務
模型在兩個不同的句子中看到「auth」和「認證服務」,就建立了兩個節點。
flowchart LR
  API[API Gateway] --> AUTH[Auth]
  API --> AUTHSVC[認證服務]
  AUTH --> DB[(資料庫)]
  AUTHSVC --> DB
修正後:一個節點、一個 ID、團隊使用的名稱。
flowchart LR
  API[API Gateway] --> AUTH[auth-service]
  AUTH --> USERS[(postgres: users)]
2. 沒有「否」分支的決策
flowchart TD
  REQ[請求] --> Q{Token 有效?}
  Q -->|是| OK[處理]
只有一個出口的菱形不是決策,而是裝飾。每個條件都需要兩條路徑,錯誤路徑也需要有目的地。
flowchart TD
  REQ[請求] --> Q{Token 有效?}
  Q -->|是| OK[處理]
  Q -->|否| R401[回應 401]
  OK --> FIN([結束])
  R401 --> FIN
3. 顛倒資料方向的箭頭
佇列和 webhook 的經典問題:模型畫的是組織階層,而不是真實的流向。
flowchart LR
  WORKER[Worker] --> QUEUE[工作佇列]
Worker 不是推送到佇列:而是從佇列消費。把這個方向畫錯,就會把 pull 設計變成 push 設計,那是另一個系統,保證也不同。
flowchart LR
  API[API] -->|加入佇列| QUEUE[工作佇列]
  QUEUE -->|消費| WORKER[Worker]
4. 通用方塊「資料庫」
這是代價最高的缺陷,因為消失的,正是有人打開圖表想找的資訊。一個 [(資料庫)] 節點,實際上是用於交易的 Postgres、用於工作階段的 Redis,以及用於附件的 S3,這不是在記錄,而是在隱藏。實用的規則:如果兩個儲存區的持久性保證不同,就是兩個節點。
5、6 和 7:虛構的層次與借來的標籤
名為「展示層」、「業務層」和「資料層」的 subgraph,往往是模型腦中的範本,而不是你的儲存庫結構。標籤也是一樣:如果節點叫「付款處理模組」,而程式碼裡是 billing-worker,就沒有人能把圖表和專案對上。如果缺少終止點,讀者就不知道流程是到此為止,還是模型只做了一半。
為什麼以文字來檢查圖表行不通?
因為重要的缺陷是拓樸上的,文字顯示不出來。閱讀一串 A --> B 的行,你可以逐條驗證每條邊是否合理,但你看不出兩支箭頭交叉、有個節點變成孤兒、階層被顛倒,或是存在一個三跳的循環。這些性質只有在圖被畫出來並放置好時才看得見。
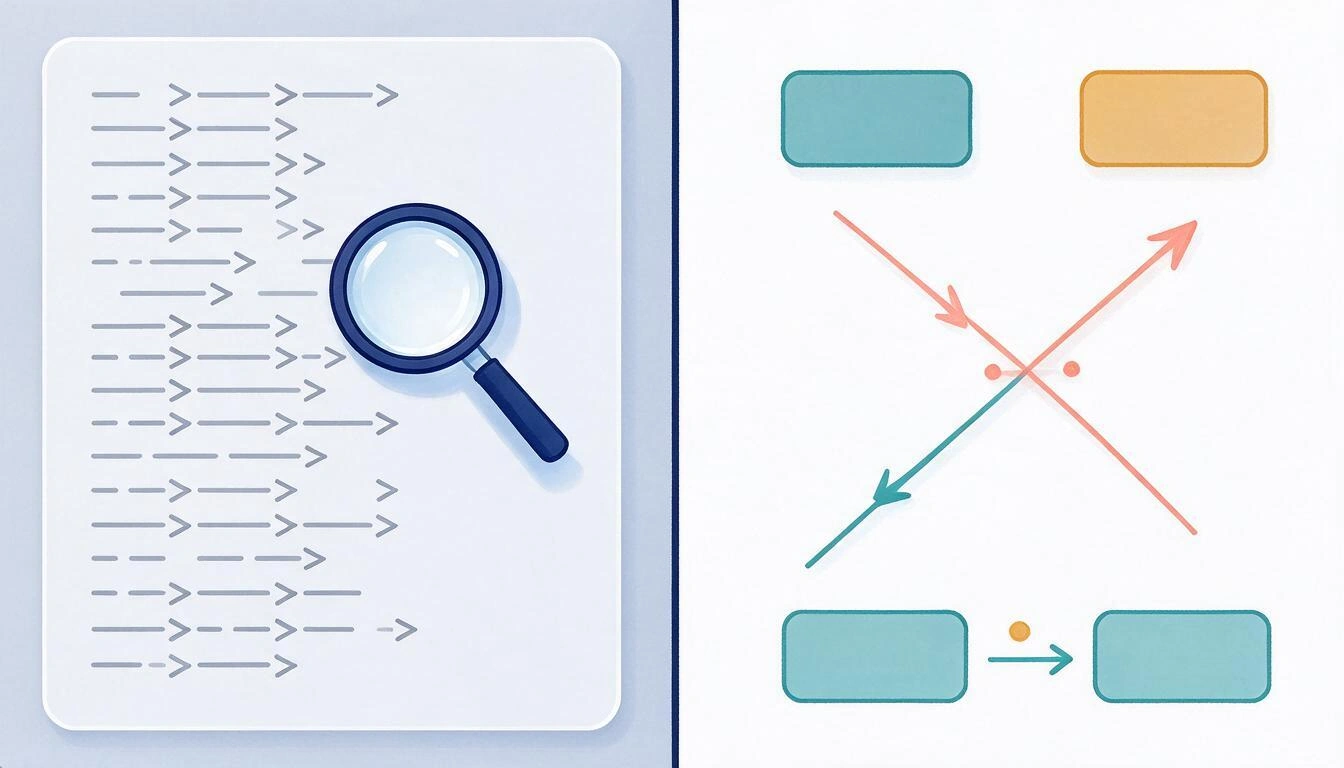
還有第二個更微妙的原因:閱讀 .mmd 時,你檢查的是作者寫了什麼;查看算圖結果時,你檢查的是讀者會理解什麼。這是兩回事。一張有十五條正確的邊、卻被自動版面擠成一團的圖表,技術上沒有問題,溝通上卻是壞的,而這正是 pull request 審查者看都不看就核准的東西,因為「mermaid 區塊格式正確」。
業界本身也朝這個方向移動。Anthropic 於 2026年11月10日推出了 Claude Whiteboards 測試版:這是一塊即時畫布,助理能把一場討論變成看板,依主題分組便條,之後還能帶到 Lucid、Miro 或 Zoho 的 Vani(unite.ai)。而 Miro 在 Canvas 26 活動上宣布,它已「不再做白板生意」,並希望成為「代理式企業的協作決策層」(Forrester,2026年6月1日)。AI 自然而然的輸出,正在變成畫布,而不是文字區塊。對於稽核圖表的人來說,這是好消息:審查屬於看得見形狀的地方。
審查循環:從 .mmd 到畫布,再回到 .mmd
這個循環有五個步驟,它的關鍵特性是會閉合:進入儲存庫的,是在畫布上修正過的圖表,而不是代理程式的原稿。如果修正只停留在螢幕截圖或 pull request 的留言裡,錯誤的 .mmd 就會存活下來,並再次餵給下一個代理程式。
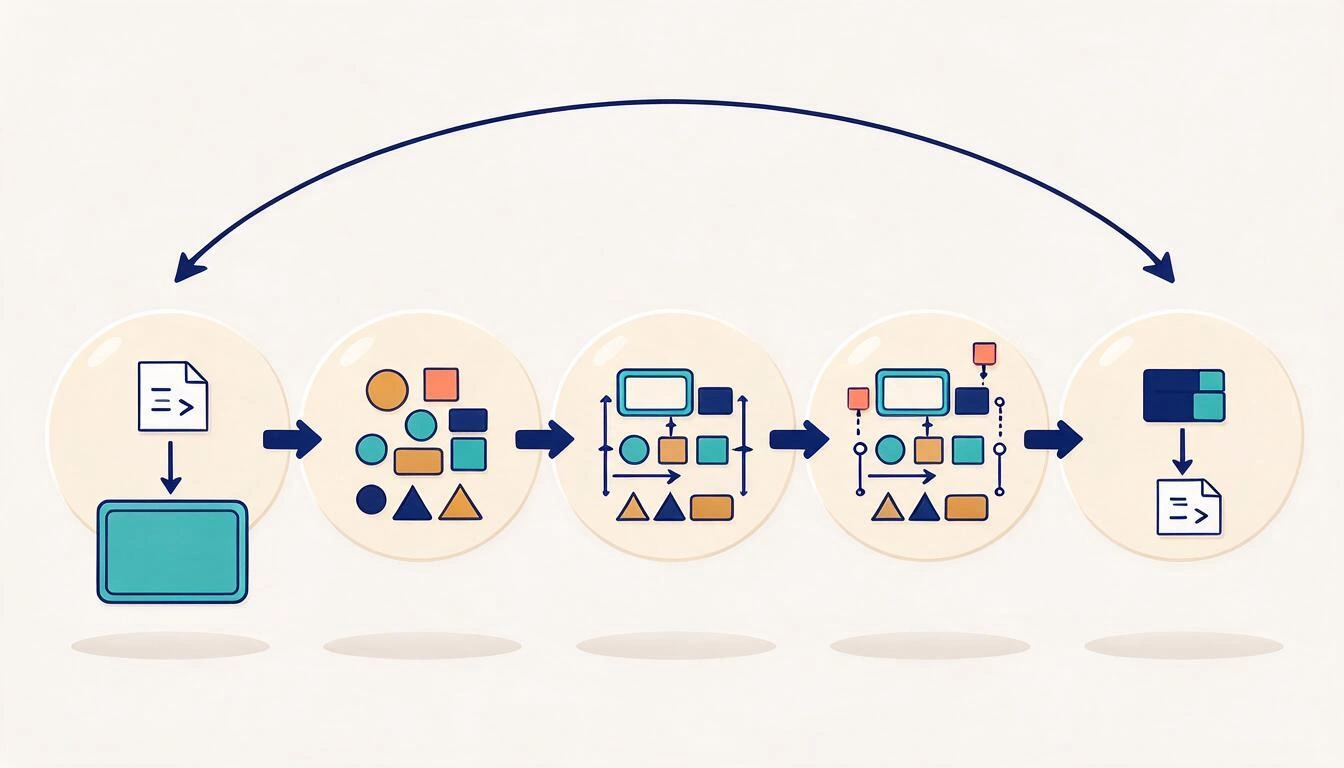
- 匯入。 把代理程式給你的
.mmd貼到視覺畫布上,或當作檔案載入。目的:把審查從程式碼編輯器中分離出來,因為在那裡人會忍不住用讀的,而不是用看的。 - 展開並重新排列。 依職責把節點放在水平的層次中(入口、協調、領域、儲存)。幾乎所有方向和虛假深度的缺陷,都會在這裡露餡:往上跨兩層的箭頭,通常就是一支顛倒的箭頭。
- 標記可疑之處。 每個你無法透過閱讀程式碼確認的節點或連接線,都要加上標註,而標註要附上證明的連結:檔案、工單、ADR。經過稽核的圖表不是沒有疑問的圖表,而是疑問都被標示並可追溯的圖表。
- 手動修正。 合併重複的節點、把通用方塊拆成真實的儲存區、補上「否」分支、以終止點收尾、更換形狀類型讓菱形是菱形、儲存區是圓柱,並把連接線重新錨定到正確的點上。
- 匯出回去。 把結果輸出為
.mmd,並在與審查相同的 commit 中,取代儲存庫裡的原始檔案。這是大多數團隊會略過的步驟,也是避免錯誤重新引入的關鍵。
實際上,第 3 步才是讓這件事成為工程流程,而不是排版作業的關鍵。一則附帶具體檔案連結、證明 worker 是從佇列消費的側邊註記,是可驗證的文件;而 Slack 討論串裡的「我覺得這支箭頭是反的」,就不是。
檢查清單:合併 AI 生成圖表前的 10 項確認
封閉式清單,專為貼進 pull request 範本而設計。只要有一項不通過,圖表就不能合併。
- 唯一性:沒有任何真實元件以兩個節點出現。每個服務一個 ID,使用儲存庫或部署中的名稱。
- 決策完整:每個菱形至少有兩條有標籤的出邊,而且錯誤分支有目的地。
- 終止點:每條路徑都以明確的終端節點結束;沒有在處理步驟上中斷的鏈條。
- 資料方向:每支箭頭都朝資訊流動的方向,而不是組織階層的方向。特別檢查佇列、webhook 和 polling。
- 儲存區拆開:沒有「資料庫」、「服務」或「基礎設施」這種通用方塊。每個儲存區一個節點,並標明技術和內容。
- 真實的層次:每個
subgraph都對應一個確實存在的邊界(一個部署、一個儲存庫、一個帳號、一個網路),而不是教科書上的抽象概念。 - 領域詞彙:標籤使用團隊在程式碼和工單中寫的名稱,而不是你提示詞中的用語。
- 沒有孤兒,也沒有可避免的交叉:沒有斷開的節點,剩下的交叉都有理由,而且無法靠重新排列來解決。
- 在發布尺寸下可讀:在
README或文件入口網站的寬度下看得懂,而不只是放大後才看得懂。 - 可追溯:每個不明顯的元素都有附上連結的註記,指向支持它的程式碼、工單或 ADR;而且儲存庫中的
.mmd是修正後匯出的版本。
規格驅動開發:如果圖表是錯的,程式碼就會繼承這個錯誤
這就是為什麼稽核在 2026年不再只是表面功夫。在規格驅動開發中,Markdown 規格,連同其中的 Mermaid 架構圖和時序圖,是代理程式用來生成實作的產物,而不是對實作的註解。這份規格中不正確的圖表,不再只是過時的文件:它是程式碼生成器的有缺陷輸入。
這個做法記錄在 GitHub 的 Spec Kit 中,其主張是「規格不為程式碼服務;程式碼為規格服務」,而它所產生的實作計畫,包含 Mermaid 的架構圖和時序圖,以及資料模型和失敗模式。
換成日常的說法:規格中沒有「否」分支的菱形,很可能就是生成的程式碼裡沒有實作的錯誤情況。API 與佇列之間顛倒的箭頭,是你想要 pull 卻得到 push 的設計。而遮住 Postgres、Redis 和 S3 的「資料庫」方塊,會變成一個承擔三種職責的單一儲存庫。圖表已經從系統的照片,變成藍圖的一部分,而藍圖是要審查的。
常見問題
「Mermaid slop」是什麼意思?
這是指 AI 生成、Mermaid 語法有效卻沒有溝通價值的圖表:通用而一模一樣的形狀、預設色盤、標籤不當的箭頭,最糟的情況下,還有系統中不存在的元件或關係。這個詞從 Diagram Design 專案開始流行,並記錄在 2026年8月 explainX 的回顧中。
可以自動驗證 AI 生成的 Mermaid 圖表嗎?
只能部分做到。linter 或解析器本身可以偵測語法錯誤,也可以將結構檢查自動化:孤立節點、只有一個出口的菱形、沒有終止點的路徑,或是標籤可疑地相似的 ID。但沒有任何工具能單獨驗證圖表是否描述了你的系統;這需要對照程式碼,因此本文的檢查清單把可自動化的檢查與人工審查混合在一起。
為什麼在 pull request 中檢查 mermaid 區塊還不夠?
因為在 diff 中你是一條一條讀邊,而重要的缺陷屬於整個圖:交叉、顛倒的階層、循環、孤立的節點、無法閱讀的密度。此外,閱讀文字時你評估的是作者的意圖,而不是算圖後讀者會看到的樣子。有用的審查,要在畫出來的圖表上進行。
我該用什麼工具來手動修正 Mermaid 圖表?
你需要一塊能走完整趟旅程的畫布:匯入 .mmd、讓你移動並更改形狀與連接線、標註元素,再匯出回 Mermaid。最後一步,正是大多數檢視器所缺少的,它們只會算圖,卻不會把修正後的程式碼交還給你。FlowBoard 涵蓋了整個循環:可從檔案或貼上程式碼匯入 Mermaid,在支援縮放和平移的無限畫布上展開圖表,可手動修正形狀、連接線和錨點,並對錨點具有磁吸功能,可為每個元素加上附連結的側邊註記,並匯出回 Mermaid。
稽核一張 AI 生成的圖表需要多久?
視大小而定,但對一張 15 至 25 個節點的圖表,第一次大約需要 20 到 40 分鐘,等團隊已經內化了檢查清單、並固定了領域名稱,就會少得多。比起錯誤的架構進入官方文件(或在規格驅動的流程中,進入生成的程式碼)所付出的代價,這很便宜。
要停止使用 AI 來製作圖表嗎?
不需要。用代理程式生成第一份草稿,省下了輸入節點和邊這種乏味的工作,對探索不熟悉的系統也很有用。不該略過的是接下來的一步:任何 AI 生成的圖表,沒有經過畫布和檢查清單,都不應發布。AI 負責草稿;圖表的責任,仍然屬於簽核它的團隊。
結語:你發布的,是你稽核過的圖表
2026年的轉變,並不是 AI 會畫圖表,而是它畫得比我們審查得更快。當 VS Code 不用設定就能繪出、Claude 把它們變成看板,而 Markdown 規格又在餵養程式碼生成器時,剩下唯一的品質管控就是人:查看形狀、標記無法證明的部分,並把修正後的版本交還給儲存庫。十項檢查加上一個會閉合的循環,就足以讓圖表重新成為可靠的文件,而不是看似合理的裝飾。
這個循環需要一個發生的地方。在 AIsToHire,我們以 FlowBoard,我們的無限白板圖表工具來解決:貼上或匯入代理程式的 .mmd,在無限畫布上展開,重新安排形狀(矩形、橢圓、決策菱形、文件、便利貼和文字),以及用直線或正交箭頭的連接線,用磁吸把每條連線錨定到元素的點上,用側邊註記和驗證連結標註可疑之處,再匯出回 Mermaid。看板會自動儲存,所以稽核留有紀錄,並且可以繼續進行。
開啟 FlowBoard,貼上代理程式給你的 .mmd,在真正看得見的地方審查圖表:依層次重新排列、手動修正形狀和連接線、用查證連結標註可疑之處,再匯出回 Mermaid。免費開始你的第一個看板。
開啟 FlowBoard,貼上代理程式給你的 .mmd,在真正看得見的地方審查圖表:依層次重新排列、手動修正形狀和連接線、用查證連結標註可疑之處,再匯出回 Mermaid。免費開始你的第一個看板。