 FlowBoard
Mermaid slop: איך בודקים ומתקנים את הדיאגרמות שהבינה המלאכותית יוצרת לך לפני שמפרסמים אותן
הצוות של FlowBoardנכתב בעזרת בינה מלאכותית12 דקות קריאהבקצרה:
- "Mermaid slop" הוא השם שהתפשט ב־2026 לדיאגרמות שנוצרו בבינה מלאכותית ותקינות מבחינת תחביר אך בלתי קריאות או שקריות ממש; המונח יצא מהפרויקט Diagram Design, שהציג את עצמו בסיסמה "no Figma, no generic rounded boxes, no Mermaid-slop" וכבר עבר את 11,000 הכוכבים ב־GitHub באוגוסט 2026 (explainX, 16-08-2026).
- הבעיה גדלה עם ההפצה: VS Code 1,121 (20-05-2026) מרנדר Mermaid באופן מובנה בתצוגה המקדימה של Markdown, בלי תוסף, והעוזרים מייצרים אותו כברירת מחדל (Visual Studio Code).
- מודל ממטב תקינות דקדוקית, לא נכונות המערכת: קובץ ה־
.mmdעובר פענוח, אבל מכפיל צמתים, מדלג על הענף "לא" של החלטה או הופך את כיוון הנתון. - בדיקת דיאגרמה בקריאת שורות של
-->לא עובדת: הפגמים החשובים הם טופולוגיים ונראים רק כשהדיאגרמה מצוירת. - המחזור שכן עובד: לייבא את ה־
.mmdללוח עבודה, לסדר בשכבות, לסמן את המפוקפק בקישור לקוד או לטיקט שמוכיח אותו, לתקן ביד ולייצא מחדש כך שהגרסה המתוקנת היא זו שנכנסת למאגר.
מאמצע 2026, השאלה בצוותי הנדסה כבר אינה איך מייצרים דיאגרמה, אלא מי אחראי עליה. סוכנים כותבים Mermaid תוך כדי תנועה, GitHub ו־VS Code מציירים אותו בלי הגדרות והתוצאה נכנסת ל־README באותה טבעיות שבה נכנס בלוק קוד. מה שחסר הוא שכבת הביקורת. המאמר הזה עובר על הפגמים האופייניים, על הסיבה הטכנית להופעתם ועל מחזור בדיקה שניתן לשחזר ונסגר בלוח עבודה חזותי, במקרה שלנו FlowBoard, הלוח האינסופי לדיאגרמות של AIsToHire, שמייבא ומייצא מחדש Mermaid, כדי שהדיאגרמה שמתפרסמת תהיה המתוקנת ולא הראשונה שהמודל פלט.
מהו בדיוק "Mermaid slop"?
Mermaid slop הוא דיאגרמה שנוצרה בבינה מלאכותית שמתקמפלת בלי שגיאות ובכל זאת לא שימושית: קופסאות מעוגלות זהות למושגים שונים, חיצים בלי תווית או עם תוויות מעורפלות, צבעי ברירת מחדל שלא אומרים כלום ויצירה רפלקסיבית, מציירים כי ביקשו, לא כי יש צורך. ההגדרה נקבעת בסקירה של explainX על המונח (16-08-2026), שמתחקה אחריו עד הפרויקט Diagram Design של Cathryn Lavery.
הניואנס החשוב הוא שיש שתי שכבות של "slop" ולעיתים קרובות מבלבלים ביניהן:
| שכבה | מה נכשל | איך מזהים | עלות התיקון |
|---|---|---|---|
| אסתטית | צורות גנריות, פלטת ברירת מחדל, הכול זהה | במבט ראשון | נמוכה: ערכת נושא, צורות, קיבוץ |
| סמנטית | הדיאגרמה מתארת מערכת שלא קיימת | רק בהשוואה לקוד האמיתי | גבוהה: צריך לפתוח מחדש את המאגר |
השיחה הציבורית של 2026 התמקדה כמעט כולה בראשונה. הכלים שהופיעו, מה־skills של דיאגרמות עריכתיות ועד מחוללים שמפיקים רכיבי Excalidraw מקוריים במקום טקסט Mermaid, תוקפים בעיקר את המראה. השכבה השנייה, זו שגורמת לדיאגרמה לשקר לגבי הארכיטקטורה שלך, נשארת עבודה אנושית.
למה מודל שפה מפיק Mermaid מושלם בתחביר ודל בסמנטיקה?
כי אלה שתי מטרות שונות ורק לאחת מהן יש אות אימון בשפע. הדקדוק של Mermaid סגור, קטן ומיוצג בהיקף עצום ב־GitHub: מודל משחזר אותו כמעט בלי טעויות. נכונות הדיאגרמה, לעומת זאת, תלויה במערכת מסוימת שהמודל בדרך כלל לא קרא במלואה, ולכן הוא ממלא את החסר בצורה הנפוצה ביותר של דיאגרמת ארכיטקטורה, לא בשלך.
לכך מצטרפות שלוש השפעות מעשיות:
- הפרומפט הוא המקור היחיד. אם תיארת את המערכת בשלושה משפטים, הסוכן מחזיר דיאגרמה ברזולוציה של שלושה משפטים ומקשט אותה עד שנראית שלמה. כפי ש־Mermaid עצמה מסכמת כשהיא מדברת על vibe diagramming, "דיאגרמה שנוצרה מפרומפט מעורפל תשקף את העמימות של הפרומפט" (Mermaid, 24-03-2026).
- אין קומפיילר סמנטי. טסט אדום מתריע; דיאגרמה שגויה מרונדרת יפה בדיוק כמו נכונה. אין מקבילה של
tscל"השירות הזה לא קיים". - הפריסה נקבעת על ידי המנוע, לא על ידי הכותב. Mermaid ממקמת את הצמתים לפי האלגוריתם שלה ואינה מציעה דרך נוחה לתקן את הסידור אחרי הרינדור. אם ההיררכיה האמיתית לא תואמת את מה שהפריסה האוטומטית מציירת, מפסידים בוויכוח עם הכלי.
והקשר התעשייה אומר שאימות הוא לא אופציונלי. הסקר המפתחים 2026 של Stack Overflow (פורסם ב־06-10-2026, יותר מ־30,000 תשובות ב־169 מדינות) מצא שכמחצית סומכים על פלט הבינה המלאכותית רק כשהם יכולים לאמת אותו בקלות, ושרק 6.6% יקבלו אותו כמות שהוא להחלטות חשובות. דיאגרמת ארכיטקטורה בתיעוד הרשמי היא, כמעט בהגדרה, החלטה חשובה.
שבעת הפגמים החוזרים בדיאגרמה שנוצרה בבינה מלאכותית
אלה השבעה שמופיעים שוב ושוב בביקורת של קובצי .mmd שנוצרו על ידי סוכנים. כולם עוברים פענוח; כולם שגויים. הדפוס המשותף הוא שהמודל ממלא מבנה סביר היכן שחסר לו מידע על התחום.
| # | פגם | סימפטום ב־.mmd | תוצאה |
|---|---|---|---|
| 1 | צמתים כפולים | שני מזהים שונים עם תוויות דומות לאותו שירות | נראה שיש שני רכיבים איפה שיש אחד |
| 2 | החלטה בלי ענף "לא" | מעוין עם צלע יוצאת אחת | נתיב השגיאה נשאר לא מתועד |
| 3 | זרימה בלי סיום | שרשראות שנגמרות בצומת תהליך | לא ברור מתי מסתיים תרחיש השימוש |
| 4 | כיוון הפוך | החץ מצביע על מקור הנתון | הופך מי קורא למי |
| 5 | קופסה גנרית | צומת יחיד "מסד נתונים" | מסתיר שלושה מאגרים עם ערבויות שונות |
| 6 | עומק מזויף | שכבות או subgraph שלא קיימים בקוד | נותן סמכות לארכיטקטורה מומצאת |
| 7 | תוויות מהפרומפט | הצמתים חוזרים על המילים שלך, לא על אוצר המילים של התחום | הדיאגרמה לא ניתנת לחיפוש ולא ניתנת לזיהוי |
1. צמתים כפולים שהם אותו שירות
המודל ראה "auth" ו"שירות אימות" בשני משפטים שונים ויצר שני צמתים.
flowchart LR
  API[API Gateway] --> AUTH[Auth]
  AUTH --> DB[(מסד נתונים)]
  API --> AUTHSVC[שירות אימות]
  AUTHSVC --> DB
מתוקן: צומת אחד, מזהה אחד, השם שבו הצוות משתמש.
flowchart LR
  API[API Gateway] --> AUTH[auth-service]
  AUTH --> USERS[(postgres: users)]
2. החלטות בלי ענף "לא"
flowchart TD
  REQ[בקשה] --> Q{הטוקן תקין?}
  Q -->|כן| OK[עיבוד]
מעוין עם יציאה אחת אינו החלטה: הוא קישוט. לכל תנאי נדרשים שני הנתיבים שלו, ולנתיב השגיאה נדרש יעד.
flowchart TD
  REQ[בקשה] --> Q{הטוקן תקין?}
  Q -->|כן| OK[עיבוד]
  Q -->|לא| R401[מענה 401]
  OK --> FIN([סוף])
  R401 --> FIN
3. חיצים שהופכים את כיוון הנתון
קלאסי עם תורים ו־webhooks: המודל מצייר את ההיררכיה הארגונית במקום את הזרימה האמיתית.
flowchart LR
  WORKER[Worker] --> QUEUE[תור עבודות]
ה־worker לא דוחף לתור: הוא צורך ממנו. ציור שגוי של הכיוון הזה הופך תכנון pull לתכנון push, שהוא מערכת אחרת עם ערבויות אחרות.
flowchart LR
  API[API] -->|מכניס לתור| QUEUE[תור עבודות]
  QUEUE -->|צורך| WORKER[Worker]
4. הקופסה הגנרית "מסד נתונים"
זה הפגם היקר ביותר, כי בדיוק המידע שבגללו מישהו פותח את הדיאגרמה נעלם. צומת [(מסד נתונים)] שבפועל הוא Postgres לטרנזקציות, Redis לסשנים ו־S3 לקבצים מצורפים לא מתעד: הוא מסתיר. הכלל המעשי: אם לשני מאגרים יש ערבויות עמידות שונות, הם שני צמתים.
5, 6 ו־7: שכבות שהומצאו ותוויות שאולות
ה־subgraph בשם "שכבת תצוגה", "שכבת עסקים" ו"שכבת נתונים" הם בדרך כלל תבנית מנטלית של המודל, לא מבנה של המאגר שלך. כך גם התוויות: אם הצומת נקרא "מודול עיבוד תשלומים" ובקוד הוא billing-worker, אף אחד לא יוכל להצליב את הדיאגרמה עם הפרויקט. ואם חסר סיום, הקורא לא יודע אם הזרימה נגמרת שם או שהמודל נעצר באמצע.
למה בדיקת דיאגרמה בטקסט לא עובדת?
כי הפגמים החשובים הם טופולוגיים והטקסט לא חושף אותם. בקריאת רשימה של שורות A --> B אפשר לוודא שכל צלע סבירה בנפרד, אבל לא תראה ששני חיצים נחתכים, שצומת נשאר יתום, שההיררכיה הפוכה או שיש מעגל של שלוש קפיצות. התכונות האלה נראות רק כשהגרף מצויר וממוקם.
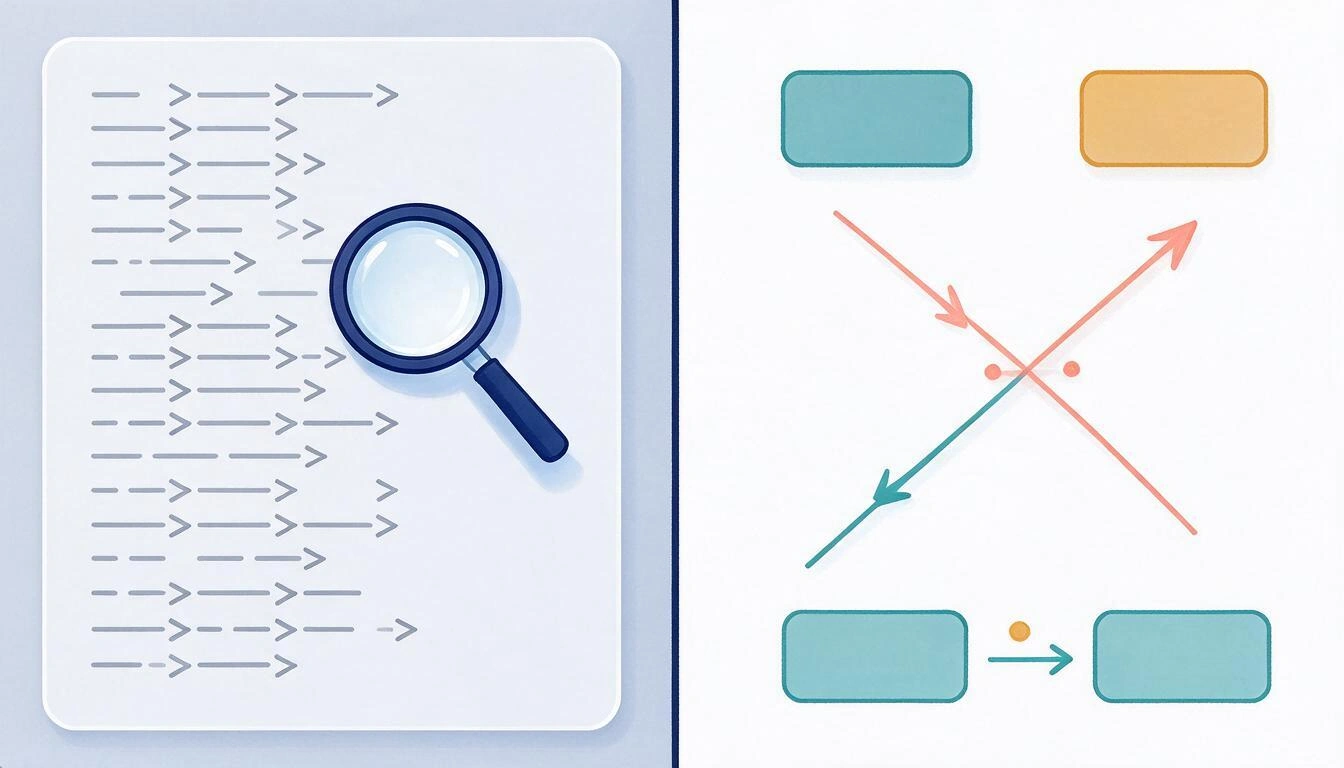
יש סיבה שנייה, עדינה יותר: בקריאת ה־.mmd אתה בודק מה הכותב כתב; בהתבוננות ברינדור אתה בודק מה הקורא יבין. אלה דברים שונים. דיאגרמה עם חמש עשרה צלעות נכונות ופריסה אוטומטית שדוחסת אותן נכונה טכנית ושבורה תקשורתית, וזה בדיוק מה שבודק של pull request מאשר בלי להסתכל כי "בלוק ה־mermaid מעוצב היטב".
התעשייה עצמה זזה לכיוון הזה. Anthropic השיקה את Claude Whiteboards בבטא ב־10-11-2026: לוח עבודה בזמן אמת שבו העוזר הופך דיון ללוח, מקבץ פתקים לפי נושא ומאפשר להעביר אותו אחר כך ל־Lucid, ל־Miro או ל־Vani של Zoho (unite.ai). ו־Miro, באירוע Canvas 26 שלה, הצהירה שהיא כבר "לא בעסקי הלוחות" ושהיא רוצה להיות "שכבת קבלת ההחלטות השיתופית של הארגון האג'נטי" (Forrester, 01-06-2026). הפלט הטבעי של הבינה המלאכותית הופך להיות לוח העבודה, לא בלוק הטקסט. למי שמבקר דיאגרמות, זו בשורה טובה: הביקורת שייכת למקום שבו רואים את הצורה.
מחזור הבדיקה: מ־.mmd ללוח ובחזרה ל־.mmd
המחזור מורכב מחמישה שלבים והתכונה המרכזית שלו היא שהוא נסגר: מה שנכנס למאגר הוא הדיאגרמה שתוקנה בלוח, לא המקור של הסוכן. אם התיקון נשאר בצילום מסך או בהערה ב־pull request, ה־.mmd השגוי שורד ומזין שוב את הסוכן הבא.
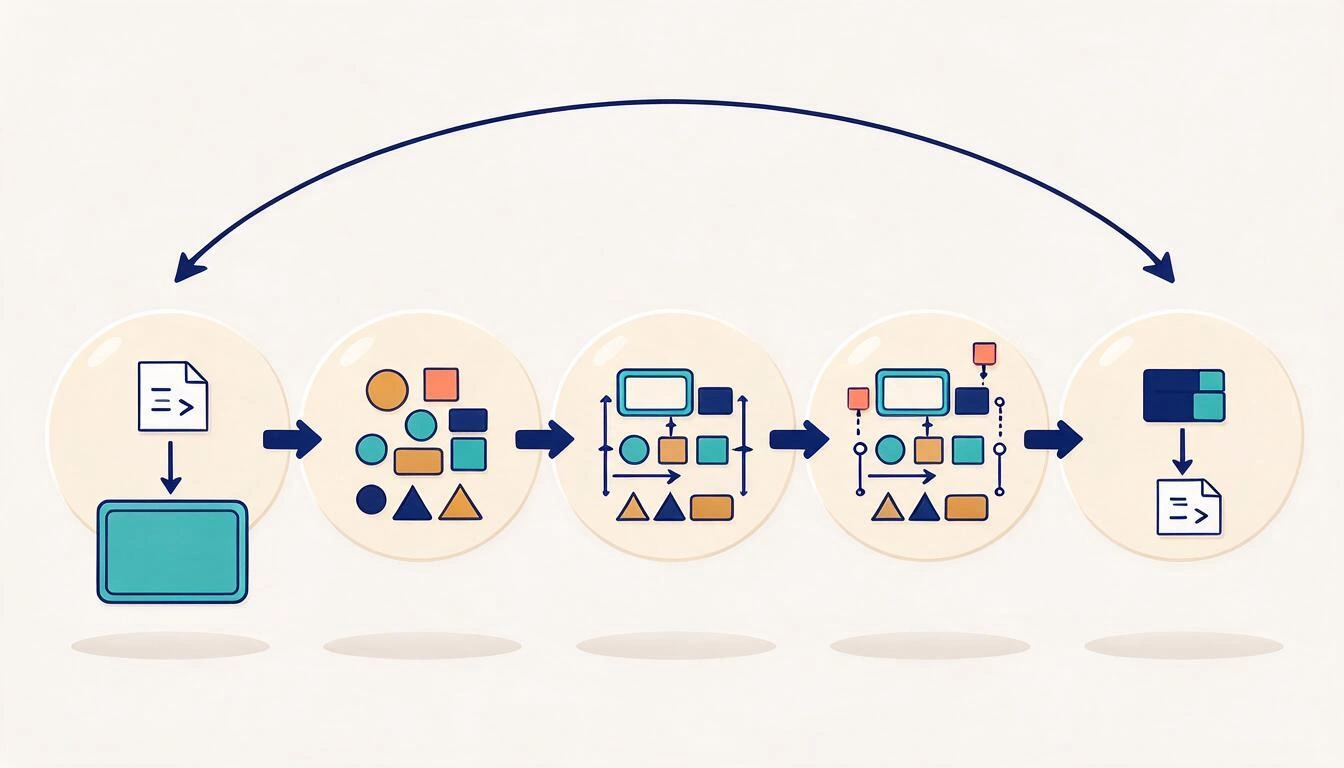
- ייבוא. הדבק את ה־
.mmdשהסוכן נתן לך בלוח עבודה חזותי, או טען אותו כקובץ. המטרה: להפריד את הבדיקה מעורך הקוד, שבו הפיתוי הוא לקרוא במקום להסתכל. - פיזור וסידור. מקם את הצמתים בשכבות אופקיות לפי אחריות (כניסה, תזמור, תחום, אחסון). כמעט כל הפגמים של כיוון ושל עומק מזויף נחשפים כאן: חץ שעולה שתי שכבות הוא בדרך כלל חץ הפוך.
- סימון המפוקפק. כל צומת או מחבר שאי אפשר לאשר בקריאת הקוד מסומן בהערה, וההערה נושאת קישור להוכחה: הקובץ, הטיקט, ה־ADR. דיאגרמה שנבדקה אינה דיאגרמה בלי ספקות, אלא כזו שהספקות בה מתויגים ומתועדים.
- תיקון ביד. איחוד צמתים כפולים, פיצול הקופסה הגנרית למאגרים האמיתיים, הוספת ענף "לא", סגירה עם סיום, שינוי סוג הצורה כך שמעוין יהיה מעוין ומאגר יהיה גליל, וקיבוע מחדש של המחברים לנקודות הנכונות.
- ייצוא חזרה. שפוך את התוצאה ל־
.mmdוהחלף את הקובץ המקורי במאגר, באותו commit של הבדיקה. זה השלב שרוב הצוותים מדלגים עליו, והוא זה שמונע מהשגיאה לחזור.
בפועל, שלב 3 הוא מה שהופך את זה לתהליך הנדסי ולא למפגש עימוד. הערת צד עם קישור לקובץ המסוים שמוכיח שה־worker צורך מהתור היא תיעוד שניתן לאימות; "נראה לי שהחץ הזה הפוך" בשרשור ב־Slack, לא.
צ'קליסט: 10 בדיקות לפני מיזוג דיאגרמה שנוצרה בבינה מלאכותית
רשימה סגורה, שנועדה להדבקה בתבנית ה־pull request. אם אחת נכשלת, הדיאגרמה לא נכנסת.
- ייחודיות: אף רכיב אמיתי לא מופיע כשני צמתים. מזהה אחד לשירות, שם המאגר או הפריסה.
- החלטות שלמות: לכל מעוין לפחות שתי צלעות יוצאות, מתוייגות, ולענף השגיאה יש יעד.
- סיומים: כל נתיב נגמר בצומת סיום מפורש; אין שרשראות שנקטעות בשלב תהליך.
- כיוון הנתון: כל חץ הולך בכיוון שבו המידע נע, לא בכיוון ההיררכיה הארגונית. בדוק במיוחד תורים, webhooks ו־polling.
- מאגרים מפורקים: אין קופסה גנרית מסוג "מסד נתונים", "שירותים" או "תשתית". צומת אחד לכל מאגר עם הטכנולוגיה והתוכן.
- שכבות אמיתיות: כל
subgraphמתאים לגבול שקיים (פריסה, מאגר, חשבון, רשת), לא להפשטה מספר לימוד. - אוצר מילים של התחום: התוויות משתמשות בשמות שהצוות כותב בקוד ובטיקטים, לא במילים של הפרומפט שלך.
- בלי יתומים ובלי חיתוכים שאפשר להימנע מהם: אין צומת מנותק, והחיתוכים שנשארו מוצדקים ולא ניתנים לפתרון בסידור מחדש.
- קריא בגודל שבו הוא מתפרסם: מובן ברוחב של ה־
READMEאו פורטל התיעוד, לא רק עם זום. - עקיבות: לכל אלמנט לא ברור יש הערה עם קישור לקוד, לטיקט או ל־ADR שתומכים בו; וה־
.mmdבמאגר הוא זה שיוצא אחרי התיקון.
פיתוח מונחה מפרט: אם הדיאגרמה שגויה, הקוד יורש את הטעות
זו הסיבה שהביקורת הפסיקה להיות קוסמטית ב־2026. בפיתוח מונחה מפרט, המפרט ב־Markdown, עם דיאגרמות ה־Mermaid של הארכיטקטורה והרצף שלו, הוא הארטיפקט שממנו הסוכן מייצר את המימוש, לא הערה עליו. דיאגרמה שגויה בתוך המפרט הזה כבר אינה תיעוד מיושן: היא קלט פגום במחולל קוד.
הגישה מתועדת ב־Spec Kit של GitHub, שהתזה שלו היא ש"המפרטים לא משרתים את הקוד; הקוד משרת את המפרטים", ותוכניות המימוש שהוא מייצר כוללות דיאגרמות ארכיטקטורה ורצף ב־Mermaid לצד מודל הנתונים ומצבי הכשל.
בתרגום ליום־יום: מעוין בלי ענף "לא" במפרט הוא, בסבירות גבוהה, מקרה שגיאה שלא מומש בקוד שנוצר. חץ הפוך בין API לתור הוא תכנון push היכן שרצית pull. וקופסת "מסד נתונים" שהסתירה Postgres, Redis ו־S3 הופכת למאגר יחיד עם שלוש אחריות. הדיאגרמה הפסיקה להיות תצלום של המערכת והפכה לחלק מהתוכנית, ובתוכניות בודקים.
שאלות נפוצות
מה המשמעות של "Mermaid slop"?
זו דיאגרמה שנוצרה בבינה מלאכותית עם תחביר Mermaid תקין אבל בלי ערך תקשורתי: צורות גנריות וזהות, פלטת ברירת מחדל, חיצים עם תוויות שגויות ובמקרים הגרועים רכיבים או קשרים שלא קיימים במערכת. המונח התפשט מהפרויקט Diagram Design והוא מתועד בסקירה של explainX מאוגוסט 2026.
אפשר לאמת אוטומטית דיאגרמת Mermaid שנוצרה בבינה מלאכותית?
רק חלקית. linter או המפענח עצמו מזהה שגיאות תחביר, ואפשר לאוטמט בדיקות מבניות: צמתים יתומים, מעוינים עם יציאה אחת, נתיבים בלי סיום או מזהים עם תוויות דומות באופן חשוד. מה שאף כלי לא יכול לאמת לבדו הוא אם הדיאגרמה מתארת את המערכת שלך; זה מחייב להצליב אותה עם הקוד, ולכן הצ'קליסט במאמר הזה משלב בדיקות שניתנות לאוטומציה עם סקירה אנושית.
למה לא מספיק לסקור את בלוק ה־mermaid ב־pull request?
כי ב־diff קוראים צלעות אחת אחת והפגמים הרלוונטיים הם של הגרף כולו: חיתוכים, היררכיות הפוכות, מעגלים, צמתים מבודדים, צפיפות בלתי קריאה. בנוסף, בקריאת הטקסט בודקים את הכוונה של הכותב ולא את מה שהקורא של הרינדור יראה. הסקירה השימושית נעשית על הדיאגרמה המצוירת.
באיזה כלי אשתמש כדי לתקן דיאגרמת Mermaid ביד?
צריך לוח עבודה שעושה את המסע המלא: לייבא את ה־.mmd, לתת לך להזיז ולשנות צורות ומחברים, להוסיף הערות על אלמנטים ולייצא שוב ל־Mermaid. השלב האחרון הוא זה שרוב הצופים פוסלים, כי הם מרנדרים אבל לא מחזירים את הקוד המתוקן. FlowBoard מכסה את המחזור: מייבא Mermaid מקובץ או בהדבקת הקוד, מפזר את הדיאגרמה על לוח אינסופי עם זום וגלילה, מאפשר לתקן ביד צורות, מחברים וקיבועים עם מגנטיות לנקודות העיגון, להוסיף הערות צד עם קישורים לכל אלמנט ולייצא חזרה ל־Mermaid.
כמה זמן לוקחת ביקורת של דיאגרמה שנוצרה בבינה מלאכותית?
תלוי בגודל, אבל סדר הגודל לדיאגרמה של 15-25 צמתים הוא 20 עד 40 דקות בפעם הראשונה, ופחות בהרבה כשהצוות כבר הטמיע את הצ'קליסט וקבע את שמות התחום. בהשוואה לעלות של ארכיטקטורה שגויה שנכנסת לתיעוד הרשמי, או, בזרימה מונחית מפרט, לקוד שנוצר, זה זול.
צריך להפסיק להשתמש בבינה מלאכותית ליצירת דיאגרמות?
לא. יצירת הטיוטה הראשונה עם סוכן חוסכת את העבודה המייגעת של הקלדת צמתים וצלעות, ולחקור מערכת לא מוכרת זה שימושי. מה שאסור לדלג עליו הוא הצעד הבא: אף דיאגרמה שנוצרה בבינה מלאכותית לא מתפרסמת בלי לעבור בלוח העבודה ובצ'קליסט. הבינה המלאכותית עושה את הטיוטה; האחריות על הדיאגרמה נשארת של הצוות שחותם עליה.
סיכום: הדיאגרמה שאתה מפרסם היא זו שבדקת
השינוי של 2026 הוא לא שהבינה המלאכותית מציירת דיאגרמות, אלא שהיא מציירת אותן מהר יותר ממה שאנחנו בודקים אותן. כל עוד VS Code מצייר אותן בלי הגדרות, Claude הופך אותן ללוחות ומפרטים ב־Markdown מזינים מחוללי קוד, בקרת האיכות היחידה שנשארה היא האנושית: להסתכל על הצורה, לסמן מה שאי אפשר להוכיח ולהחזיר למאגר את הגרסה המתוקנת. עשר בדיקות ומחזור שנסגר מספיקים כדי שדיאגרמה תחזור להיות תיעוד אמין במקום קישוט סביר.
המחזור הזה צריך מקום שבו הוא מתרחש. ב־AIsToHire אנחנו פותרים זאת עם FlowBoard, הלוח האינסופי שלנו לדיאגרמות: מדביקים או מייבאים את ה־.mmd של הסוכן, מפזרים אותו על קנבס אינסופי, מסדרים מחדש צורות, מלבנים, אליפסות, מעוינים להחלטה, מסמכים, פתקים דביקים וטקסט, ומחברים עם חיצים ישרים או אורתוגונליים, מקבעים כל חיבור עם מגנטיות לנקודות של האלמנטים, מסמנים את המפוקפק בהערות צד ובקישורי אימות, ומייצאים חזרה ל־Mermaid. הלוח נשמר לבד, כך שהביקורת נרשמת וניתן לחזור אליה.
פתח את FlowBoard, הדבק את ה־.mmd שהסוכן נתן לך ובדוק את הדיאגרמה במקום שבו רואים אותה באמת: סדר בשכבות, תקן צורות ומחברים ביד, סמן את המפוקפק בקישורי אימות וייצא אותה חזרה ל־Mermaid. התחל את הלוח הראשון שלך בחינם.
פתח את FlowBoard, הדבק את ה־.mmd שהסוכן נתן לך ובדוק את הדיאגרמה במקום שבו רואים אותה באמת: סדר בשכבות, תקן צורות ומחברים ביד, סמן את המפוקפק בקישורי אימות וייצא אותה חזרה ל־Mermaid. התחל את הלוח הראשון שלך בחינם.