 FlowBoard
Mermaid slop: slik gjennomgår og retter du diagrammene KI-en lager for deg før du publiserer dem
Teamet i FlowBoardSkrevet med AI-hjelp14 min lesetidKort fortalt:
- «Mermaid slop» er navnet som ble populært i 2026 på KI-genererte diagrammer som er gyldige i syntaks, men uleselige eller rett og slett feil. Begrepet kom fra prosjektet Diagram Design, som presenterte seg med slagordet «no Figma, no generic rounded boxes, no Mermaid-slop» og som i august 2026 allerede hadde over 11 000 stjerner på GitHub (explainX, 16.08.2026).
- Problemet vokste med distribusjonen: VS Code 1.121 (20.05.2026) rendrer Mermaid nativt i forhåndsvisningen av Markdown, uten utvidelse, og assistentene genererer det som standard (Visual Studio Code).
- En modell optimaliserer for grammatisk gyldighet, ikke for at systemet er korrekt:
.mmd-filen parses, men duplikerer noder, glemmer «nei»-grenen i en beslutning eller snur retningen på dataen. - Å gjennomgå et diagram ved å lese
-->-linjer fungerer ikke: manglene som betyr noe er topologiske og synes bare når diagrammet er tegnet. - Syklusen som fungerer: importer
.mmdtil et lerret, omorganiser i lag, merk det tvilsomme med en lenke til koden eller saken som beviser det, rett opp for hånd og eksporter på nytt slik at den rettede versjonen er den som havner i repositoriet.
Siden midten av 2026 er spørsmålet i ingeniørteamene ikke lenger hvordan man genererer et diagram, men hvem som står inne for det. Agentene skriver Mermaid i farten, GitHub og VS Code tegner det uten konfigurasjon, og resultatet havner i README like naturlig som en kodeblokk. Det som mangler, er revisjonslaget. Denne artikkelen går gjennom de typiske manglene, den tekniske grunnen til at de oppstår og en reproduserbar gjennomgangssyklus som lukkes i et visuelt lerret, i vårt tilfelle FlowBoard, den uendelige tavlen for diagrammer fra AIsToHire, som importerer og eksporterer Mermaid på nytt, slik at diagrammet som publiseres er det rettede og ikke det første modellen spyttet ut.
Hva er «Mermaid slop» egentlig?
Mermaid slop er et KI-generert diagram som kompilerer uten feil og likevel ikke duger: identiske avrundede bokser for ulike begreper, piler uten etikett eller med vage etiketter, standardfarger som ikke sier noe og en refleksiv generering: det tegnes fordi det ble bedt om, ikke fordi det trengs. Definisjonen settes av gjennomgangen fra explainX om begrepet (16.08.2026), som sporer det tilbake til prosjektet Diagram Design av Cathryn Lavery.
Den viktige nyansen er at det finnes to lag av «slop», og de forveksles ofte:
| Lag | Hva som svikter | Oppdages | Kostnad for å rette |
|---|---|---|---|
| Estetisk | Generiske former, standardpalett, alt likt | Med et øyekast | Lav: tema, former, gruppering |
| Semantisk | Diagrammet beskriver et system som ikke finnes | Bare ved å sammenligne med den virkelige koden | Høy: repositoriet må åpnes på nytt |
Den offentlige samtalen i 2026 har nesten helt sentrert seg om det første. Verktøyene som har dukket opp, fra skills for redaksjonell diagramtegning til generatorer som produserer native Excalidraw-elementer i stedet for Mermaid-tekst, angriper først og fremst utseendet. Det andre laget, det som gjør at et diagram lyver om arkitekturen din, er fortsatt menneskelig arbeid.
Hvorfor produserer en LLM Mermaid som er perfekt i syntaks og svakt i semantikk?
Fordi det er to ulike mål, og bare ett av dem har rikelig treningssignal. Grammatikken i Mermaid er lukket, liten og massivt representert på GitHub: en modell reproduserer den nesten uten feil. Korrektheten til diagrammet avhenger derimot av et konkret system som modellen vanligvis ikke har lest i sin helhet, så den fyller hullene med den hyppigste formen for et arkitekturdiagram, ikke med din.
Dertil kommer tre praktiske effekter:
- Prompten er den eneste kilden. Hvis du beskriver systemet i tre setninger, gir agenten tilbake et diagram med granulariteten til tre setninger og pynter det til det ser komplett ut. Som Mermaid selv oppsummerer det når de snakker om vibe diagramming: «et diagram generert ut fra en vag prompt vil gjenspeile promptens vaghet» (Mermaid, 24.03.2026).
- Det finnes ingen semantisk kompilator. En rød test varsler deg; et feil diagram rendres like pent som et riktig. Det finnes ingen ekvivalent til
tscfor «denne tjenesten finnes ikke». - Layouten bestemmes av motoren, ikke av forfatteren. Mermaid plasserer nodene med sin algoritme og gir deg ingen praktisk måte å rette oppsettet etter rendring. Hvis det virkelige hierarkiet ikke stemmer med det auto-layouten tegner, taper du diskusjonen med verktøyet.
Og bransjens kontekst sier at verifisering ikke er valgfritt. Utviklerundersøkelsen 2026 fra Stack Overflow (publisert 06.10.2026, over 30 000 svar i 169 land) fant at nesten halvparten stoler på KI-ens resultat bare når de lett kan verifisere det, og at knapt 6,6 % ville godta det for viktige beslutninger. Et arkitekturdiagram i den offisielle dokumentasjonen er, nesten per definisjon, en viktig beslutning.
De sju tilbakevendende manglene i et KI-generert diagram
Dette er de sju som dukker opp igjen og igjen når man reviderer .mmd-filer generert av agenter. Alle parses; alle er feil. Det felles mønsteret er at modellen fyller inn troverdig struktur der den mangler domeneinformasjon.
| # | Mangel | Symptom i .mmd | Konsekvens |
|---|---|---|---|
| 1 | Dupliserte noder | To ulike ID-er med lignende etiketter for samme tjeneste | Det ser ut som det er to komponenter der det er én |
| 2 | Beslutning uten «nei»-gren | En rombe med bare én utgående kant | Feilveien blir udokumentert |
| 3 | Flyt uten terminator | Kjeder som ender i en prosessnode | Man vet ikke når brukstilfellet slutter |
| 4 | Snudd retning | Pilen peker mot kilden til dataen | Hvem som kaller hvem blir snudd |
| 5 | Generisk boks | Én enkelt node «Database» | Skjuler tre lagre med ulike garantier |
| 6 | Falsk dybde | Lag eller subgraph som ikke finnes i koden | Gir autoritet til en oppfunnet arkitektur |
| 7 | Etiketter fra prompten | Nodene gjentar dine ord, ikke domenets ordforråd | Diagrammet er verken søkbart eller gjenkjennelig |
1. Dupliserte noder som er den samme tjenesten
Modellen har sett «auth» og «autentiseringstjeneste» i to ulike setninger og har laget to noder.
flowchart LR
  API[API Gateway] --> AUTH[Auth]
  API --> AUTHSVC[Autentiseringstjeneste]
  AUTH --> DB[(Database)]
  AUTHSVC --> DB
Rettet: én node, én ID, navnet teamet bruker.
flowchart LR
  API[API Gateway] --> AUTH[auth-service]
  AUTH --> USERS[(postgres: users)]
2. Beslutninger uten «nei»-gren
flowchart TD
  REQ[Foresporsel] --> Q{Gyldig token?}
  Q -->|Ja| OK[Behandle]
En rombe med bare én utgang er ikke en beslutning: det er pynt. Hver betingelse trenger sine to veier, og feilveien trenger et mål.
flowchart TD
  REQ[Foresporsel] --> Q{Gyldig token?}
  Q -->|ja| OK[Behandle]
  Q -->|nei| R401[Svar 401]
  OK --> FIN([Slutt])
  R401 --> FIN
3. Piler som snur retningen på dataen
Klassisk med køer og webhooks: modellen tegner organisasjonshierarkiet i stedet for den virkelige flyten.
flowchart LR
  WORKER[Worker] --> QUEUE[Jobbkø]
Workeren dytter ikke til køen: den konsumerer fra den. Å tegne denne retningen feil gjør et pull-design til et push-design, som er et annet system med andre garantier.
flowchart LR
  API[API] -->|legger i kø| QUEUE[Jobbkø]
  QUEUE -->|konsumerer| WORKER[Worker]
4. Den generiske boksen «Database»
Det er den dyreste mangelen, fordi det er nøyaktig informasjonen noen åpner diagrammet for som forsvinner. En node [(Database)] som i virkeligheten er Postgres for transaksjoner, Redis for sesjoner og S3 for vedlegg dokumenterer ikke: den skjuler. Den praktiske regelen: hvis to lagre har ulike holdbarhetsgarantier, er de to noder.
5, 6 og 7: oppfunne lag og lånte etiketter
subgraph-ene som heter «Presentasjonslag», «Forretningslag» og «Datalag» er som regel modellens mentale mal, ikke strukturen i repositoriet ditt. Det samme gjelder etiketter: hvis noden heter «modul for betalingsbehandling» og i koden er billing-worker, kan ingen krysse diagrammet mot prosjektet. Og hvis terminatoren mangler, vet ikke leseren om flyten slutter der eller modellen ble stående halvferdig.
Hvorfor fungerer det ikke å gjennomgå et diagram i tekst?
Fordi manglene som betyr noe er topologiske, og teksten avslører dem ikke. Når du leser en liste med A --> B-linjer, kan du verifisere at hver kant er troverdig én for én, men du ser ikke at to piler krysser hverandre, at en node ble foreldreløs, at hierarkiet er snudd eller at det finnes en syklus på tre hopp. Disse egenskapene er bare synlige når grafen er tegnet og plassert.
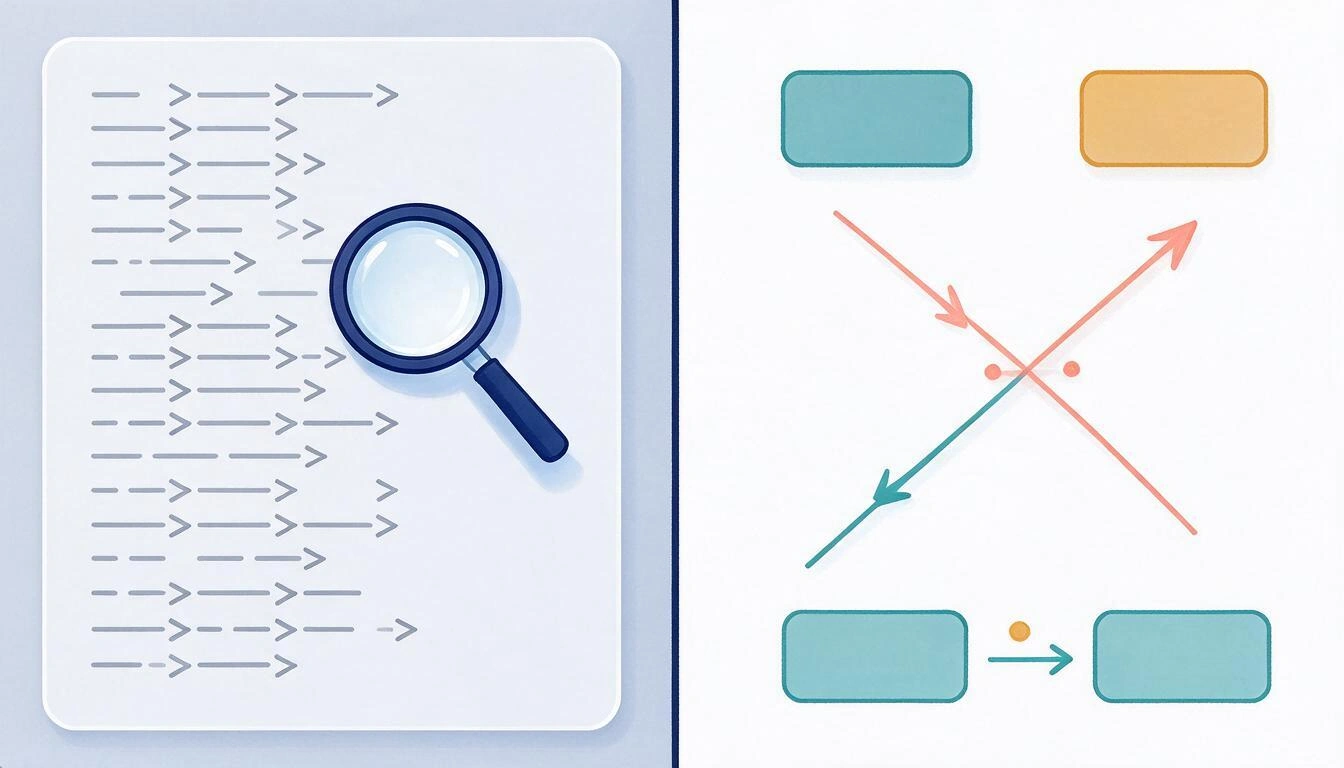
Det finnes en ekstra, mer subtil grunn: når du leser .mmd-filen, gjennomgår du det forfatteren skrev; når du ser på renderingen, gjennomgår du det leseren kommer til å forstå. Det er ulike ting. Et diagram med femten riktige kanter og en auto-layout som stabler dem oppå hverandre er teknisk i orden og kommunikativt ødelagt, og det er nøyaktig det en pull request-gjennomgåer godkjenner uten å se, fordi «mermaid-blokken er velformet».
Bransjen selv har beveget seg i den retningen. Anthropic lanserte Claude Whiteboards i beta 10.11.2026: et sanntidslerret der assistenten gjør en diskusjon om til en tavle, grupperer notater etter tema og lar deg ta det videre til Lucid, Miro eller Zohos Vani (unite.ai). Og Miro erklærte på arrangementet Canvas 26 at de ikke lenger «er i whiteboard-bransjen» og vil være «det samarbeidende beslutningslaget for den agentiske virksomheten» (Forrester, 01.06.2026). Det naturlige utfallet av KI er i ferd med å bli lerretet, ikke tekstblokken. For den som reviderer diagrammer er det gode nyheter: gjennomgangen hører hjemme der formen kan sees.
Gjennomgangssyklusen: fra .mmd til lerretet og tilbake til .mmd
Syklusen har fem steg, og nøkkelegenskapen er at den lukkes: det som havner i repositoriet er diagrammet rettet i lerretet, ikke agentens opprinnelige. Hvis rettingen blir værende i et skjermbilde eller en kommentar i pull requesten, overlever den feilaktige .mmd og mater neste agent på nytt.
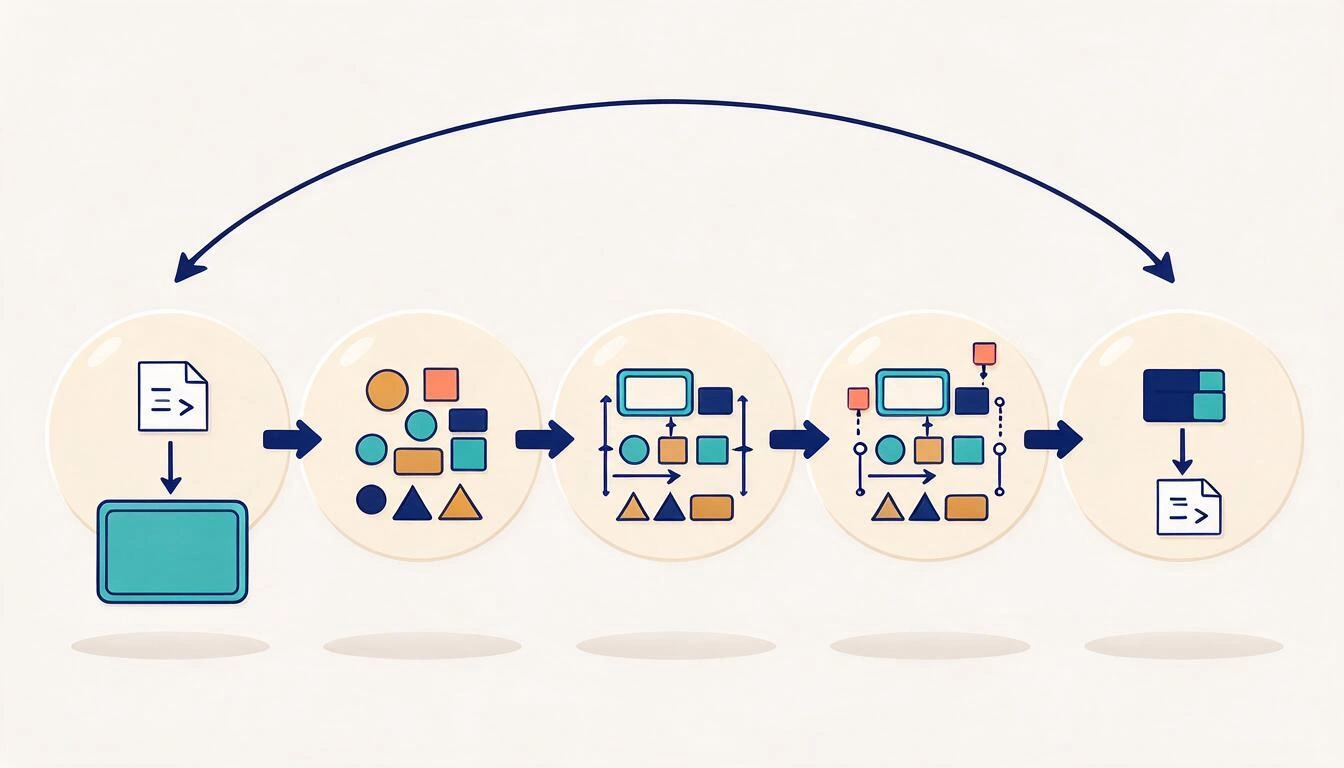
- Importer. Lim inn
.mmd-filen agenten ga deg i et visuelt lerret, eller last den inn som fil. Mål: skille gjennomgangen fra kodeeditoren, der fristelsen er å lese i stedet for å se. - Fordel og omorganiser. Plasser nodene i horisontale lag etter ansvar (inngang, orkestrering, domene, lagring). Nesten alle mangler i retning og falsk dybde røper seg her: en pil som stiger to lag, er som regel en snudd pil.
- Merk det tvilsomme. Hver node eller kobling du ikke kan bekrefte ved å lese koden, noteres, og notatet bærer en lenke til beviset: filen, saken, ADR-en. Et revidert diagram er ikke et uten tvil, det er et der tvilen er merket og sporet.
- Rett for hånd. Slå sammen dupliserte noder, del den generiske boksen i de virkelige lagrene, legg til «nei»-grenen, avslutt med terminator, bytt formtype slik at en rombe er en rombe og et lager er en sylinder, og forankre koblingene på nytt til de riktige punktene.
- Eksporter tilbake. Skriv resultatet til
.mmdog erstatt den opprinnelige filen i repositoriet, i den samme committen som gjennomgangen. Det er steget de fleste team hopper over, og det som hindrer at feilen innføres på nytt.
I praksis er steg 3 det som gjør dette til en ingeniørprosess og ikke en layoutøkt. Et sidenotat med en lenke til den konkrete filen som beviser at workeren konsumerer fra køen, er verifiserbar dokumentasjon; «jeg tror denne pilen er motsatt» i en Slack-tråd er det ikke.
Sjekkliste: 10 kontroller før du merger et KI-generert diagram
Lukket liste, tenkt for å limes inn i pull request-malen. Hvis noen svikter, kommer ikke diagrammet inn.
- Unikhet: ingen virkelig komponent vises som to noder. Én ID per tjeneste, navnet fra repositoriet eller driftsettingen.
- Komplette beslutninger: hver rombe har minst to utgående kanter, etikettert, og feilgrenen har et mål.
- Terminatorer: hver vei ender i en eksplisitt sluttnode; det finnes ingen kjeder som kuttes i et prosessteg.
- Datas retning: hver pil går i den retningen informasjonen beveger seg, ikke i organisasjonshierarkiets. Sjekk særlig køer, webhooks og polling.
- Oppdelte lagre: ingen generisk boks som «Database», «Tjenester» eller «Infrastruktur». Én node per lager med teknologi og innhold.
- Virkelige lag: hver
subgraphtilsvarer en grense som finnes (en driftsetting, et repositorium, en konto, et nettverk), ikke en lærebokabstraksjon. - Domenets ordforråd: etikettene bruker navnene teamet skriver i koden og i sakene, ikke ordene fra prompten din.
- Ingen foreldreløse eller unngåelige kryss: ingen frakoblet node, og de kryssene som gjenstår er begrunnet og kan ikke løses ved å omorganisere.
- Lesbart i størrelsen det publiseres: det forstås i bredden til
READMEeller dokumentasjonsportalen, ikke bare med zoom. - Sporbarhet: hvert ikke-åpenbare element har et notat med lenke til koden, saken eller ADR-en som støtter det; og
.mmdi repositoriet er den eksporterte etter rettingen.
Spec-driven development: hvis diagrammet er feil, arver koden feilen
Dette er grunnen til at revisjonen sluttet å være kosmetisk i 2026. I spesifikasjonsdrevet utvikling er spesifikasjonen i Markdown, med sine Mermaid-diagrammer for arkitektur og sekvens, artefakten agenten genererer implementeringen fra, ikke en kommentar til den. Et feil diagram i den spesifikasjonen er ikke lenger utdatert dokumentasjon: det er en defekt inndata i en kodegenerator.
Tilnærmingen er gjengitt i selve Spec Kit fra GitHub, hvis tese er at «spesifikasjoner tjener ikke koden; koden tjener spesifikasjonene», og implementeringsplanene det produserer inkluderer arkitektur- og sekvensdiagrammer i Mermaid ved siden av datamodellen og feilmodusene.
Oversatt til hverdagen: en rombe uten «nei»-gren i spesifikasjonen er med stor sannsynlighet et ikke-implementert feiltilfelle i den genererte koden. En snudd pil mellom API og kø er et push-design der du ville ha pull. Og en boks «Database» som dekket over Postgres, Redis og S3 blir et enkelt repositorium med tre ansvarsområder. Diagrammet gikk fra å være et bilde av systemet til å være en del av tegningen, og tegninger gjennomgås.
Ofte stilte spørsmål
Hva betyr «Mermaid slop»?
Det er et KI-generert diagram med gyldig Mermaid-syntaks, men uten kommunikativ verdi: generiske og identiske former, standardpalett, feil etiketterte piler og, i de verste tilfellene, komponenter eller relasjoner som ikke finnes i systemet. Begrepet ble populært ut fra prosjektet Diagram Design og dokumenteres av gjennomgangen fra explainX fra august 2026.
Kan et KI-generert Mermaid-diagram valideres automatisk?
Bare delvis. En linter eller selve parseren oppdager syntaksfeil, og strukturelle kontroller kan automatiseres: foreldreløse noder, romber med bare én utgang, veier uten terminator eller ID-er med mistenkelig like etiketter. Det ingen verktøy kan verifisere alene, er om diagrammet beskriver systemet ditt; det krever å krysse det mot koden, og derfor blander sjekklisten i denne artikkelen automatiserbare kontroller med menneskelig gjennomgang.
Hvorfor er det ikke nok å gjennomgå mermaid-blokken i pull requesten?
Fordi du i diffen leser kanter én for én, og de relevante manglene gjelder hele grafen: kryss, snudde hierarkier, sykluser, isolerte noder, uleselig tetthet. Dessuten vurderer du ved å lese teksten forfatterens intensjon og ikke det leseren av renderingen vil se. Den nyttige gjennomgangen gjøres på det tegnede diagrammet.
Hvilket verktøy bruker jeg for å rette et Mermaid-diagram for hånd?
Du trenger et lerret som gjør hele reisen: importere .mmd, la deg flytte og endre former og koblinger, notere elementer og eksportere til Mermaid igjen. Det siste steget er det de fleste visere faller på, som rendrer, men ikke gir tilbake den rettede koden. FlowBoard dekker syklusen: det importerer Mermaid fra fil eller ved å lime inn koden, fordeler diagrammet på et uendelig lerret med zoom og panorering, lar deg rette former, koblinger og forankringer for hånd med magnetisme mot forankringspunktene, legge til sidenotater med lenker per element og eksportere tilbake til Mermaid.
Hvor lang tid tar det å revidere et KI-generert diagram?
Det avhenger av størrelsen, men størrelsesordenen for et diagram på 15–25 noder er 20 til 40 minutter første gang, og betydelig mindre når teamet har internalisert sjekklisten og fastsatt domenenavnene. Sammenlignet med kostnaden ved at en feil arkitektur havner i den offisielle dokumentasjonen, eller i en spesifikasjonsdrevet flyt i den genererte koden, er det billig.
Må vi slutte å bruke KI til å lage diagrammer?
Nei. Å generere det første utkastet med en agent sparer det kjedelige arbeidet med å taste inn noder og kanter, og det er nyttig for å utforske et ukjent system. Det som ikke må hoppes over, er det neste steget: ingen KI-generert diagram publiseres uten å gå gjennom lerretet og sjekklisten. KI-en lager utkastet; ansvaret for diagrammet ligger fortsatt hos teamet som signerer det.
Avslutning: diagrammet du publiserer er det du har revidert
Endringen i 2026 er ikke at KI tegner diagrammer, men at den tegner dem raskere enn vi gjennomgår dem. Mens VS Code tegner dem uten konfigurasjon, Claude gjør dem om til tavler og spesifikasjoner i Markdown mater kodegeneratorer, er den eneste kvalitetskontrollen som gjenstår, den menneskelige: se på formen, merke det som ikke kan bevises og levere den rettede versjonen tilbake til repositoriet. Ti kontroller og en syklus som lukkes er nok til at et diagram igjen blir pålitelig dokumentasjon i stedet for troverdig dekorasjon.
Den syklusen trenger et sted å skje. Hos AIsToHire løser vi det med FlowBoard, vår uendelige tavle for diagrammer: man limer inn eller importerer agentens .mmd, fordeler den på et uendelig lerret, plasserer former på nytt (rektangler, ellipser, beslutningsromber, dokumenter, klistrelapper og tekst) og koblinger med rette eller ortogonale piler, forankrer hver tilkobling med magnetisme mot elementenes punkter, merker det tvilsomme med sidenotater og verifiseringslenker, og eksporterer tilbake til Mermaid. Tavlen lagres av seg selv, så revisjonen blir registrert og kan tas opp igjen.
Åpne FlowBoard, lim inn `.mmd`-filen agenten ga deg og revider diagrammet der det faktisk sees: omorganiser i lag, rett former og koblinger for hånd, merk det tvilsomme med verifiseringslenker og eksporter det tilbake til Mermaid. Start din første tavle gratis.
Åpne FlowBoard, lim inn `.mmd`-filen agenten ga deg og revider diagrammet der det faktisk sees: omorganiser i lag, rett former og koblinger for hånd, merk det tvilsomme med verifiseringslenker og eksporter det tilbake til Mermaid. Start din første tavle gratis.Les videre
Se alle innlegg →
Symboler i et flytdiagram: hva hvert av dem betyr, og hvordan du tegner ditt eget steg for steg

Krangle på WhatsApp eller snakke om det i person: hva vitenskapen sier om parkonflikter via meldinger

Tankekart, begrepskart og disposisjon: forskjeller og når du bør bruke hver av dem
