 FlowBoard
Mermaid slop: sådan gennemgår og retter du de diagrammer, AI genererer, før du udgiver dem
Teamet hos FlowBoardSkrevet med AI-assistance14 min. læsningKort fortalt:
- "Mermaid slop" er navnet, der i 2026 er blevet udbredt for AI-genererede diagrammer, som er syntaktisk gyldige, men ulæselige eller direkte forkerte; udtrykket stammer fra projektet Diagram Design, som præsenterede sig med sloganet "no Figma, no generic rounded boxes, no Mermaid-slop", og som allerede havde over 11.000 stjerner på GitHub i august 2026 (explainX, 16. august 2026).
- Problemet voksede med udbredelsen: VS Code 1.121 (20. maj 2026) gengiver Mermaid nativt i Markdown-forhåndsvisningen, uden udvidelse, og assistenter genererer det som standard (Visual Studio Code).
- En model optimerer grammatisk gyldighed, ikke systemets korrekthed:
.mmd-filen parser, men duplikerer noder, glemmer "nej"-grenen i en beslutning eller vender dataretningen om. - At gennemgå et diagram ved at læse
-->-linjer virker ikke: de fejl, der betyder noget, er topologiske og kan kun ses, når diagrammet er tegnet. - Den cyklus, der virker: importér
.mmdtil et lærred, omordn efter lag, annotér det tvivlsomme med et link til den kode eller det ticket, der beviser det, ret manuelt og eksportér igen, så det rettede er den version, der havner i repositoriet.
Siden midten af 2026 er spørgsmålet i ingeniørteams ikke længere, hvordan man genererer et diagram, men hvem der står inde for det. Agenter skriver Mermaid i farten, GitHub og VS Code tegner det uden konfiguration, og resultatet havner i README lige så naturligt som en kodeblok. Det, der mangler, er auditlaget. Denne artikel gennemgår de typiske fejl, den tekniske årsag til, at de opstår, og en reproducerbar gennemgangscyklus, der lukkes på et visuelt lærred — i vores tilfælde FlowBoard, AIsToHires uendelige whiteboard til diagrammer, som importerer og eksporterer Mermaid igen — så det diagram, der udgives, er det rettede og ikke det første, modellen spyttede ud.
Hvad er "Mermaid slop" egentlig?
Mermaid slop er et AI-genereret diagram, der kompilerer uden fejl og alligevel er ubrugeligt: identiske afrundede kasser til forskellige begreber, pile uden label eller med vage labels, standardfarver, der ikke siger noget, og refleksagtig generering — det tegnes, fordi det blev bedt om, ikke fordi det er nødvendigt. Definitionen fastlægges af explainX' gennemgang af begrebet (16. august 2026), som sporer det tilbage til projektet Diagram Design af Cathryn Lavery.
Den vigtige nuance er, at der er to lag af "slop", og de forveksles ofte:
| Lag | Hvad der fejler | Opdages | Pris for at rette det |
|---|---|---|---|
| Æstetisk | Generiske former, standardpalet, alt ens | Med det blotte øje | Lav: tema, former, gruppering |
| Semantisk | Diagrammet beskriver et system, der ikke findes | Kun ved sammenligning med den rigtige kode | Høj: repositoriet skal genåbnes |
Den offentlige samtale i 2026 har næsten udelukkende handlet om det første. De værktøjer, der er dukket op — fra redaktionelle diagram-skills til generatorer, der producerer native Excalidraw-elementer i stedet for Mermaid-tekst — går mest efter udseendet. Det andet lag, det der får et diagram til at lyve om din arkitektur, er stadig menneskeligt arbejde.
Hvorfor producerer en LLM Mermaid, der er perfekt i syntaks og svagt i semantik?
Fordi det er to forskellige mål, og kun det ene har rigeligt træningssignal. Mermaids grammatik er lukket, lille og massivt repræsenteret på GitHub: en model gengiver den næsten uden fejl. Diagrammets korrekthed afhænger derimod af et konkret system, som modellen normalt ikke har læst i sin helhed, så den udfylder hullerne med den mest almindelige form for et arkitekturdiagram, ikke med din.
Dertil kommer tre praktiske effekter:
- Prompten er den eneste kilde. Hvis du beskriver systemet i tre sætninger, returnerer agenten et diagram med tre sætningers granularitet og pynter det, indtil det ser komplet ud. Som Mermaid selv sammenfatter det om vibe diagramming: "et diagram genereret ud fra en vag prompt vil afspejle promptens vaghed" (Mermaid, 24. marts 2026).
- Der er ingen semantisk compiler. En rød test advarer dig; et forkert diagram renderes lige så pænt som et korrekt. Der findes ikke noget
tscfor "denne service findes ikke". - Layoutet bestemmes af motoren, ikke af forfatteren. Mermaid placerer noderne med sin algoritme og giver dig ingen bekvem måde at rette placeringen på efter rendering. Hvis det rigtige hierarki ikke svarer til det, auto-layoutet tegner, taber du diskussionen med værktøjet.
Og branchens kontekst siger, at verifikation ikke er valgfri. Stack Overflows udviklerundersøgelse 2026 (offentliggjort 6. oktober 2026, over 30.000 svar i 169 lande) fandt, at omkring halvdelen kun stoler på AI's output, når de nemt kan verificere det, og at knap 6,6 % ville godtage det til vigtige beslutninger. Et arkitekturdiagram i den officielle dokumentation er næsten per definition en vigtig beslutning.
De syv tilbagevendende fejl i et AI-genereret diagram
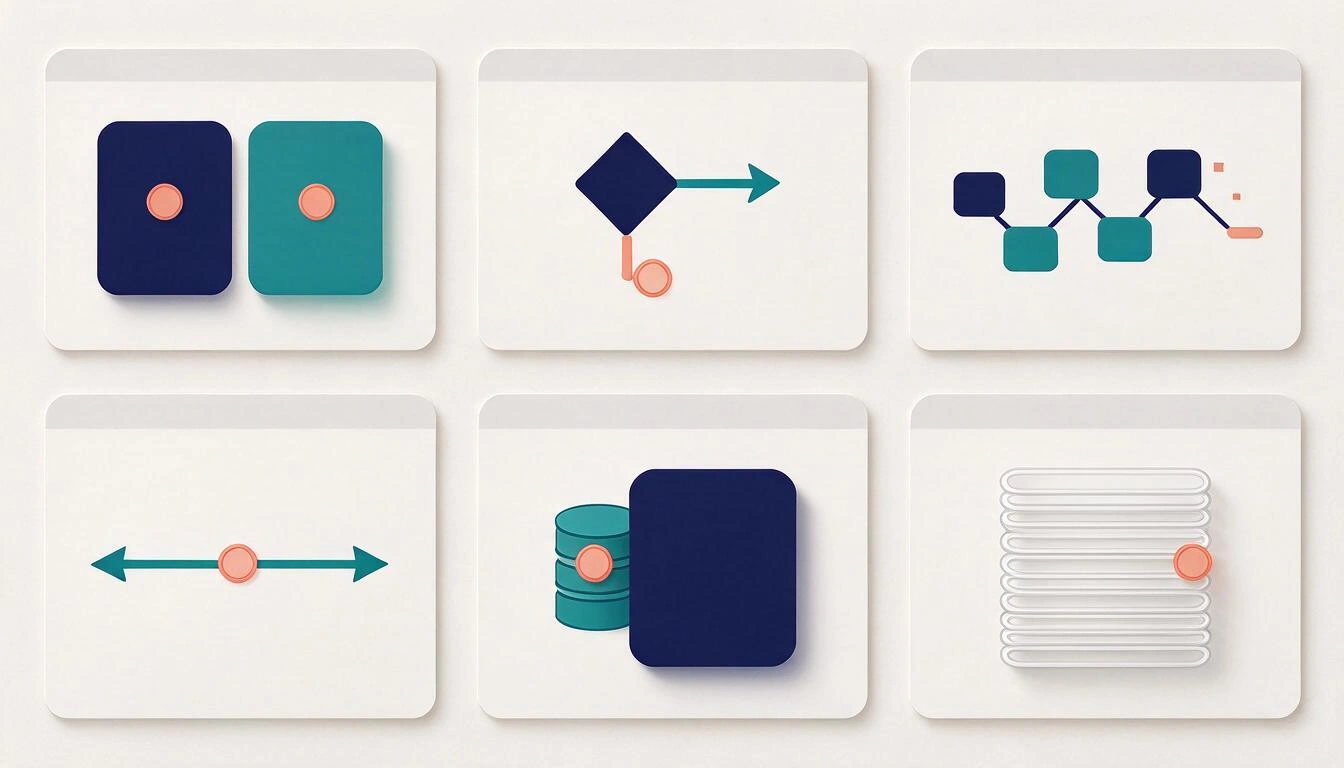
Det er de syv, der dukker op igen og igen, når man auditerer .mmd-filer genereret af agenter. Alle parser; alle er forkerte. Det fælles mønster er, at modellen fylder plausibel struktur ind, hvor den mangler domæneinformation.
| # | Fejl | Symptom i .mmd | Konsekvens |
|---|---|---|---|
| 1 | Duplikerede noder | To forskellige ID'er med lignende labels for samme service | Det ser ud, som om der er to komponenter, hvor der kun er én |
| 2 | Beslutning uden "nej"-gren | En rombe med kun én udgående kant | Fejlstien er udokumenteret |
| 3 | Flow uden terminator | Kæder, der slutter i en procesnode | Man ved ikke, hvornår use casen slutter |
| 4 | Omvendt retning | Pilen peger mod dataens oprindelse | Hvem der kalder hvem, vendes om |
| 5 | Generisk kasse | Én enkelt "Database"-node | Skjuler tre lagre med forskellige garantier |
| 6 | Falsk dybde | Lag eller subgraph, der ikke findes i koden | Giver autoritet til en opfundet arkitektur |
| 7 | Labels fra prompten | Noderne gentager dine ord, ikke domænets vokabular | Diagrammet kan ikke søges og genkendes ikke |
1. Duplikerede noder, der er den samme service
Modellen har set "auth" og "autentificeringsservice" i to forskellige sætninger og har oprettet to noder.
flowchart LR
  API[API Gateway] --> AUTH[Auth]
  API --> AUTHSVC[Autentificeringsservice]
  AUTH --> DB[(Database)]
  AUTHSVC --> DB
Rettet: én node, ét ID, det navn, teamet bruger.
flowchart LR
  API[API Gateway] --> AUTH[auth-service]
  AUTH --> USERS[(postgres: users)]
2. Beslutninger uden "nej"-gren
flowchart TD
  REQ[Forespørgsel] --> Q{Gyldigt token?}
  Q -->|Ja| OK[Behandl]
En rombe med kun én udgang er ikke en beslutning: den er pynt. Enhver betingelse har brug for sine to stier, og fejlstien har brug for en destination.
flowchart TD
  REQ[Forespørgsel] --> Q{Gyldigt token?}
  Q -->|ja| OK[Behandl]
  Q -->|nej| R401[Svar med 401]
  OK --> FIN([Slut])
  R401 --> FIN
3. Pile, der vender dataretningen om
Klassiker med køer og webhooks: modellen tegner organisationshierarkiet i stedet for det rigtige flow.
flowchart LR
  WORKER[Worker] --> QUEUE[Jobkø]
Workeren skubber ikke til køen: den forbruger fra den. At tegne denne retning forkert forvandler et pull-design til et push-design, som er et andet system med andre garantier.
flowchart LR
  API[API] -->|lægger i kø| QUEUE[Jobkø]
  QUEUE -->|forbruger| WORKER[Worker]
4. Den generiske "Database"-kasse
Det er den dyreste fejl, fordi netop den information forsvinder, som man åbner diagrammet for. En node [(Database)], der i virkeligheden er Postgres til transaktioner, Redis til sessioner og S3 til vedhæftninger, dokumenterer ikke: den skjuler. Den praktiske regel: hvis to lagre har forskellige holdbarhedsgarantier, er de to noder.
5, 6 og 7: opfundne lag og lånte labels
De subgraph, der hedder "Præsentationslag", "Forretningslag" og "Datalag", er som regel modellens mentale skabelon, ikke dit repositoriums struktur. Det samme gælder labels: hvis noden hedder "modul til betalingsbehandling", og det i koden er billing-worker, kan ingen krydsreferere diagrammet med projektet. Og hvis terminatoren mangler, ved læseren ikke, om flowet slutter dér, eller om modellen blev halvt færdig.
Hvorfor virker det ikke at gennemgå et diagram som tekst?
Fordi de fejl, der betyder noget, er topologiske, og teksten afslører dem ikke. Når du læser en liste af A --> B-linjer, kan du verificere, at hver enkelt kant er plausibel, men du ser ikke, at to pile krydser hinanden, at en node er blevet forældreløs, at hierarkiet er vendt om, eller at der er en cyklus på tre spring. De egenskaber er kun synlige, når grafen er tegnet og placeret.
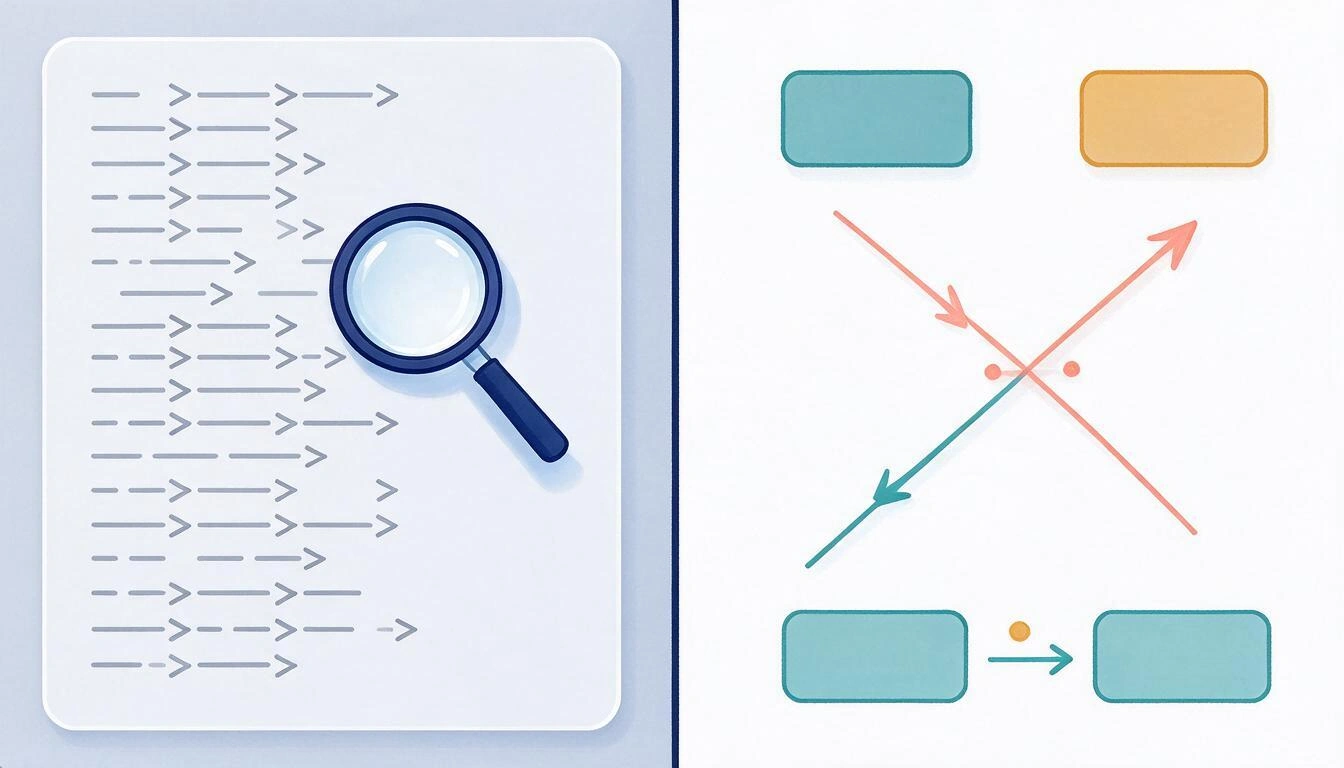
Der er en anden, mere subtil grund: når du læser .mmd'en, gennemgår du det, forfatteren skrev; når du ser på renderingen, gennemgår du det, læseren vil forstå. Det er to forskellige ting. Et diagram med femten korrekte kanter og et auto-layout, der propper dem sammen, er teknisk i orden og kommunikativt ødelagt, og det er præcis det, en pull request-reviewer godkender uden at kigge, fordi "mermaid-blokken er velformet".
Branchen selv har bevæget sig i den retning. Anthropic lancerede Claude Whiteboards i beta den 10. november 2026: et realtidslærred, hvor assistenten forvandler en diskussion til et board, grupperer noter efter emne og lader dig senere tage det videre til Lucid, Miro eller Zohos Vani (unite.ai). Og Miro erklærede på sin begivenhed Canvas 26, at de ikke længere "er i whiteboard-branchen", og at de vil være "det samarbejdende beslutningslag for den agentiske virksomhed" (Forrester, 1. juni 2026). AI's naturlige output er ved at blive lærredet, ikke tekstblokken. For den, der auditerer diagrammer, er det en god nyhed: gennemgangen hører hjemme dér, hvor man kan se formen.
Gennemgangscyklussen: fra .mmd til lærredet og tilbage til .mmd
Cyklussen har fem trin, og dens nøgleegenskab er, at den lukker: det, der havner i repositoriet, er det diagram, der er rettet på lærredet, ikke agentens original. Hvis rettelsen bliver i et skærmbillede eller en kommentar på pull requesten, overlever den fejlbehæftede .mmd og fodrer den næste agent igen.
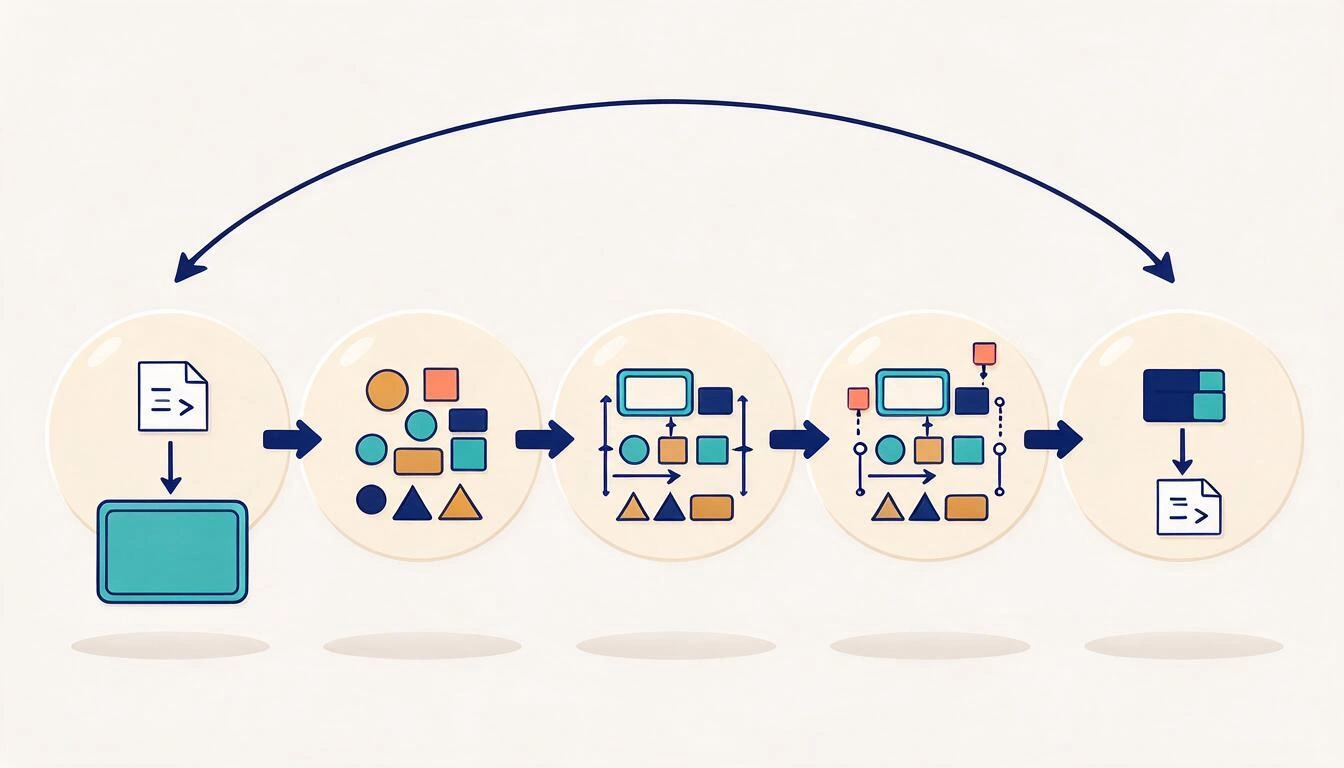
- Importér. Indsæt den
.mmd, agenten gav dig, i et visuelt lærred, eller indlæs den som fil. Formål: adskille gennemgangen fra kodeeditoren, hvor fristelsen er at læse i stedet for at se. - Fordel og omordn. Placér noderne i vandrette lag efter ansvar (indgang, orkestrering, domæne, lagring). Næsten alle retningsfejl og fejl med falsk dybde afsløres her: en pil, der går to lag op, er som regel en omvendt pil.
- Marker det tvivlsomme. Hver node eller konnektor, du ikke kan bekræfte ved at læse koden, annoteres, og annotationen indeholder et link til beviset: filen, ticketen, ADR'en. Et auditeret diagram er ikke et uden tvivl, men et, hvor tvivlen er mærket og sporet.
- Ret manuelt. Slå duplikerede noder sammen, del den generiske kasse op i de rigtige lagre, tilføj "nej"-grenen, afslut med en terminator, skift formtype, så en rombe er en rombe og et lager er en cylinder, og forankr konnektorerne igen til de rette punkter.
- Eksportér tilbage. Overfør resultatet til
.mmdog erstat den oprindelige fil i repositoriet, i samme commit som gennemgangen. Det er det trin, de fleste teams springer over, og det, der forhindrer, at fejlen indføres igen.
I praksis er det trin 3, der gør dette til en ingeniørproces og ikke til en layoutsession. En sidenote med et link til den konkrete fil, der beviser, at workeren forbruger fra køen, er verificerbar dokumentation; "jeg tror, den pil er omvendt" i en Slack-tråd er ikke.
Tjekliste: 10 kontroller, før du merger et AI-genereret diagram
Lukket liste, tænkt til at blive indsat i pull request-skabelonen. Hvis en enkelt fejler, kommer diagrammet ikke ind.
- Unikhed: ingen rigtig komponent optræder som to noder. Ét ID pr. service, repositoriets eller deploymentets navn.
- Komplette beslutninger: hver rombe har mindst to udgående kanter, med labels, og fejlgrenen har en destination.
- Terminatorer: hver sti slutter i en eksplicit slutnode; der er ingen kæder, der afbrydes midt i et procestrin.
- Dataretning: hver pil går i den retning, informationen bevæger sig, ikke i organisationshierarkiets. Tjek især køer, webhooks og polling.
- Opdelte lagre: ingen generiske kasser som "Database", "Services" eller "Infrastruktur". Én node pr. lager med teknologi og indhold.
- Rigtige lag: hver
subgraphsvarer til en grænse, der findes (et deployment, et repositorium, en konto, et netværk), ikke til en lærebogsabstraktion. - Domænets vokabular: labels bruger de navne, teamet skriver i koden og i tickets, ikke ordene fra din prompt.
- Ingen forældreløse noder eller undgåelige krydsninger: ingen frakoblede noder, og de krydsninger, der er tilbage, er begrundede og kan ikke fjernes ved at omordne.
- Læsbart i den størrelse, det udgives i: det kan forstås i bredden af
READMEeller dokumentationsportalen, ikke kun med zoom. - Sporbarhed: hvert ikke-oplagt element har en note med link til koden, ticketen eller den ADR, der understøtter det; og
.mmdi repositoriet er den, der er eksporteret efter rettelsen.
Spec-driven development: hvis diagrammet er forkert, arver koden fejlen
Det er grunden til, at auditering holdt op med at være kosmetisk i 2026. I specifikationsdrevet udvikling er specifikationen i Markdown — med sine Mermaid-diagrammer af arkitektur og sekvens — det artefakt, som agenten genererer implementeringen ud fra, ikke en kommentar til den. Et forkert diagram i den specifikation er ikke længere forældet dokumentation: det er et fejlbehæftet input til en kodegenerator.
Tankegangen er beskrevet i GitHubs eget Spec Kit, hvis tese er, at "specifikationer tjener ikke koden; koden tjener specifikationerne", og de implementeringsplaner, det producerer, indeholder arkitektur- og sekvensdiagrammer i Mermaid ved siden af datamodellen og fejltilstandene.
Oversat til hverdagen: en rombe uden "nej"-gren i specifikationen er med stor sandsynlighed et fejltilfælde, der ikke er implementeret i den genererede kode. En omvendt pil mellem API og kø er et push-design, hvor du ville have pull. Og en "Database"-kasse, der dækkede over Postgres, Redis og S3, bliver til ét enkelt repositorium med tre ansvarsområder. Diagrammet gik fra at være et billede af systemet til at være en del af tegningen, og tegninger gennemgås.
Ofte stillede spørgsmål
Hvad betyder "Mermaid slop"?
Det er et AI-genereret diagram med gyldig Mermaid-syntaks, men uden kommunikativ værdi: generiske og identiske former, standardpalet, forkert mærkede pile og i de værste tilfælde komponenter eller relationer, der ikke findes i systemet. Udtrykket blev udbredt via projektet Diagram Design og er dokumenteret i explainX' gennemgang fra august 2026.
Kan man validere et AI-genereret Mermaid-diagram automatisk?
Kun delvist. En linter eller selve parseren opdager syntaksfejl, og man kan automatisere strukturelle kontroller: forældreløse noder, romber med kun én udgang, stier uden terminator eller ID'er med mistænkeligt ensartede labels. Det, intet værktøj kan verificere alene, er, om diagrammet beskriver dit system; det kræver, at det krydstjekkes med koden, og derfor blander tjeklisten i denne artikel automatiserbare kontroller med menneskelig gennemgang.
Hvorfor er det ikke nok at gennemgå mermaid-blokken i pull requesten?
Fordi du i diff'en læser kanter én ad gangen, og de relevante fejl ligger i hele grafen: krydsninger, omvendte hierarkier, cyklusser, isolerede noder, ulæselig tæthed. Desuden vurderer du, når du læser teksten, forfatterens hensigt og ikke det, læseren vil se i renderingen. Den nyttige gennemgang sker på det tegnede diagram.
Hvilket værktøj bruger jeg til at rette et Mermaid-diagram manuelt?
Du har brug for et lærred, der klarer hele turen: importere .mmd, lade dig flytte rundt på og skifte former og konnektorer, annotere elementer og eksportere til Mermaid igen. Det sidste trin er det, de fleste viewere springer over, fordi de renderer, men ikke returnerer den rettede kode. FlowBoard dækker cyklussen: det importerer Mermaid fra en fil eller ved indsættelse af koden, fordeler diagrammet på et uendeligt lærred med zoom og panorering, lader dig rette former, konnektorer og forankringer manuelt med magnetisme mod forankringspunkterne, tilføje sidenoter med links pr. element og eksportere tilbage til Mermaid.
Hvor lang tid tager det at auditere et AI-genereret diagram?
Det afhænger af størrelsen, men størrelsesordenen for et diagram med 15-25 noder er 20 til 40 minutter første gang, og betydeligt mindre, når teamet har internaliseret tjeklisten og har fastlagt domænenavnene. Sammenlignet med prisen for, at en forkert arkitektur havner i den officielle dokumentation — eller, i et specifikationsdrevet flow, i den genererede kode — er det billigt.
Skal man holde op med at bruge AI til at lave diagrammer?
Nej. At generere det første udkast med en agent sparer det kedelige arbejde med at taste noder og kanter, og til at udforske et ukendt system er det nyttigt. Det, man ikke må springe over, er det næste trin: intet AI-genereret diagram udgives uden at have været igennem lærredet og tjeklisten. AI'en laver udkastet; ansvaret for diagrammet ligger stadig hos det team, der skriver under på det.
Afslutning: det diagram, du udgiver, er det, du har auditeret
Ændringen i 2026 er ikke, at AI tegner diagrammer, men at den tegner dem hurtigere, end vi gennemgår dem. Mens VS Code tegner dem uden konfiguration, Claude forvandler dem til boards, og Markdown-specifikationer fodrer kodegeneratorer, er den eneste kvalitetskontrol, der er tilbage, den menneskelige: at se på formen, markere det, der ikke kan bevises, og levere den rettede version tilbage til repositoriet. Ti kontroller og en cyklus, der lukker, er nok til, at et diagram igen bliver pålidelig dokumentation i stedet for plausibel dekoration.
Den cyklus har brug for et sted at foregå. Hos AIsToHire løser vi det med FlowBoard, vores uendelige whiteboard til diagrammer: agentens .mmd indsættes eller importeres, fordeles på et uendeligt canvas, former omplaceres — rektangler, ellipser, beslutningsromber, dokumenter, sticky notes og tekst — og konnektorer med lige eller ortogonale pile, hver forbindelse forankres med magnetisme til elementernes punkter, det tvivlsomme annoteres med sidenoter og verifikationslinks, og det eksporteres tilbage til Mermaid. Boardet gemmer sig selv, så auditten registreres og kan genoptages.
Åbn FlowBoard, indsæt den .mmd, agenten gav dig, og gennemgå diagrammet dér, hvor man virkelig kan se det: omordn efter lag, ret former og konnektorer manuelt, annoter det tvivlsomme med verifikationslinks og eksportér det tilbage til Mermaid. Start dit første board gratis.
Åbn FlowBoard, indsæt den .mmd, agenten gav dig, og gennemgå diagrammet dér, hvor man virkelig kan se det: omordn efter lag, ret former og konnektorer manuelt, annoter det tvivlsomme med verifikationslinks og eksportér det tilbage til Mermaid. Start dit første board gratis.Læs videre
Se alle artikler →
Rutediagramsymboler: hvad de betyder, og hvordan du tegner dit eget trin for trin

At skændes på WhatsApp eller tale om det i person: hvad videnskaben siger om parkonflikter via beskeder

Mindmap, begrebskort og disposition: forskelle og hvornår du bruger hvert af dem
