 FlowBoard
Mermaid slop: så granskar och rättar du diagrammen som AI genererar åt dig innan du publicerar dem
Teamet på FlowBoardSkriven med AI-stöd14 min läsningSammanfattning:
- "Mermaid slop" är namnet som har blivit populärt under 2026 för AI-genererade diagram som är giltiga i syntaxen men oläsliga eller rent av felaktiga; termen kommer från projektet Diagram Design, som presenterade sig med devisen "no Figma, no generic rounded boxes, no Mermaid-slop" och som redan hade över 11 000 stjärnor på GitHub i augusti 2026 (explainX, 16 augusti 2026).
- Problemet växte med spridningen: VS Code 1.121 (20 maj 2026) renderar Mermaid inbyggt i förhandsvisningen av Markdown, utan tillägg, och assistenterna genererar det som standard (Visual Studio Code).
- En modell optimerar grammatisk giltighet, inte systemets korrekthet:
.mmd-filen tolkas, men dubblerar noder, glömmer "nej"-grenen i ett beslut eller vänder datats riktning. - Att granska ett diagram genom att läsa
-->-rader fungerar inte: de fel som spelar roll är topologiska och syns bara när diagrammet är ritat. - Cykeln som fungerar: importera
.mmdtill en duk, ordna om i lager, kommentera det tvivelaktiga med en länk till koden eller ärendet som bevisar det, rätta för hand och exportera tillbaka så att den korrigerade versionen är den som hamnar i repot.
Sedan mitten av 2026 är frågan i ingenjörsteam inte längre hur man genererar ett diagram, utan vem som svarar för det. Agenterna skriver Mermaid i farten, GitHub och VS Code ritar det utan konfiguration och resultatet hamnar i README lika naturligt som ett kodblock. Det som saknas är granskningslagret. Den här artikeln går igenom de typiska felen, den tekniska orsaken till att de uppstår och en reproducerbar granskningscykel som avslutas på en visuell duk – i vårt fall FlowBoard, AIsToHires oändliga whiteboard för diagram, som importerar och exporterar Mermaid igen – så att diagrammet som publiceras är det korrigerade och inte det första som modellen spydde ur sig.
Vad är "Mermaid slop" egentligen?
Mermaid slop är ett AI-genererat diagram som kompilerar utan fel och ändå är oanvändbart: identiska rundade rutor för olika begrepp, pilar utan etikett eller med vaga etiketter, standardfärger som inte säger något och en reflexmässig generering – det ritas för att någon bad om det, inte för att det behövs. Definitionen fastställs av explainX-genomgången av termen (16 augusti 2026), som spårar den till projektet Diagram Design av Cathryn Lavery.
Den viktiga nyansen är att det finns två lager av "slop" och att de ofta förväxlas:
| Lager | Vad som brister | Hur det upptäcks | Kostnad att åtgärda |
|---|---|---|---|
| Estetiskt | Generiska former, standardpalett, allt lika | Med blotta ögat | Låg: tema, former, gruppering |
| Semantiskt | Diagrammet beskriver ett system som inte finns | Bara genom jämförelse med den verkliga koden | Hög: man måste öppna repot igen |
Den offentliga diskussionen 2026 har nästan helt kretsat kring det första. Verktygen som har dykt upp – från skills för redaktionell diagramritning till generatorer som skapar inbyggda Excalidraw-element i stället för Mermaid-text – angriper framför allt utseendet. Det andra lagret, det som får ett diagram att ljuga om din arkitektur, är fortfarande mänskligt arbete.
Varför ger en LLM Mermaid som är perfekt i syntax men svagt i semantik?
Därför att det är två olika mål och bara det ena har rikliga träningssignaler. Mermaids grammatik är sluten, liten och massivt representerad på GitHub: en modell återger den nästan utan fel. Diagrammets korrekthet beror däremot på ett konkret system som modellen oftast inte har läst i sin helhet, så den fyller luckorna med den vanligaste formen av ett arkitekturdiagram, inte med din.
Till det kommer tre praktiska effekter:
- Prompten är den enda källan. Om du beskriver systemet i tre meningar ger agenten tillbaka ett diagram med tre meningars detaljnivå och pyntar det tills det ser komplett ut. Som Mermaid självt sammanfattar när det talar om vibe diagramming: "ett diagram som genereras utifrån en vag prompt kommer att spegla promptens vaghet" (Mermaid, 24 mars 2026).
- Det finns ingen semantisk kompilator. Ett rött test varnar dig; ett felaktigt diagram renderas lika snyggt som ett korrekt. Det finns ingen motsvarighet till
tscför "den här tjänsten finns inte". - Layouten bestäms av motorn, inte av författaren. Mermaid placerar noderna med sin algoritm och erbjuder inget bekvämt sätt att rätta placeringen efter renderingen. Om den verkliga hierarkin inte stämmer med det som auto-layouten ritar förlorar du diskussionen med verktyget.
Och branschens sammanhang visar att verifiering inte är valfritt. Stack Overflows utvecklarundersökning 2026 (publicerad den 6 oktober 2026, över 30 000 svar i 169 länder) visade att ungefär hälften litar på AI:ns resultat bara när de enkelt kan verifiera det, och att knappt 6,6 % skulle godta det för viktiga beslut. Ett arkitekturdiagram i den officiella dokumentationen är, nästan per definition, ett viktigt beslut.
De sju återkommande felen i ett AI-genererat diagram
Det här är de sju som dyker upp gång på gång när man granskar .mmd-filer genererade av agenter. Alla tolkas; alla är fel. Det gemensamma mönstret är att modellen fyller i trovärdig struktur där den saknar domänkunskap.
| # | Fel | Symptom i .mmd | Konsekvens |
|---|---|---|---|
| 1 | Dubblerade noder | Två olika ID:n med liknande etiketter för samma tjänst | Det ser ut som två komponenter där det finns en |
| 2 | Beslut utan "nej"-gren | En romb med bara en utgående kant | Felvägen blir odokumenterad |
| 3 | Flöde utan avslut | Kedjor som slutar i en processnod | Man vet inte när användningsfallet tar slut |
| 4 | Omvänd riktning | Pilen pekar mot datats ursprung | Det blir fel vem som anropar vem |
| 5 | Generisk ruta | En enda nod "Databas" | Döljer tre lager med olika garantier |
| 6 | Falskt djup | Nivåer eller subgraph som inte finns i koden | Ger auktoritet åt en påhittad arkitektur |
| 7 | Etiketter från prompten | Noderna upprepar dina ord, inte domänens vokabulär | Diagrammet går inte att söka i eller känna igen |
1. Dubblerade noder som är samma tjänst
Modellen har sett "auth" och "autentiseringstjänst" i två olika meningar och har skapat två noder.
flowchart LR
  API[API Gateway] --> AUTH[Auth]
  API --> AUTHSVC[Servicio de autenticacion]
  AUTH --> DB[(Base de datos)]
  AUTHSVC --> DB
Rättat: en nod, ett ID, det namn som teamet använder.
flowchart LR
  API[API Gateway] --> AUTH[auth-service]
  AUTH --> USERS[(postgres: users)]
2. Beslut utan "nej"-gren
flowchart TD
  REQ[Peticion] --> Q{Token valido?}
  Q -->|Si| OK[Procesar]
En romb med bara en utgång är inget beslut: det är en prydnad. Varje villkor behöver sina två vägar och felvägen behöver ett mål.
flowchart TD
  REQ[Peticion] --> Q{Token valido?}
  Q -->|si| OK[Procesar]
  Q -->|no| R401[Responder 401]
  OK --> FIN([Fin])
  R401 --> FIN
3. Pilar som vänder datats riktning
Klassiskt med köer och webhooks: modellen ritar den organisatoriska hierarkin i stället för det verkliga flödet.
flowchart LR
  WORKER[Worker] --> QUEUE[Cola de trabajos]
Workern skickar inte till kön: den konsumerar från den. Att rita den här riktningen fel förvandlar en pull-design till en push-design, vilket är ett annat system med andra garantier.
flowchart LR
  API[API] -->|encola| QUEUE[Cola de trabajos]
  QUEUE -->|consume| WORKER[Worker]
4. Den generiska rutan "Databas"
Det är det dyraste felet, eftersom just den information som någon öppnar diagrammet för försvinner. En nod [(Base de datos)] som i verkligheten är Postgres för transaktioner, Redis för sessioner och S3 för bilagor dokumenterar inte: den döljer. Den praktiska regeln: om två lager har olika hållbarhetsgarantier är de två noder.
5, 6 och 7: påhittade nivåer och lånade etiketter
subgraph som heter "Presentationslager", "Affärslager" och "Datalager" är oftast modellens mentala mall, inte strukturen i ditt repo. Likadant med etiketterna: om noden heter "modul för betalningshantering" och i koden är billing-worker kan ingen korsreferera diagrammet med projektet. Och om avslutet saknas vet läsaren inte om flödet tar slut där eller om modellen stannade halvvägs.
Varför fungerar det inte att granska ett diagram som text?
Därför att de fel som spelar roll är topologiska och texten visar dem inte. När du läser en lista med A --> B-rader kan du verifiera att varje kant är trolig, en i taget, men du ser inte att två pilar korsar varandra, att en nod blivit föräldralös, att hierarkin är omvänd eller att det finns en cykel på tre steg. De egenskaperna syns bara när grafen är ritad och placerad.
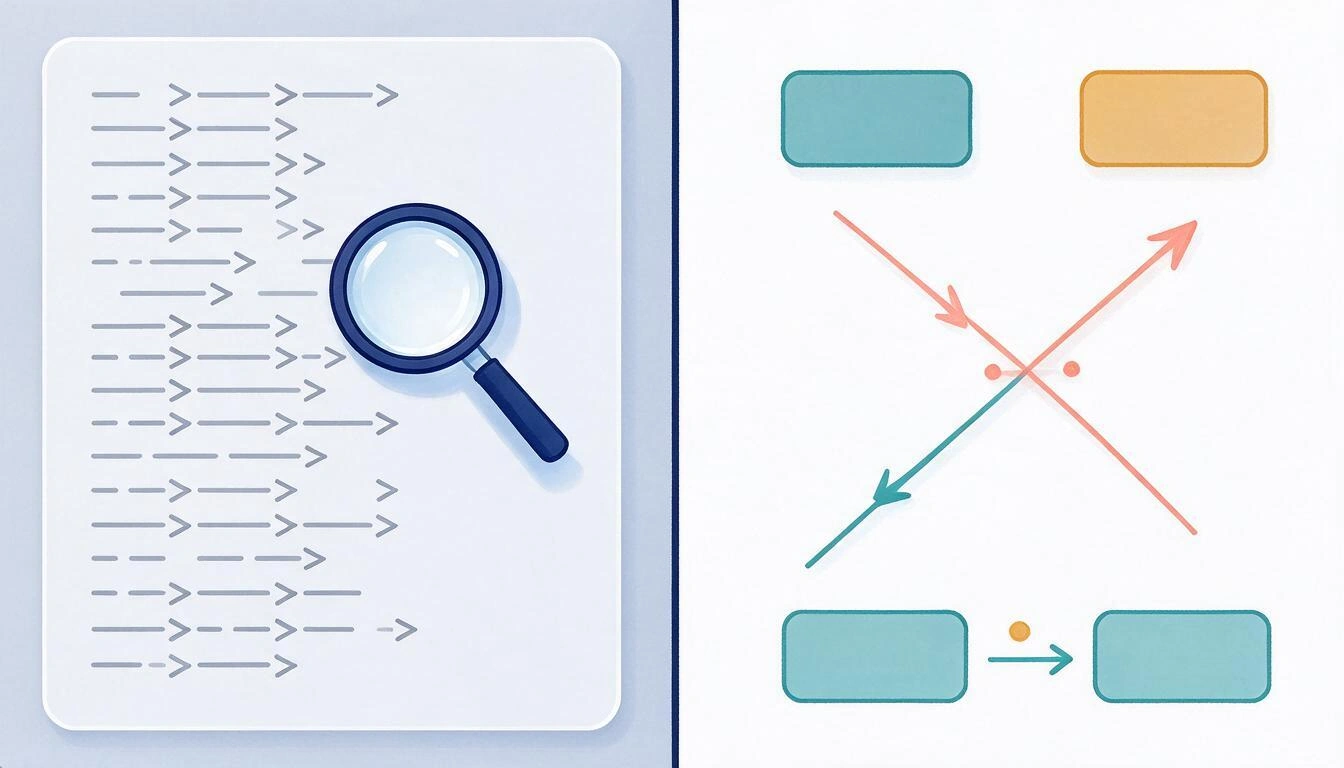
Det finns en andra, subtilare orsak: när du läser .mmd granskar du det som författaren skrev; när du tittar på renderingen granskar du det som läsaren kommer att förstå. Det är olika saker. Ett diagram med femton korrekta kanter och en auto-layout som trycker ihop dem är tekniskt rätt och kommunikativt trasigt, och det är precis det som en granskare av en pull request godkänner utan att titta eftersom "mermaid-blocket är välformerat".
Branschen själv har rört sig i den riktningen. Anthropic lanserade Claude Whiteboards i beta den 10 november 2026: en duk i realtid där assistenten förvandlar en diskussion till en tavla, grupperar anteckningar efter tema och låter dig sedan ta den vidare till Lucid, Miro eller Zohos Vani (unite.ai). Och Miro förklarade vid sitt evenemang Canvas 26 att det inte längre "är i whiteboardbranschen" och att det vill vara "det samarbetsinriktade beslutslagret för det agentiska företaget" (Forrester, 1 juni 2026). AI:ns naturliga utdata håller på att bli duken, inte textblocket. För den som granskar diagram är det goda nyheter: granskningen hör hemma där formen syns.
Granskningscykeln: från .mmd till duken och tillbaka till .mmd
Cykeln har fem steg och dess nyckelegenskap är att den sluts: det som hamnar i repot är diagrammet korrigerat på duken, inte agentens original. Om rättelsen stannar i en skärmdump eller i en kommentar på pull requesten överlever den felaktiga .mmd och matar nästa agent igen.
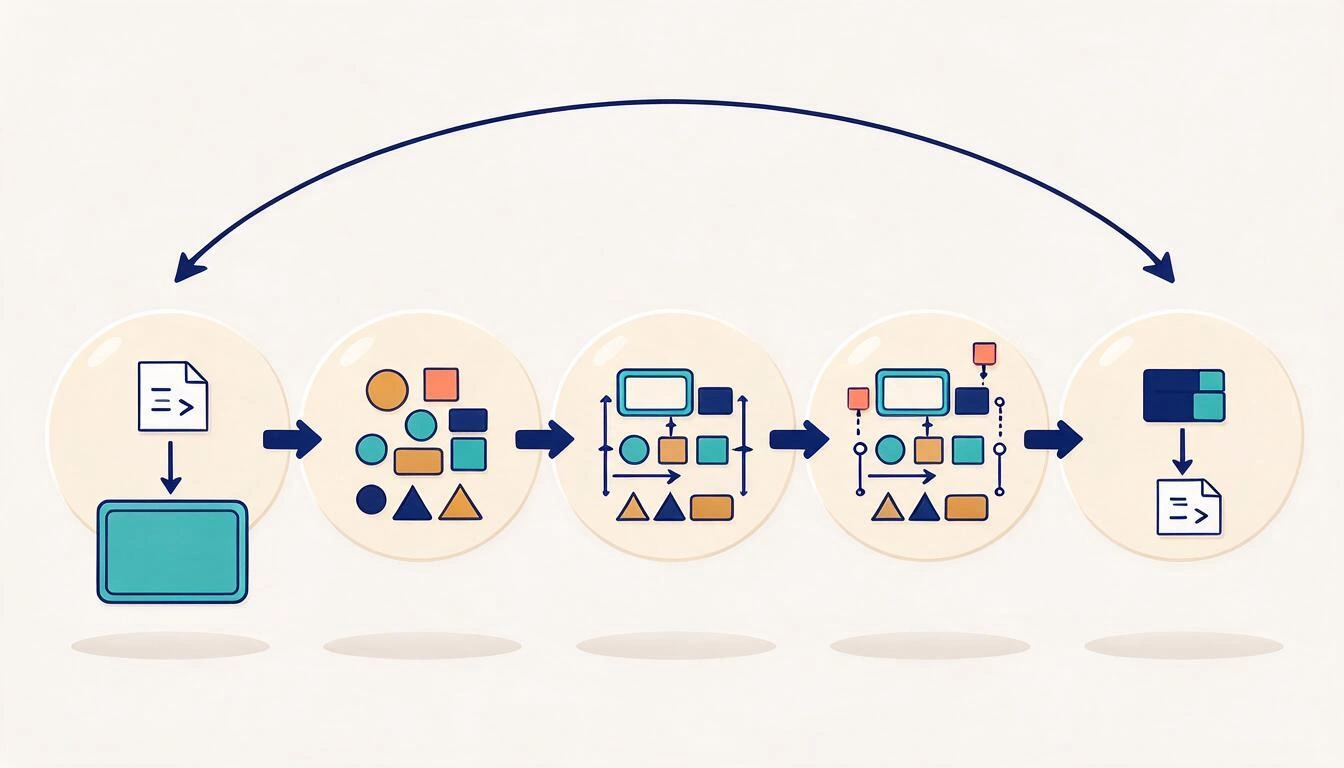
- Importera. Klistra in
.mmdsom agenten gav dig i en visuell duk, eller ladda den som fil. Mål: att skilja granskningen från kodredigeraren, där frestelsen är att läsa i stället för att titta. - Fördela och ordna om. Placera noderna i horisontella lager efter ansvar (ingång, orkestrering, domän, lagring). Nästan alla riktningsfel och fel med falskt djup avslöjas här: en pil som går upp två lager är oftast en omvänd pil.
- Markera det tvivelaktiga. Varje nod eller koppling som du inte kan bekräfta genom att läsa koden får en anteckning, och anteckningen innehåller en länk till beviset: filen, ärendet, ADR:n. Ett granskat diagram är inte ett utan tvivel, det är ett där tvivlen är märkta och spårade.
- Rätta för hand. Slå ihop dubblerade noder, dela den generiska rutan i de verkliga lagren, lägg till "nej"-grenen, avsluta med en terminator, byt formtyp så att en romb är en romb och ett lager är en cylinder, och förankra kopplingarna på rätt punkter igen.
- Exportera tillbaka. Exportera resultatet till
.mmdoch ersätt originalfilen i repot, i samma commit som granskningen. Det är steget som de flesta team hoppar över och som hindrar felet från att komma tillbaka.
I praktiken är det steg 3 som gör detta till en ingenjörsprocess och inte en layoutövning. En sidoanteckning med en länk till just den fil som bevisar att workern konsumerar från kön är verifierbar dokumentation; "jag tror att den här pilen är åt fel håll" i en Slack-tråd är det inte.
Checklista: 10 kontroller innan du mergar ett AI-genererat diagram
En sluten lista, tänkt att klistras in i mallen för pull requests. Om någon punkt brister kommer diagrammet inte in.
- Unikhet: ingen verklig komponent förekommer som två noder. Ett ID per tjänst, med namnet från repot eller driftsättningen.
- Kompletta beslut: varje romb har minst två utgående kanter, etiketterade, och felgrenen har ett mål.
- Terminatorer: varje väg slutar i en uttrycklig slutnod; inga kedjor tar slut i ett processteg.
- Datats riktning: varje pil går i den riktning som informationen färdas, inte i den organisatoriska hierarkins. Kontrollera särskilt köer, webhooks och polling.
- Uppdelade lager: ingen generisk ruta av typen "Databas", "Tjänster" eller "Infrastruktur". En nod per lager med teknik och innehåll.
- Verkliga nivåer: varje
subgraphmotsvarar en gräns som finns (en driftsättning, ett repo, ett konto, ett nätverk), inte en lärobokabstraktion. - Domänens vokabulär: etiketterna använder de namn som teamet skriver i koden och i ärendena, inte orden från din prompt.
- Inga föräldralösa noder eller undvikbara korsningar: ingen nod är frånkopplad, och de korsningar som finns kvar är motiverade och kan inte lösas genom omordning.
- Läsbart i den storlek där det publiceras: det förstås i bredden på
READMEeller dokumentationsportalen, inte bara med zoom. - Spårbarhet: varje icke självklart element har en anteckning med en länk till koden, ärendet eller ADR:n som stöder det; och
.mmdi repot är den som exporterats efter rättelsen.
Spec-driven development: om diagrammet är fel ärver koden felet
Det här är anledningen till att granskningen slutade vara kosmetisk 2026. I specifikationsdriven utveckling är specifikationen i Markdown – med sina Mermaid-diagram för arkitektur och sekvens – den artefakt som agenten genererar implementationen utifrån, inte en kommentar om den. Ett felaktigt diagram i den specifikationen är inte längre inaktuell dokumentation: det är en felaktig indata till en kodgenerator.
Upplägget återges i GitHubs Spec Kit självt, vars tes är att "specifikationer tjänar inte koden; koden tjänar specifikationerna", och de implementationsplaner det producerar innehåller arkitektur- och sekvensdiagram i Mermaid vid sidan av datamodellen och felmoderna.
Översatt till vardagen: en romb utan "nej"-gren i specifikationen är med stor sannolikhet ett felfall som inte implementerats i den genererade koden. En omvänd pil mellan API och kö är en push-design där du ville ha pull. Och en ruta "Databas" som dolde Postgres, Redis och S3 blir ett enda repository med tre ansvarsområden. Diagrammet gick från att vara en bild av systemet till att vara en del av ritningen, och ritningar granskas.
Vanliga frågor
Vad betyder "Mermaid slop"?
Det är ett AI-genererat diagram med giltig Mermaid-syntax men utan kommunikativt värde: generiska och identiska former, standardpalett, felaktigt etiketterade pilar och, i de värsta fallen, komponenter eller relationer som inte finns i systemet. Termen blev populär genom projektet Diagram Design och dokumenteras i explainX-genomgången från augusti 2026.
Går det att validera ett AI-genererat Mermaid-diagram automatiskt?
Bara delvis. En linter eller själva parsern upptäcker syntaxfel, och strukturella kontroller kan automatiseras: föräldralösa noder, romber med bara en utgång, vägar utan terminator eller ID:n med misstänkt lika etiketter. Det som inget verktyg kan verifiera på egen hand är om diagrammet beskriver ditt system; det kräver att man korsrefererar det med koden, och därför blandar checklistan i den här artikeln automatiserbara kontroller med mänsklig granskning.
Varför räcker det inte att granska mermaid-blocket i pull requesten?
Därför att du i diffen läser kanter en och en, och de relevanta felen gäller hela grafen: korsningar, omvända hierarkier, cykler, isolerade noder, oläslig täthet. Dessutom bedömer du när du läser texten författarens avsikt och inte det som läsaren av renderingen kommer att se. Den användbara granskningen görs på det ritade diagrammet.
Vilket verktyg använder jag för att rätta ett Mermaid-diagram för hand?
Du behöver en duk som klarar hela resan: importera .mmd, låta dig flytta runt och ändra former och kopplingar, kommentera element och exportera till Mermaid igen. Det sista steget är det som de flesta visare saknar: de renderar men ger inte tillbaka den korrigerade koden. FlowBoard täcker cykeln: importerar Mermaid från fil eller genom att du klistrar in koden, fördelar diagrammet på en oändlig duk med zoom och panorering, låter dig rätta former, kopplingar och förankringar för hand med magnetism mot förankringspunkterna, lägga till sidoanteckningar med länkar per element och exportera tillbaka till Mermaid.
Hur lång tid tar det att granska ett AI-genererat diagram?
Det beror på storleken, men storleksordningen för ett diagram med 15–25 noder är 20 till 40 minuter första gången, och betydligt mindre när teamet redan har internaliserat checklistan och fastställt domänens namn. Jämfört med kostnaden för att en felaktig arkitektur kommer in i den officiella dokumentationen – eller, i ett specifikationsdrivet flöde, i den genererade koden – är det billigt.
Måste man sluta använda AI för att göra diagram?
Nej. Att generera det första utkastet med en agent sparar det tråkiga arbetet med att skriva noder och kanter, och för att utforska ett okänt system är det användbart. Det man inte får hoppa över är nästa steg: inget AI-genererat diagram publiceras utan att passera duken och checklistan. AI:n gör utkastet; ansvaret för diagrammet ligger kvar hos teamet som skriver under det.
Avslutning: diagrammet du publicerar är det du har granskat
Förändringen 2026 är inte att AI ritar diagram, utan att den ritar dem snabbare än vi granskar dem. Medan VS Code ritar dem utan konfiguration, Claude förvandlar dem till tavlor och specifikationer i Markdown matar kodgeneratorer är den enda kvalitetskontroll som återstår den mänskliga: att titta på formen, markera det som inte kan bevisas och lämna tillbaka den korrigerade versionen till repot. Tio kontroller och en cykel som sluts räcker för att ett diagram åter ska vara tillförlitlig dokumentation i stället för trovärdig dekoration.
Den cykeln behöver en plats att äga rum på. På AIsToHire löser vi det med FlowBoard, vår oändliga whiteboard för diagram: du klistrar in eller importerar agentens .mmd, fördelar den på en oändlig canvas, placerar om former – rektanglar, ellipser, beslutsromber, dokument, klisterlappar och text – och kopplingar med raka eller ortogonala pilar, förankrar varje koppling med magnetism mot elementens punkter, kommenterar det tvivelaktiga med sidoanteckningar och verifieringslänkar, och exporterar tillbaka till Mermaid. Tavlan sparas automatiskt, så granskningen blir registrerad och kan återupptas.
Öppna FlowBoard, klistra in .mmd som agenten gav dig och granska diagrammet där det verkligen syns: ordna om i lager, rätta former och kopplingar för hand, kommentera det tvivelaktiga med verifieringslänkar och exportera tillbaka till Mermaid. Börja din första tavla gratis.
Öppna FlowBoard, klistra in .mmd som agenten gav dig och granska diagrammet där det verkligen syns: ordna om i lager, rätta former och kopplingar för hand, kommentera det tvivelaktiga med verifieringslänkar och exportera tillbaka till Mermaid. Börja din första tavla gratis.Läs vidare
Visa alla inlägg →
Flödesschemats symboler: vad varje symbol betyder och hur du ritar ditt eget steg för steg

Bråka på WhatsApp eller prata ut personligen: vad vetenskapen säger om parkonflikter via meddelanden

Tankekarta, begreppskarta och disposition: skillnader och när du använder vilken
