 FlowBoard
Mermaid slop: zo controleer en corrigeer je de diagrammen die AI voor je genereert voordat je ze publiceert
Team van FlowBoardGeschreven met AI-ondersteuning15 min. leestijdKort samengevat:
- "Mermaid slop" is de naam die in 2026 populair is geworden voor door AI gegenereerde diagrammen die syntactisch geldig zijn maar onleesbaar of regelrecht onjuist; de term kwam uit het project Diagram Design, dat zich presenteerde met de slogan "no Figma, no generic rounded boxes, no Mermaid-slop" en in augustus 2026 al meer dan 11.000 sterren op GitHub had (explainX, 16 augustus 2026).
- Het probleem groeide door de verspreiding: VS Code 1.121 (20 mei 2026) rendert Mermaid native in de Markdown-voorvertoning, zonder extensie, en assistenten genereren het standaard (Visual Studio Code).
- Een model optimaliseert grammaticale geldigheid, niet de correctheid van het systeem: de
.mmdwordt geparsed, maar dupliceert knooppunten, laat de "nee"-tak van een beslissing weg of keert de richting van de data om. - Een diagram nakijken door regels met
-->te lezen werkt niet: de gebreken die ertoe doen zijn topologisch en zie je alleen als het getekend is. - De cyclus die wél werkt: de
.mmdimporteren in een canvas, per laag herordenen, het twijfelachtige annoteren met een link naar de code of het ticket dat het bewijst, met de hand corrigeren en opnieuw exporteren zodat de gecorrigeerde versie degene is die in de repository belandt.
Sinds medio 2026 is de vraag in engineeringteams niet meer hoe je een diagram genereert, maar wie ervoor verantwoordelijk is. Agents schrijven Mermaid on the fly, GitHub en VS Code tonen het zonder configuratie en het resultaat belandt in de README zo vanzelfsprekend als een codeblok. Wat ontbreekt is de auditlaag. Dit artikel loopt de typische gebreken langs, de technische reden waarom ze ontstaan en een reproduceerbare reviewcyclus die afgesloten wordt in een visueel canvas —in ons geval FlowBoard, het oneindige whiteboard voor diagrammen van AIsToHire, dat Mermaid importeert en weer exporteert— zodat het diagram dat wordt gepubliceerd het gecorrigeerde is en niet het eerste dat het model uitspuugde.
Wat is "Mermaid slop" precies?
Mermaid slop is een door AI gegenereerd diagram dat foutloos compileert en toch niet bruikbaar is: identieke afgeronde vakjes voor verschillende concepten, pijlen zonder label of met vage labels, standaardkleuren die niets zeggen en een reflexmatige generatie —het wordt getekend omdat erom gevraagd werd, niet omdat het nodig is—. De definitie wordt vastgelegd door de bespreking van explainX over de term (16 augustus 2026), die hem terugvoert op het project Diagram Design van Cathryn Lavery.
De belangrijke nuance is dat er twee lagen "slop" zijn en dat ze vaak door elkaar worden gehaald:
| Laag | Wat faalt | Hoe je het ontdekt | Kosten om het te herstellen |
|---|---|---|---|
| Esthetisch | Generieke vormen, standaardpalet, alles hetzelfde | Met één oogopslag | Laag: thema, vormen, groepering |
| Semantisch | Het diagram beschrijft een systeem dat niet bestaat | Alleen door te vergelijken met de echte code | Hoog: je moet de repository opnieuw openen |
Het publieke gesprek van 2026 heeft zich bijna helemaal op de eerste gericht. De tools die zijn verschenen —van skills voor redactioneel diagrammen tot generatoren die native Excalidraw-elementen produceren in plaats van Mermaid-tekst— richten zich vooral op het uiterlijk. De tweede laag, die waardoor een diagram liegt over jouw architectuur, blijft mensenwerk.
Waarom produceert een LLM Mermaid dat syntactisch perfect en semantisch zwak is?
Omdat het twee verschillende doelen zijn en slechts één ervan overvloedig trainingssignaal heeft. De grammatica van Mermaid is gesloten, klein en massaal vertegenwoordigd op GitHub: een model reproduceert haar bijna zonder fouten. De correctheid van het diagram hangt daarentegen af van een concreet systeem dat het model normaal gesproken niet helemaal heeft gelezen, dus het vult de gaten met de meest voorkomende vorm van een architectuurdiagram, niet met die van jou.
Daar komen drie praktische effecten bij:
- De prompt is de enige bron. Als je het systeem in drie zinnen beschrijft, geeft de agent een diagram terug met de granulariteit van drie zinnen en maakt het mooi tot het compleet lijkt. Zoals Mermaid zelf samenvat over vibe diagramming: "een diagram dat uit een vage prompt wordt gegenereerd, zal de vaagheid van de prompt weerspiegelen" (Mermaid, 24 maart 2026).
- Er is geen semantische compiler. Een rode test waarschuwt je; een onjuist diagram rendert even mooi als een juist. Er bestaat geen equivalent van
tscvoor "deze service bestaat niet". - De layout wordt bepaald door de engine, niet door de auteur. Mermaid plaatst de knooppunten met zijn algoritme en biedt geen handige manier om de indeling na het renderen te corrigeren. Als de echte hiërarchie niet overeenkomt met wat de auto-layout tekent, verlies je de discussie met de tool.
En de context van de sector zegt dat verificatie niet optioneel is. De Stack Overflow-ontwikkelaarsenquête 2026 (gepubliceerd op 6 oktober 2026, meer dan 30.000 antwoorden in 169 landen) vond dat bijna de helft de uitvoer van AI alleen vertrouwt als hij die gemakkelijk kan verifiëren, en dat slechts 6,6 % hem goed genoeg zou vinden voor belangrijke beslissingen. Een architectuurdiagram in de officiële documentatie is bijna per definitie een belangrijke beslissing.
De zeven terugkerende gebreken van een door AI gegenereerd diagram
Dit zijn de zeven die steeds terugkomen bij het auditen van .mmd-bestanden die door agents zijn gegenereerd. Allemaal parsen ze; allemaal zijn ze fout. Het gemeenschappelijke patroon is dat het model aannemelijke structuur invult waar het domeininformatie mist.
| # | Gebrek | Symptoom in de .mmd | Gevolg |
|---|---|---|---|
| 1 | Dubbele knooppunten | Twee verschillende ID's met vergelijkbare labels voor dezelfde service | Het lijkt alsof er twee componenten zijn waar er één is |
| 2 | Beslissing zonder "nee"-tak | Een ruit met maar één uitgaande lijn | Het foutpad blijft ongedocumenteerd |
| 3 | Flow zonder eindpunt | Ketens die eindigen in een procesknooppunt | Je weet niet wanneer de use case eindigt |
| 4 | Omgekeerde richting | De pijl wijst naar de oorsprong van de data | Wie wie aanroept wordt omgekeerd |
| 5 | Generiek vakje | Eén enkel knooppunt "Database" | Verbergt drie opslagplaatsen met verschillende garanties |
| 6 | Valse diepte | Lagen of subgraphs die niet in de code bestaan | Geeft gezag aan een verzonnen architectuur |
| 7 | Labels uit de prompt | De knooppunten herhalen jouw woorden, niet het domeinvocabulaire | Het diagram is niet doorzoekbaar of herkenbaar |
1. Dubbele knooppunten die dezelfde service zijn
Het model heeft "auth" en "authenticatieservice" in twee verschillende zinnen gezien en twee knooppunten gemaakt.
flowchart LR
  API[API Gateway] --> AUTH[Auth]
  API --> AUTHSVC[Authenticatieservice]
  AUTH --> DB[(Database)]
  AUTHSVC --> DB
Gecorrigeerd: één knooppunt, één ID, de naam die het team gebruikt.
flowchart LR
  API[API Gateway] --> AUTH[auth-service]
  AUTH --> USERS[(postgres: users)]
2. Beslissingen zonder "nee"-tak
flowchart TD
  REQ[Verzoek] --> Q{Token geldig?}
  Q -->|Ja| OK[Verwerken]
Een ruit met maar één uitgang is geen beslissing: het is een versiering. Elke voorwaarde heeft haar twee paden nodig en het foutpad heeft een bestemming nodig.
flowchart TD
  REQ[Verzoek] --> Q{Token geldig?}
  Q -->|ja| OK[Verwerken]
  Q -->|nee| R401[401 teruggeven]
  OK --> FIN([Einde])
  R401 --> FIN
3. Pijlen die de richting van de data omkeren
Klassiek bij wachtrijen en webhooks: het model tekent de organisatiehiërarchie in plaats van de echte flow.
flowchart LR
  WORKER[Worker] --> QUEUE[Jobwachtrij]
De worker duwt niet naar de wachtrij: hij consumeert eruit. Deze richting verkeerd tekenen maakt van een pull-ontwerp een push-ontwerp, en dat is een ander systeem met andere garanties.
flowchart LR
  API[API] -->|plaatst in wachtrij| QUEUE[Jobwachtrij]
  QUEUE -->|consumeert| WORKER[Worker]
4. Het generieke vakje "Database"
Dit is het duurste gebrek, omdat precies de informatie verdwijnt waarvoor iemand het diagram opent. Een knooppunt [(Database)] dat in werkelijkheid Postgres voor transacties, Redis voor sessies en S3 voor bijlagen is, documenteert niet: het verbergt. De praktische regel: als twee opslagplaatsen verschillende duurzaamheidsgaranties hebben, zijn het twee knooppunten.
5, 6 en 7: verzonnen lagen en geleende labels
De subgraphs met de namen "Presentatielaag", "Bedrijfslaag" en "Datalaag" zijn meestal een mentaal sjabloon van het model, geen structuur van jouw repository. Hetzelfde geldt voor labels: als het knooppunt "betalingsverwerkingsmodule" heet en in de code billing-worker is, kan niemand het diagram met het project kruisen. En als het eindpunt ontbreekt, weet de lezer niet of de flow daar eindigt of dat het model halverwege bleef steken.
Waarom werkt een diagram nakijken in tekst niet?
Omdat de gebreken die ertoe doen topologisch zijn en de tekst ze niet blootlegt. Door een lijst regels A --> B te lezen kun je controleren of elke lijn op zich aannemelijk is, maar je ziet niet dat twee pijlen elkaar kruisen, dat een knooppunt wees is gebleven, dat de hiërarchie omgekeerd is of dat er een cyclus van drie stappen is. Die eigenschappen zijn alleen zichtbaar als de graaf getekend en geplaatst is.
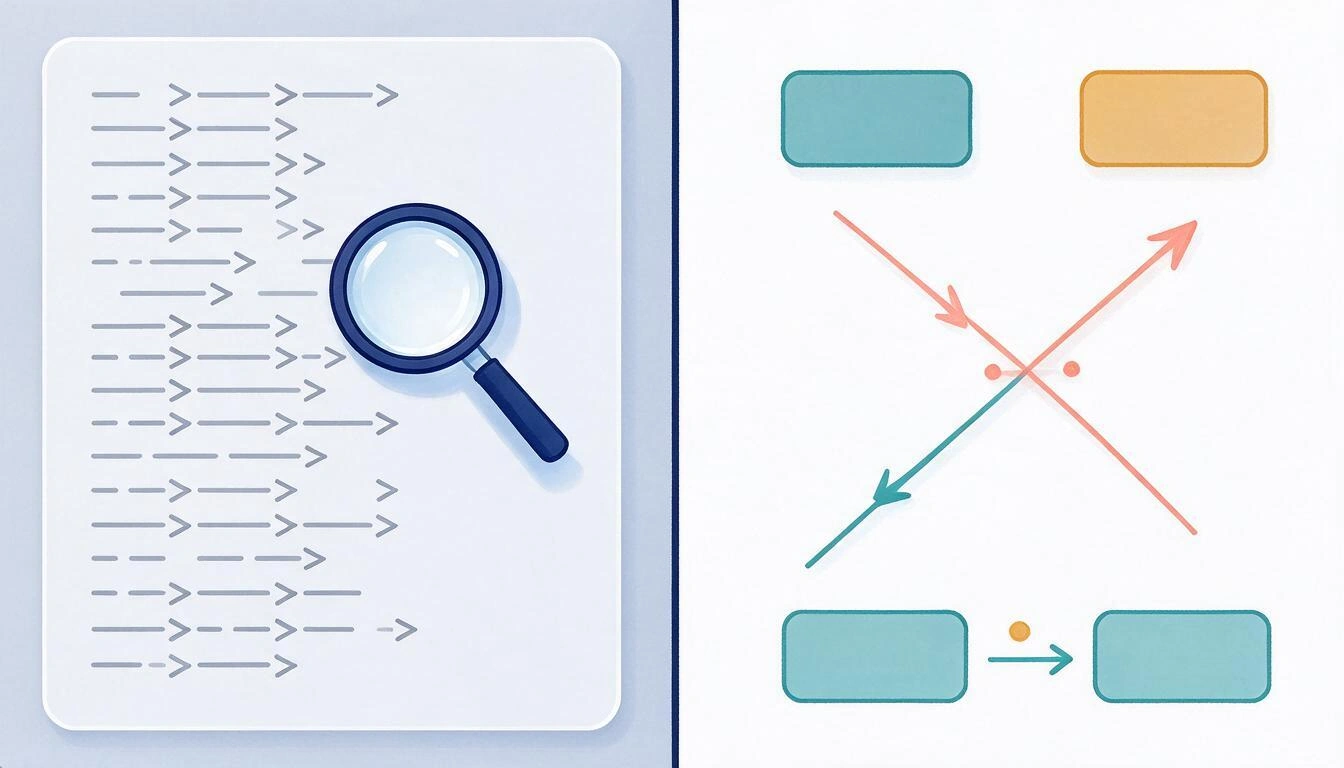
Er is een tweede, subtielere reden: als je de .mmd leest, beoordeel je wat de auteur heeft geschreven; als je naar de render kijkt, beoordeel je wat de lezer gaat begrijpen. Dat zijn verschillende dingen. Een diagram met vijftien correcte lijnen en een auto-layout die ze op elkaar stapelt is technisch in orde en communicatief kapot, en dat is precies wat een reviewer van een pull request goedkeurt zonder te kijken omdat "het mermaid-blok goed gevormd is".
De industrie zelf is die kant op gegaan. Anthropic lanceerde Claude Whiteboards in bèta op 10 november 2026: een realtime canvas waarin de assistent een discussie omzet in een bord, notities per thema groepeert en toelaat het daarna naar Lucid, Miro of Vani van Zoho te brengen (unite.ai). En Miro verklaarde op zijn evenement Canvas 26 dat het "niet meer in de whiteboardbusiness zit" en "de collaboratieve besluitvormingslaag voor de agentische onderneming" wil zijn (Forrester, 1 juni 2026). De natuurlijke uitvoer van AI wordt het canvas, niet het tekstblok. Voor wie diagrammen auditeert is dat goed nieuws: de review hoort thuis op de plek waar je de vorm ziet.
De reviewcyclus: van .mmd naar het canvas en terug naar .mmd
De cyclus heeft vijf stappen en zijn belangrijkste eigenschap is dat hij sluit: wat in de repository belandt is het in het canvas gecorrigeerde diagram, niet het origineel van de agent. Als de correctie blijft steken in een screenshot of in een opmerking bij de pull request, overleeft de foute .mmd en voedt hij de volgende agent weer.
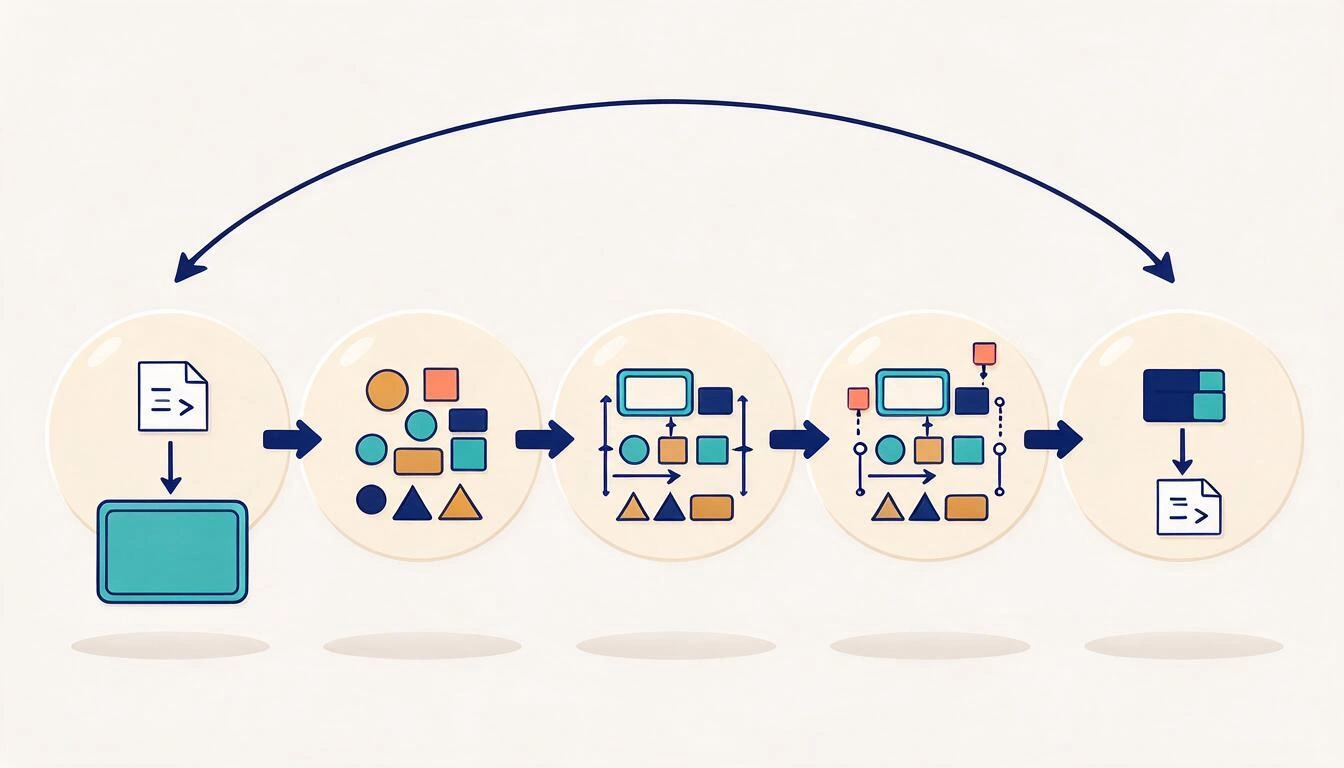
- Importeren. Plak de
.mmddie de agent je gaf in een visueel canvas, of laad hem als bestand. Doel: de review loskoppelen van de code-editor, waar de verleiding bestaat om te lezen in plaats van te kijken. - Verdelen en herordenen. Plaats de knooppunten in horizontale lagen per verantwoordelijkheid (invoer, orkestratie, domein, opslag). Bijna alle gebreken van richting en valse diepte verraden zich hier: een pijl die twee lagen omhoog gaat is meestal een omgekeerde pijl.
- Het twijfelachtige markeren. Elk knooppunt of elke connector die je niet kunt bevestigen door de code te lezen, wordt geannoteerd, en de annotatie bevat een link naar het bewijs: het bestand, het ticket, de ADR. Een geauditeerd diagram is geen diagram zonder twijfels, maar een waarin de twijfels gelabeld en getraceerd zijn.
- Met de hand corrigeren. Dubbele knooppunten samenvoegen, het generieke vakje splitsen in de echte opslagplaatsen, de "nee"-tak toevoegen, afsluiten met een eindpunt, het vormtype wijzigen zodat een ruit een ruit is en een opslag een cilinder, en de connectoren opnieuw verankeren op de juiste punten.
- Terug exporteren. Het resultaat naar
.mmddumpen en het oorspronkelijke bestand in de repository vervangen, in dezelfde commit als de review. Dat is de stap die de meeste teams overslaan en die voorkomt dat de fout opnieuw wordt geïntroduceerd.
In de praktijk is stap 3 degene die dit tot een engineeringproces maakt en niet tot een opmaaksessie. Een zijnotitie met een link naar het concrete bestand dat aantoont dat de worker uit de wachtrij consumeert is verifieerbare documentatie; "ik denk dat deze pijl omgekeerd staat" in een Slack-thread niet.
Checklist: 10 controles voordat je een door AI gegenereerd diagram merget
Gesloten lijst, bedoeld om in het pull request-sjabloon te plakken. Als er één faalt, komt het diagram er niet in.
- Uniciteit: geen enkel echt component verschijnt als twee knooppunten. Eén ID per service, de naam van de repository of van de deployment.
- Volledige beslissingen: elke ruit heeft minstens twee uitgaande lijnen, gelabeld, en de foutentak heeft een bestemming.
- Eindpunten: elk pad eindigt in een expliciet eindknooppunt; er zijn geen ketens die afbreken bij een processtap.
- Richting van de data: elke pijl gaat in de richting waarin de informatie reist, niet in die van de organisatiehiërarchie. Controleer vooral wachtrijen, webhooks en polling.
- Opgesplitste opslagplaatsen: geen generiek vakje als "Database", "Services" of "Infrastructuur". Eén knooppunt per opslag met technologie en inhoud.
- Echte lagen: elke
subgraphkomt overeen met een grens die bestaat (een deployment, een repository, een account, een netwerk), niet met een handboekabstractie. - Domeinvocabulaire: de labels gebruiken de namen die het team in de code en in de tickets schrijft, niet de woorden van je prompt.
- Geen wezen of vermijdbare kruisingen: geen losgekoppeld knooppunt, en de kruisingen die overblijven zijn gerechtvaardigd en niet op te lossen door te herordenen.
- Leesbaar op de grootte waarin het wordt gepubliceerd: het is te begrijpen in de breedte van de
READMEof het documentatieportaal, niet alleen met zoom. - Traceerbaarheid: elk niet-vanzelfsprekend element heeft een notitie met een link naar de code, het ticket of de ADR die het onderbouwt; en de
.mmdin de repository is de na de correctie geëxporteerde.
Spec-driven development: als het diagram fout is, erft de code de fout
Dit is de reden waarom auditen in 2026 niet meer cosmetisch is. In specificatiegestuurde ontwikkeling is de specificatie in Markdown —met haar Mermaid-diagrammen van architectuur en sequentie— het artefact waaruit de agent de implementatie genereert, niet een commentaar erop. Een onjuist diagram in die specificatie is niet langer verouderde documentatie: het is een defecte invoer voor een codegenerator.
Die benadering staat in de Spec Kit van GitHub zelf, waarvan de stelling is dat "specificaties niet de code dienen; de code dient de specificaties", en de implementatieplannen die het produceert bevatten architectuur- en sequentiediagrammen in Mermaid naast het datamodel en de faalmodi.
Vertaald naar het dagelijks werk: een ruit zonder "nee"-tak in de specificatie is zeer waarschijnlijk een niet-geïmplementeerd foutgeval in de gegenereerde code. Een omgekeerde pijl tussen API en wachtrij is een push-ontwerp waar je pull wilde. En een vakje "Database" dat Postgres, Redis en S3 afdekte, wordt één enkele repository met drie verantwoordelijkheden. Het diagram is van een foto van het systeem een onderdeel van het bouwplan geworden, en bouwplannen worden nagekeken.
Veelgestelde vragen
Wat betekent "Mermaid slop"?
Het is een door AI gegenereerd diagram met geldige Mermaid-syntaxis maar zonder communicatieve waarde: generieke, identieke vormen, standaardpalet, slecht gelabelde pijlen en, in de ergste gevallen, componenten of relaties die niet in het systeem bestaan. De term werd populair via het project Diagram Design en wordt gedocumenteerd in de bespreking van explainX van augustus 2026.
Kun je een door AI gegenereerd Mermaid-diagram automatisch valideren?
Maar gedeeltelijk. Een linter of de parser zelf ontdekt syntaxfouten, en je kunt structurele controles automatiseren: wezen, ruiten met maar één uitgang, paden zonder eindpunt of ID's met verdacht gelijkende labels. Wat geen enkele tool alleen kan verifiëren is of het diagram jouw systeem beschrijft; dat vereist een vergelijking met de code, en daarom combineert de checklist van dit artikel automatiseerbare controles met menselijke review.
Waarom volstaat het niet om het mermaid-blok in de pull request na te kijken?
Omdat je in de diff lijnen één voor één leest en de relevante gebreken van de hele graaf zijn: kruisingen, omgekeerde hiërarchieën, cycli, geïsoleerde knooppunten, onleesbare dichtheid. Bovendien beoordeel je bij het lezen van de tekst de intentie van de auteur en niet wat de lezer van de render zal zien. De nuttige review gebeurt op het getekende diagram.
Welke tool gebruik ik om een Mermaid-diagram met de hand te corrigeren?
Je hebt een canvas nodig dat de hele reis maakt: de .mmd importeren, je vormen en connectoren laten verplaatsen en wijzigen, elementen annoteren en weer naar Mermaid exporteren. Die laatste stap is degene die de meeste viewers laten vallen, die renderen maar de gecorrigeerde code niet teruggeven. FlowBoard dekt de cyclus: het importeert Mermaid uit een bestand of door de code te plakken, verdeelt het diagram over een oneindig canvas met zoomen en verschuiven, laat je vormen, connectoren en ankers met de hand corrigeren met magnetisme naar de ankerpunten, zijnotities met links per element toevoegen en terug naar Mermaid exporteren.
Hoelang duurt het om een door AI gegenereerd diagram te auditen?
Dat hangt af van de grootte, maar de ordegrootte voor een diagram van 15-25 knooppunten is 20 tot 40 minuten de eerste keer, en aanzienlijk minder als het team de checklist al geïnternaliseerd heeft en de domeinnamen vastliggen. Vergeleken met de kosten van een verkeerde architectuur in de officiële documentatie —of, in een specificatiegestuurde flow, in de gegenereerde code— is het goedkoop.
Moeten we stoppen met AI te gebruiken voor diagrammen?
Nee. Het eerste concept met een agent genereren bespaart het saaie werk van het intikken van knooppunten en lijnen, en om een onbekend systeem te verkennen is het nuttig. Wat je niet mag overslaan is de volgende stap: geen enkel door AI gegenereerd diagram wordt gepubliceerd zonder langs het canvas en de checklist te gaan. De AI maakt het concept; de verantwoordelijkheid voor het diagram blijft bij het team dat het ondertekent.
Slot: het diagram dat je publiceert is het diagram dat je hebt geaudit
De verandering van 2026 is niet dat AI diagrammen tekent, maar dat ze ze sneller tekent dan wij ze nakijken. Terwijl VS Code ze zonder configuratie toont, Claude ze omzet in borden en specificaties in Markdown codegeneratoren voeden, is de enige kwaliteitscontrole die overblijft de menselijke: naar de vorm kijken, markeren wat niet te bewijzen valt en de gecorrigeerde versie terugbrengen naar de repository. Tien controles en een cyclus die sluit volstaan om een diagram weer betrouwbare documentatie te maken in plaats van aannemelijke decoratie.
Die cyclus heeft een plek nodig om plaats te vinden. Bij AIsToHire lossen we dat op met FlowBoard, ons oneindige whiteboard voor diagrammen: je plakt of importeert de .mmd van de agent, verdeelt hem over een oneindig canvas, verplaatst vormen —rechthoeken, ellipsen, beslissingsruiten, documenten, plaknotities en tekst— en connectoren met rechte of orthogonale pijlen, verankert elke verbinding met magnetisme op de punten van de elementen, annoteert het twijfelachtige met zijnotities en verificatielinks en exporteert terug naar Mermaid. Het bord slaat zichzelf op, dus de audit blijft vastgelegd en je kunt haar hervatten.
Open FlowBoard, plak de .mmd die de agent je gaf en audit het diagram waar je het echt ziet: herorden per laag, corrigeer vormen en connectoren met de hand, annoteer het twijfelachtige met verificatielinks en exporteer het terug naar Mermaid. Begin gratis met je eerste bord.
Open FlowBoard, plak de .mmd die de agent je gaf en audit het diagram waar je het echt ziet: herorden per laag, corrigeer vormen en connectoren met de hand, annoteer het twijfelachtige met verificatielinks en exporteer het terug naar Mermaid. Begin gratis met je eerste bord.Lees verder
Alle artikelen bekijken →
Stroomdiagramsymbolen: wat elk symbool betekent en hoe je stap voor stap je eigen diagram tekent

Ruziemaken via WhatsApp of het in persoon bespreken: wat de wetenschap zegt over relatieconflicten via berichten

Mindmap, conceptmap en schema: verschillen en wanneer je welke gebruikt
