 ThumbLab
Miniaturas dinámicas de YouTube: cómo preparar las 3 imágenes que pide el nuevo sistema
Equipo de ThumbLabRedactado con asistencia de IA18 min de lecturaEn resumen
- En el Made on YouTube del 23 de septiembre de 2026 YouTube presentó las miniaturas dinámicas: subes hasta tres imágenes para un mismo vídeo y la plataforma "recomienda la mejor de tres opciones a distintos segmentos de tu audiencia" (YouTube Blog, 23/09/2026).
- No es el A/B test de siempre. El Test y comparación reparte hasta tres paquetes, los juzga por cuota de tiempo de visualización durante un máximo de dos semanas y acaba eligiendo una sola ganadora para todo el mundo. La miniatura dinámica no elige: reparte y convive.
- El despliegue es gradual a creadores elegibles a lo largo de lo que queda de 2026, canal por canal, y YouTube todavía no ha publicado requisitos de elegibilidad ni fecha firme.
- El trabajo nuevo no es hacer una miniatura mejor, sino producir tres con ganchos de verdad distintos —cara y emoción, objeto o resultado, antes-después—. Tres retoques del mismo encuadre no le dan al sistema nada que repartir.
- Lado técnico: 16:9, mínimo 640 px de ancho, JPG o PNG, hasta 50 MB desde ordenador y 2 MB desde la app móvil, con 3840×2160 (4K) como resolución recomendada en la ayuda de YouTube.
Si haces entre uno y cuatro vídeos al mes y te montas tú las miniaturas, las miniaturas dinámicas te cambian el encargo: hasta ahora producías una imagen y la defendías; a partir de ahora produces un juego de tres y cada una tiene que ganarse a un público distinto. Este artículo repasa qué se sabe con fuentes de la función, cómo se diseña un trío que el sistema pueda repartir y cómo comprobarlo antes de subirlo a Studio. Al final verás cómo encaja ThumbLab, el laboratorio de miniaturas para YouTube con IA de AIsToHire, en ese flujo concreto.

¿Qué son las miniaturas dinámicas de YouTube?
Las miniaturas dinámicas son una función anunciada el 23 de septiembre de 2026 en el Made on YouTube que permite asociar hasta tres miniaturas a un mismo vídeo y deja que YouTube decida qué imagen enseña a cada grupo de espectadores, según su probabilidad estimada de clic e interacción. No hay una imagen oficial del vídeo: distintas personas ven miniaturas distintas, y lo siguen viendo mientras el vídeo está publicado.
La descripción literal del YouTube Blog es que puedes "generar miniaturas ajustadas al canal o usar miniaturas dinámicas para que YouTube recomiende la mejor de tres opciones a distintos segmentos de tu audiencia". TechCrunch lo resumió el mismo día como subir varias opciones de miniatura y dejar que el sistema determine automáticamente qué versión mostrar a cada espectador en función de su potencial de interacción previsto.
Hay dos cosas que conviene asumir antes de planificar nada:
- No está en todos los canales. El análisis de rollout de Miraflow describe un despliegue gradual durante el resto de 2026 que llega "canal por canal, en vez de activarse para todo el mundo a la vez", el patrón habitual de las funciones de IA de Studio.
- Faltan detalles públicos. A fecha de hoy YouTube no ha publicado requisitos de elegibilidad, fecha de disponibilidad general ni qué métricas por variante verás en Studio. Cualquier guía que te dé porcentajes concretos de reparto se los está inventando.
Lo que sí está claro es el encargo creativo. Y ese se puede preparar ya.
¿En qué se diferencian del A/B test de miniaturas que ya existía?
La diferencia es el final de la historia. El A/B test de YouTube (Test y comparación) es un experimento con fecha de caducidad: reparte hasta tres paquetes de título y miniatura entre tramos aleatorios de tu audiencia real, los ordena por cuota de tiempo de visualización y, pasadas unas horas o hasta dos semanas, aplica una ganadora única para todos y retira las demás. La miniatura dinámica no termina nunca y no descarta: mantiene las tres vivas y asigna cada una al segmento al que mejor le encaja.
El dato de la métrica es de YouTube: al explicar el A/B test de títulos dijo que optimiza por "tiempo de visualización total frente a otras métricas como el CTR", según la cobertura de Search Engine Journal del despliegue global del 4 de diciembre de 2025. Y el volumen acumulado explica por qué YouTube ha seguido tirando de este hilo: los creadores llevan más de 40 millones de experimentos de títulos y miniaturas desde que la función se lanzó oficialmente en 2024 (YouTube Blog, 23/09/2026).
| A/B test (Test y comparación) | Miniaturas dinámicas | |
|---|---|---|
| Qué subes | Hasta 3 títulos, miniaturas o combinaciones | Hasta 3 miniaturas |
| Cómo se reparte | Tramos aleatorios de la audiencia | Por segmento de audiencia, según encaje previsto |
| Qué decide | Cuota de tiempo de visualización | No publicado; encaje por segmento |
| Duración | De unos días a 2 semanas | Mientras el vídeo esté publicado |
| Resultado | Una ganadora para todos; las demás se retiran | Las tres conviven |
| Posibles desenlaces | Ganadora, "rendimiento igual" o no concluyente | Sin ganadora única |
| Estado (12/11/2026) | Global desde 04/12/2025, escritorio y vídeo largo | Despliegue gradual a creadores elegibles |
Las dos funciones no compiten: el A/B test te sirve para descubrir qué gancho funciona, y la miniatura dinámica para aprovechar que varios ganchos funcionan con públicos distintos en vez de tirar dos de tres a la basura. YouTube además está empujando en la misma dirección por otros lados: Ask Studio podrá, con tu permiso, vigilar el rendimiento de miniaturas de vídeos antiguos y crear tests para refrescarlos, y en 2027 el A/B test se extenderá a tres cortes distintos de un Short (TechCrunch, 23/09/2026).
El problema nuevo: tres miniaturas no son tres versiones de la misma
El error que va a costar más caro es subir tres variantes del mismo encuadre —la misma foto con otro filtro, otro fondo o la flecha movida— y esperar reparto. Si las tres imágenes prometen lo mismo, no hay nada que segmentar: el sistema no puede emparejar cada opción con un público distinto porque las tres hablan al mismo público. Lo normal es que una se coma el reparto y el resto quede como decoración.
Piénsalo al revés: no estás eligiendo entre tres imágenes, estás escribiendo tres promesas para tres motivos de clic distintos.
- El suscriptor que te sigue hace dos años hace clic por ti: tu cara, tu reacción, lo que te ha pasado.
- El desconocido del feed hace clic por el objeto o el resultado: qué cosa es eso, cuánto costó, cómo quedó.
- El que llega desde búsqueda hace clic por la transformación: el estado de partida y el estado final en la misma imagen.
Son tres lectores diferentes del mismo vídeo. Esa es exactamente la materia prima que la miniatura dinámica necesita, y es el tipo de diferencia que no sale de retocar una sola imagen.
Los tres ganchos que sí se reparten: cara, objeto y antes-después
Para un vídeo medio, el trío que mejor cubre públicos distintos es: (1) cara y emoción, (2) objeto o resultado aislado y (3) antes-después partido. Son tres composiciones con jerarquía visual distinta —una persona, una cosa, una comparación—, así que se distinguen incluso a tamaño diminuto y apelan a motivaciones que no se solapan.
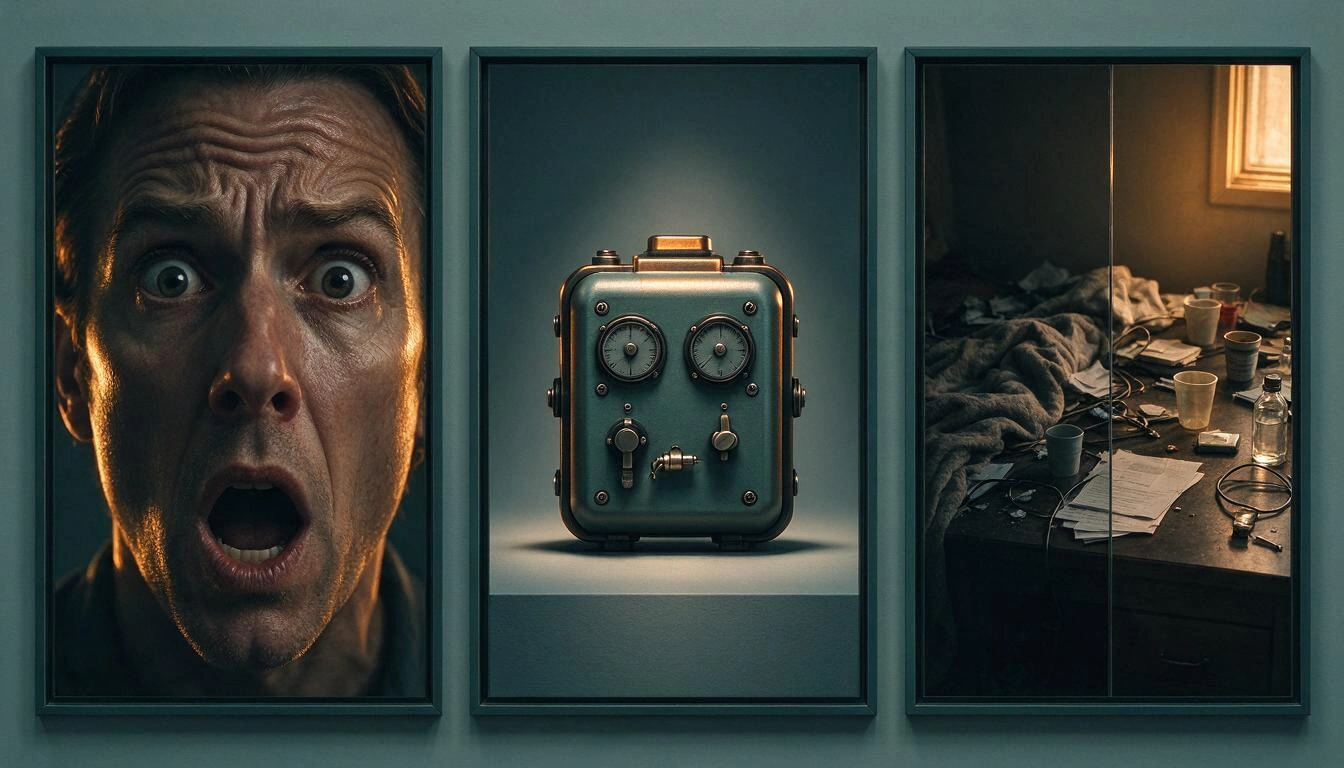
| Variante | Qué ocupa el encuadre | A quién va dirigida | Cuándo falla |
|---|---|---|---|
| Cara y emoción | Primer plano, expresión clara, fondo simple | Audiencia que ya te conoce | Canales sin cara o temas en los que tú no eres el gancho |
| Objeto o resultado | El objeto aislado, limpio, con luz dirigida | Descubrimiento frío en feed y sugeridos | Cuando el objeto no se reconoce a 120 px |
| Antes-después | Composición partida, dos estados contrastados | Búsqueda e intención concreta | Si los dos lados se parecen demasiado |
Dos ajustes que importan más de lo que parece:
- Que cada variante tenga una silueta distinta. A tamaño de feed no se leen los detalles, se lee la forma. Si las tres tienen la misma mancha oscura en el centro, visualmente son la misma miniatura.
- Que la promesa no se repita con el título. La imagen debe añadir intriga, no subtitular lo que ya dice el título. Si el título ya promete el resultado, la miniatura que repite el resultado está desperdiciando la mitad del espacio.
La regla de una sola variable por variante
Si quieres poder leer los datos, cambia una sola dimensión cada vez. En cuanto una variante cambia a la vez encuadre, expresión, fondo y color, cualquier diferencia de rendimiento deja de ser interpretable: sabes que esa imagen va mejor, pero no sabes por qué, y no puedes trasladar el aprendizaje al vídeo siguiente.
Las dimensiones que merece la pena aislar, de mayor a menor efecto habitual:
- Sujeto: persona, objeto o comparación. Es la dimensión gruesa, la que define cada una de las tres variantes.
- Emoción: sorpresa, euforia, curiosidad, seriedad. Se varía dentro de la variante de cara.
- Encuadre: plano muy cerrado frente a plano con contexto.
- Fondo y color dominante: cálido frente a frío, limpio frente a cargado.
- Texto superpuesto: presencia, longitud y posición.
En la práctica, con tres huecos: las tres variantes cambian de sujeto (dimensión 1) y dentro de cada una mantienes todo lo demás igual —misma paleta, mismo tipo de iluminación, mismo tratamiento del texto—. Así, cuando veas que una funciona, sabrás que el que funciona es el gancho y no el filtro de color. Y no mezcles la prueba con un cambio de título a la vez: una variable por experimento, también entre funciones.
Las tres tienen que aguantar a 120 píxeles
Una miniatura que solo funciona en el editor no funciona. La misma imagen se sirve en la portada a tamaño grande, en la lista de sugeridos a tamaño medio y en el feed del móvil a una anchura de apenas unas decenas de píxeles. Si una de tus tres variantes se convierte en una mancha marrón a ese tamaño, no está compitiendo: está gastando un tercio del reparto.
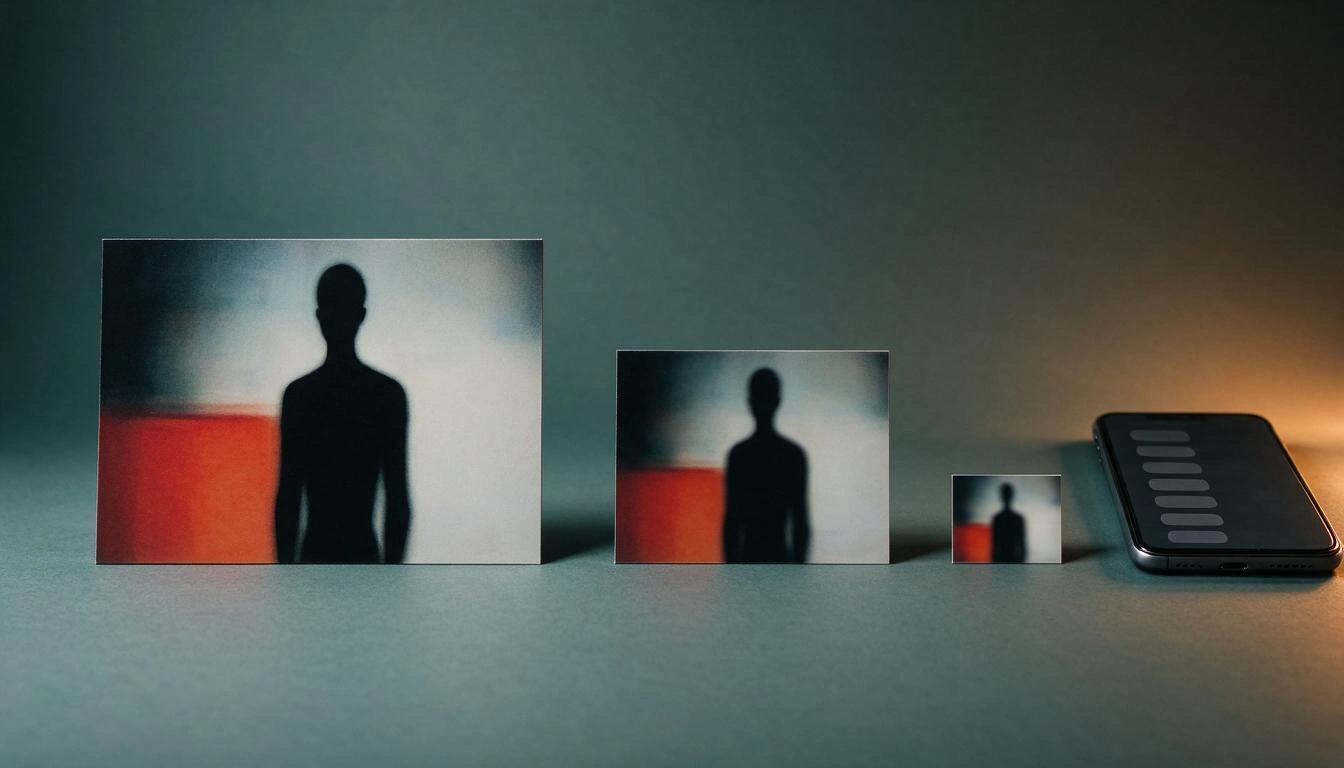
El abanico de tamaños, además, se está ensanchando por los dos extremos. YouTube es ya la plataforma con mayor cuota del tiempo de televisión en Estados Unidos: un récord del 15,8 % en agosto de 2026 según el Gauge de Nielsen, más del doble que Netflix (7,7 %) y por encima del 14,2 % de julio (PPC Land, 22/10/2026). Es decir: la misma imagen tiene que leerse en un salón de 55 pulgadas y en un chip de feed móvil. Ahí se juega el diseño.
De ahí dos decisiones prácticas:
- Prueba a tamaño real antes de subir. No con zoom al 100 %: reduciendo la imagen a los tamaños a los que la verá tu público. Si a la medida más pequeña no distingues qué pasa en la imagen, descártala.
- Reserva una zona limpia para el texto en vez de incrustarlo. Un rótulo horneado dentro de la imagen no se puede acortar, ni recolocar, ni traducir sin volver a generar la imagen. Si la composición nace con un área despejada —una esquina, un lateral— el texto va encima como capa y puedes cambiarlo todas las veces que quieras. Con tres variantes en juego y versiones por idioma, esa diferencia se multiplica por tres.
Añade un detalle de formato que pilla desprevenido a mucha gente: en móvil, los vídeos verticales con miniatura 16:9 se sustituyen por una miniatura 4:5 autogenerada en inicio, explorar y suscripciones, y tu imagen personalizada sigue apareciendo en los feeds de reproducción y en plataformas no móviles (Ayuda de YouTube). Si trabajas vertical, cuenta con ese recorte.
Especificaciones técnicas: 16:9, 640 px mínimo y hasta 50 MB
La referencia de trabajo sigue siendo 16:9, con un mínimo de 640 píxeles de ancho y formato JPG o PNG. Lo que ha cambiado es el techo: la ayuda de YouTube recomienda ahora 3840×2160 (4K) y admite archivos de hasta 50 MB subidos desde ordenador, frente a los 2 MB que siguen aplicando a la subida desde la app móvil (Ayuda de YouTube).
| Parámetro | Valor actual |
|---|---|
| Proporción | 16:9 |
| Resolución recomendada | 3840×2160 (4K) |
| Anchura mínima | 640 px |
| Formatos | JPG, PNG |
| Tamaño máximo (ordenador) | 50 MB |
| Tamaño máximo (app móvil) | 2 MB |
Qué significa esto en el día a día:
- 1280×720 sigue siendo suficiente y es el estándar de facto del sector: cumple el mínimo y se sirve bien en todas las superficies. El 4K no te va a dar más clics en el feed.
- Donde el 4K sí se nota es en la pantalla de televisión, que es la superficie que más ha crecido. Si tu canal se consume mucho en TV, exportar en 3840×2160 deja de ser un capricho.
- Los 50 MB son margen, no objetivo. Un JPG bien comprimido de 1280×720 pesa unos cientos de kilobytes. Subir un PNG de 40 MB no mejora nada y te complica el flujo si subes desde el móvil, donde el límite sigue siendo 2 MB.
- Exporta el mismo juego de tres en el mismo tamaño y formato. Si una variante va en 4K y las otras dos en 720p, estás introduciendo una variable que no querías medir.
Qué hacer con las métricas cuando no hay ganadora única
Cuando no hay ganadora, el objeto de análisis deja de ser la imagen y pasa a ser el gancho. Con un A/B test el resultado te lo da masticado —ganadora, "rendimiento igual" o no concluyente, según el marco que describe Search Engine Journal—. Con miniaturas dinámicas no hay veredicto: hay tres imágenes funcionando a la vez y lo que tienes que extraer es qué tipo de promesa engancha a qué parte de tu audiencia.
Mientras YouTube no publique qué desglose por variante vas a ver en Studio, lo sensato es montarte tu propio registro. Una hoja con una fila por vídeo y estas columnas te sirve desde el primer día:
- Vídeo y fecha de publicación.
- Gancho de cada variante (cara / objeto / antes-después) y una nota de una línea sobre el encuadre.
- Qué dimensión variaste a propósito y qué mantuviste fijo.
- CTR y retención del vídeo completo, a nivel de vídeo.
- Reparto por fuente de tráfico (búsqueda, sugeridos, feed, suscripciones), que es lo más cerca que vas a estar de ver segmentos.
Y tres reglas de lectura:
- No cambies de criterio a mitad de temporada. Con uno a cuatro vídeos al mes, una muestra útil tarda meses. Si cada vídeo prueba otra cosa, nunca tendrás nada que comparar.
- Mira el conjunto, no la variante. La pregunta correcta no es "¿cuál ganó?", es "¿este trío trajo más clics cualificados que el vídeo anterior con una sola miniatura?".
- Reutiliza el gancho que repite, no la imagen. Si "objeto aislado" funciona en tu nicho tres vídeos seguidos, lo que has aprendido es una receta de composición, no un archivo.
Cómo encaja ThumbLab en este flujo
Producir tres miniaturas con ganchos distintos y comprobarlas a tamaño real es, en esencia, el flujo para el que está construido ThumbLab, el laboratorio de miniaturas de YouTube con IA de AIsToHire. Concretamente, las cuatro piezas que pide este artículo:
- Variantes desde tus propias referencias. Subes hasta 6 imágenes y le dices a cada una su papel —tu cara, el producto, el fondo, una referencia de estilo— y la IA compone a partir de ahí, en 16:9 o en 9:16 para Shorts. Cada tirada da dos variantes A/B comparables, así que el trío de tres ganchos lo montas en dos tiradas cambiando el sujeto, que es exactamente la dimensión que te interesa aislar. Puedes guardar hasta 10 personas con sus fotos para no volver a subir tu cara en cada vídeo.
- Retoque por zonas, sin rehacer la imagen. Marcas un área sobre la miniatura y pides el cambio: borrar un elemento, reemplazarlo, ajustar la luz o cambiar la expresión. Crea una variante nueva y la original no se pierde, que es lo que necesitas cuando estás ajustando una sola dimensión y quieres poder volver atrás.
- El texto como capa editable, no horneado. La imagen se genera sin letras y con una zona limpia reservada. Tipografía, color, contorno, posición en rejilla 3×3 y badge numérico se componen encima y se editan al instante, también en otros idiomas, y se rasterizan al exportar. Cambiar el rótulo o traducirlo no cuesta una generación nueva.
- Prueba de realidad a 360, 168 y 120 px. Antes de subir nada a Studio ves las tres variantes al tamaño al que las verá tu público, con mock de la interfaz de YouTube, y descartas las que se convierten en mancha. Hay además una puntuación de CTR de la composición final y exportación a JPG y PNG 1280×720, JPG 4K y 1080×1920 para Shorts.
Dicho con honestidad: ThumbLab no sube las miniaturas a YouTube por ti ni activa las miniaturas dinámicas —eso lo hace YouTube cuando tu canal entre en el despliegue—. Lo que te ahorra es la parte que se ha triplicado: producir el juego de tres y filtrarlo antes de que llegue a Studio.
Preguntas frecuentes
¿Cuántas miniaturas puedo subir por vídeo con las miniaturas dinámicas?
Hasta tres. YouTube las describe como "la mejor de tres opciones" servida a distintos segmentos de la audiencia (YouTube Blog, 23/09/2026). A diferencia del A/B test, las tres conviven mientras el vídeo está publicado en vez de reducirse a una ganadora.
¿Las miniaturas dinámicas ya están disponibles en mi canal?
Probablemente todavía no. Se anunciaron el 23 de septiembre de 2026 y el despliegue es gradual a creadores elegibles durante lo que queda de 2026, canal por canal (Miraflow). YouTube no ha publicado requisitos de elegibilidad ni fecha de disponibilidad general, así que el camino es revisar Studio periódicamente.
¿Cuál es la diferencia entre miniaturas dinámicas y el A/B test de miniaturas?
El A/B test es un experimento temporal que ordena hasta tres paquetes por cuota de tiempo de visualización y termina aplicando una ganadora única a toda la audiencia, en un plazo de hasta dos semanas. Las miniaturas dinámicas no eligen ganadora: emparejan cada una de las tres imágenes con el segmento al que mejor le encaja y las mantienen activas de forma indefinida.
¿Qué tres miniaturas debería preparar?
Una de cara con una emoción clara, una del objeto o el resultado aislado y una de antes-después partida. Son tres composiciones con silueta distinta y tres motivos de clic que no se solapan: el suscriptor que te sigue, el desconocido que descubre el tema y el que busca una transformación concreta. Tres retoques del mismo encuadre no le dan al sistema nada que repartir.
¿Qué tamaño debe tener una miniatura de YouTube en 2026?
Proporción 16:9, mínimo 640 píxeles de ancho, en JPG o PNG. La ayuda de YouTube recomienda ahora 3840×2160 (4K) y admite hasta 50 MB desde ordenador, frente a los 2 MB que siguen aplicando a la subida desde la app móvil (Ayuda de YouTube). 1280×720 sigue cumpliendo de sobra para el feed.
¿Es mejor meter el texto dentro de la imagen o ponerlo como capa encima?
Como capa encima, sobre todo con tres variantes en juego. Un rótulo generado dentro de la imagen no se puede acortar, recolocar ni traducir sin volver a generar la imagen entera; una capa de texto se edita en segundos y se rasteriza al exportar. Diseñar la composición con una zona limpia reservada para el texto es lo que hace posible esa separación.
¿Cómo sé qué variante funciona si no hay una ganadora única?
Dejando de analizar imágenes y empezando a analizar ganchos. Registra por vídeo qué tipo de promesa usó cada variante y qué dimensión variaste a propósito, y cruza eso con el CTR, la retención y el reparto por fuente de tráfico del vídeo. Con uno a cuatro vídeos al mes, el aprendizaje útil llega por acumulación de meses, no por vídeo.
El cambio de verdad es de producción, no de diseño
Las miniaturas dinámicas no suben el listón del diseño: suben el volumen de producción. Pasas de una imagen por vídeo a tres con promesas distintas, y además tienes que comprobar que las tres aguantan desde el salón de una televisión hasta un chip de feed móvil. Para un canal de una persona con uno a cuatro vídeos al mes, ese es el cuello de botella real, y es el que conviene resolver antes de que tu canal entre en el despliegue.
Si quieres montar ese juego de tres sin abrir un editor de imagen, ThumbLab de AIsToHire cubre justo ese tramo: generar variantes A/B desde tus propias referencias, retocar por zonas sin rehacer la imagen, poner el texto como capa editable y traducible, y pasar la prueba de realidad a 360, 168 y 120 píxeles antes de subir nada a Studio. Puedes empezar por el vídeo que tengas a medias en el laboratorio de miniaturas para YouTube.
Monta tu juego de tres miniaturas en ThumbLab: genera variantes A/B desde tus propias referencias, retoca por zonas, pon el texto como capa editable y comprueba a 360, 168 y 120 px cuáles aguantan antes de subirlas a Studio. Regístrate gratis y pruébalo con el vídeo que tengas a medias.
Monta tu juego de tres miniaturas en ThumbLab: genera variantes A/B desde tus propias referencias, retoca por zonas, pon el texto como capa editable y comprueba a 360, 168 y 120 px cuáles aguantan antes de subirlas a Studio. Regístrate gratis y pruébalo con el vídeo que tengas a medias.Sigue leyendo
Ver todos los artículos →
Cómo hacer miniaturas para YouTube en 2026: medidas oficiales, la prueba de los 120 píxeles y un proceso de 5 pasos

Por qué tu seguro de coche ha subido en 2026: prima media de 1.412 € y récord histórico

Discutir por WhatsApp o hablarlo en persona: qué dice la ciencia sobre los conflictos de pareja por mensajes
