 ThumbLab
Dynamiska YouTube-miniatyrbilder: så förbereder du de 3 bilderna som det nya systemet ber om
Teamet på ThumbLabSkriven med AI-stöd17 min läsningKort sagt
- På Made on YouTube den 23 september 2026 presenterade YouTube dynamiska miniatyrbilder: du laddar upp upp till tre bilder för samma video och plattformen "rekommenderar det bästa av tre alternativ till olika segment av din publik" (YouTube Blog, 23/09/2026).
- Det är inte det vanliga A/B-testet. Test och jämförelse fördelar upp till tre paket, bedömer dem efter andel av visningstiden under högst två veckor och väljer till slut en enda vinnare för alla. Den dynamiska miniatyrbilden väljer inte: den fördelar och samexisterar.
- Utrullningen sker gradvis till behöriga skapare under resten av 2026, kanal för kanal, och YouTube har ännu inte publicerat några behörighetskrav eller något fast datum.
- Det nya arbetet är inte att göra en bättre miniatyrbild, utan att producera tre med verkligt olika krokar – ansikte och känsla, föremål eller resultat, före och efter. Tre retuscheringar av samma bildutsnitt ger systemet ingenting att fördela.
- Den tekniska sidan: 16:9, minst 640 px bredd, JPG eller PNG, upp till 50 MB från dator och 2 MB från mobilappen, med 3840×2160 (4K) som den upplösning som rekommenderas i YouTubes hjälp.
Om du gör mellan en och fyra videor i månaden och fixar miniatyrbilderna själv ändrar de dynamiska miniatyrbilderna uppdraget: hittills producerade du en bild och försvarade den, från och med nu producerar du en uppsättning om tre och var och en måste vinna över en annan publik. Den här artikeln går igenom vad som är känt utifrån funktionens källor, hur man utformar ett trio som systemet kan fördela och hur du kontrollerar det innan du laddar upp det till Studio. Mot slutet ser du hur ThumbLab, AIsToHires labb för miniatyrbilder till YouTube med AI, passar in i just det flödet.

Vad är dynamiska miniatyrbilder på YouTube?
Dynamiska miniatyrbilder är en funktion som tillkännagavs den 23 september 2026 på Made on YouTube och som gör det möjligt att knyta upp till tre miniatyrbilder till samma video och låter YouTube avgöra vilken bild som visas för vilken grupp tittare, utifrån deras beräknade sannolikhet för klick och interaktion. Det finns ingen officiell bild för videon: olika personer ser olika miniatyrbilder, och fortsätter att göra det så länge videon är publicerad.
Den bokstavliga beskrivningen i YouTube Blog är att du kan "generera miniatyrbilder anpassade till kanalen eller använda dynamiska miniatyrbilder så att YouTube rekommenderar det bästa av tre alternativ till olika segment av din publik". TechCrunch sammanfattade det samma dag som att man laddar upp flera miniatyralternativ och låter systemet automatiskt avgöra vilken version som ska visas för varje tittare utifrån den förväntade interaktionspotentialen.
Det finns två saker som är bra att ha klart för sig innan du planerar något:
- Det finns inte på alla kanaler. Miraflows analys av utrullningen beskriver en gradvis utrullning under resten av 2026 som når "kanal för kanal, i stället för att aktiveras för alla på en gång", det vanliga mönstret för Studios AI-funktioner.
- Offentliga detaljer saknas. I dagsläget har YouTube inte publicerat några behörighetskrav, något datum för allmän tillgänglighet eller vilka mätvärden per variant du kommer att se i Studio. Alla guider som ger dig konkreta procentsatser för fördelningen hittar på dem.
Det som är tydligt är det kreativa uppdraget. Och det kan förberedas redan nu.
Hur skiljer de sig från A/B-testet för miniatyrbilder som redan fanns?
Skillnaden är slutet på berättelsen. YouTubes A/B-test (Test och jämförelse) är ett experiment med utgångsdatum: det fördelar upp till tre paket med titel och miniatyrbild mellan slumpmässiga delar av din verkliga publik, rangordnar dem efter andel av visningstiden och, efter några timmar eller upp till två veckor, tillämpar en enda vinnare för alla och drar tillbaka de andra. Den dynamiska miniatyrbilden tar aldrig slut och sorterar inte bort något: den håller alla tre vid liv och tilldelar var och en det segment den passar bäst för.
Uppgiften om mätvärdet kommer från YouTube: när det förklarade A/B-testet för titlar sa det att det optimerar efter "total visningstid snarare än andra mätvärden som CTR", enligt Search Engine Journal och deras rapportering om den globala utrullningen den 4 december 2025. Och den ackumulerade volymen förklarar varför YouTube har fortsatt dra i den tråden: skaparna har gjort över 40 miljoner experiment med titlar och miniatyrbilder sedan funktionen officiellt lanserades 2024 (YouTube Blog, 23/09/2026).
| A/B-test (Test och jämförelse) | Dynamiska miniatyrbilder | |
|---|---|---|
| Vad du laddar upp | Upp till 3 titlar, miniatyrbilder eller kombinationer | Upp till 3 miniatyrbilder |
| Hur det fördelas | Slumpmässiga delar av publiken | Per publiksegment, efter förväntad passform |
| Vad som avgör | Andel av visningstiden | Ej publicerat; passform per segment |
| Varaktighet | Från några dagar till 2 veckor | Så länge videon är publicerad |
| Resultat | En vinnare för alla; de andra dras tillbaka | Alla tre samexisterar |
| Möjliga utfall | Vinnare, "lika resultat" eller inte avgörande | Ingen enskild vinnare |
| Status (12/11/2026) | Globalt sedan 04/12/2025, dator och lång video | Gradvis utrullning till behöriga skapare |
De två funktionerna konkurrerar inte: A/B-testet hjälper dig att upptäcka vilken krok som fungerar, och den dynamiska miniatyrbilden att dra nytta av att flera krokar fungerar för olika publiker i stället för att slänga två av tre. YouTube trycker dessutom åt samma håll på andra håll: Ask Studio ska, med din tillåtelse, kunna övervaka hur miniatyrbilderna på gamla videor presterar och skapa tester för att fräscha upp dem, och under 2027 utvidgas A/B-testet till tre olika klipp av en Short (TechCrunch, 23/09/2026).
Det nya problemet: tre miniatyrbilder är inte tre versioner av samma
Det fel som kommer att kosta mest är att ladda upp tre varianter av samma bildutsnitt – samma foto med ett annat filter, en annan bakgrund eller pilen flyttad – och förvänta sig en fördelning. Om de tre bilderna lovar samma sak finns det inget att segmentera: systemet kan inte para ihop varje alternativ med en annan publik eftersom alla tre talar till samma publik. Det normala är att en tar hela fördelningen och resten blir dekoration.
Tänk tvärtom: du väljer inte mellan tre bilder, du skriver tre löften för tre olika skäl att klicka.
- Prenumeranten som har följt dig i två år klickar för din skull: ditt ansikte, din reaktion, det som har hänt dig.
- Den okända i flödet klickar för föremålet eller resultatet: vad är det där, vad kostade det, hur blev det.
- Den som kommer från sökningen klickar för förvandlingen: utgångsläget och slutläget i samma bild.
Det är tre olika läsare av samma video. Det är precis den råvara som den dynamiska miniatyrbilden behöver, och det är den sortens skillnad som inte uppstår av att retuschera en enda bild.
De tre krokarna som faktiskt fördelas: ansikte, föremål och före-efter
För en genomsnittlig video är det här trion som bäst täcker olika publiker: (1) ansikte och känsla, (2) fritt föremål eller resultat och (3) delat före och efter. Det är tre kompositioner med olika visuell hierarki – en person, en sak, en jämförelse – så de går att skilja åt även i pyttesmå storlekar och vädjar till motivationer som inte överlappar.
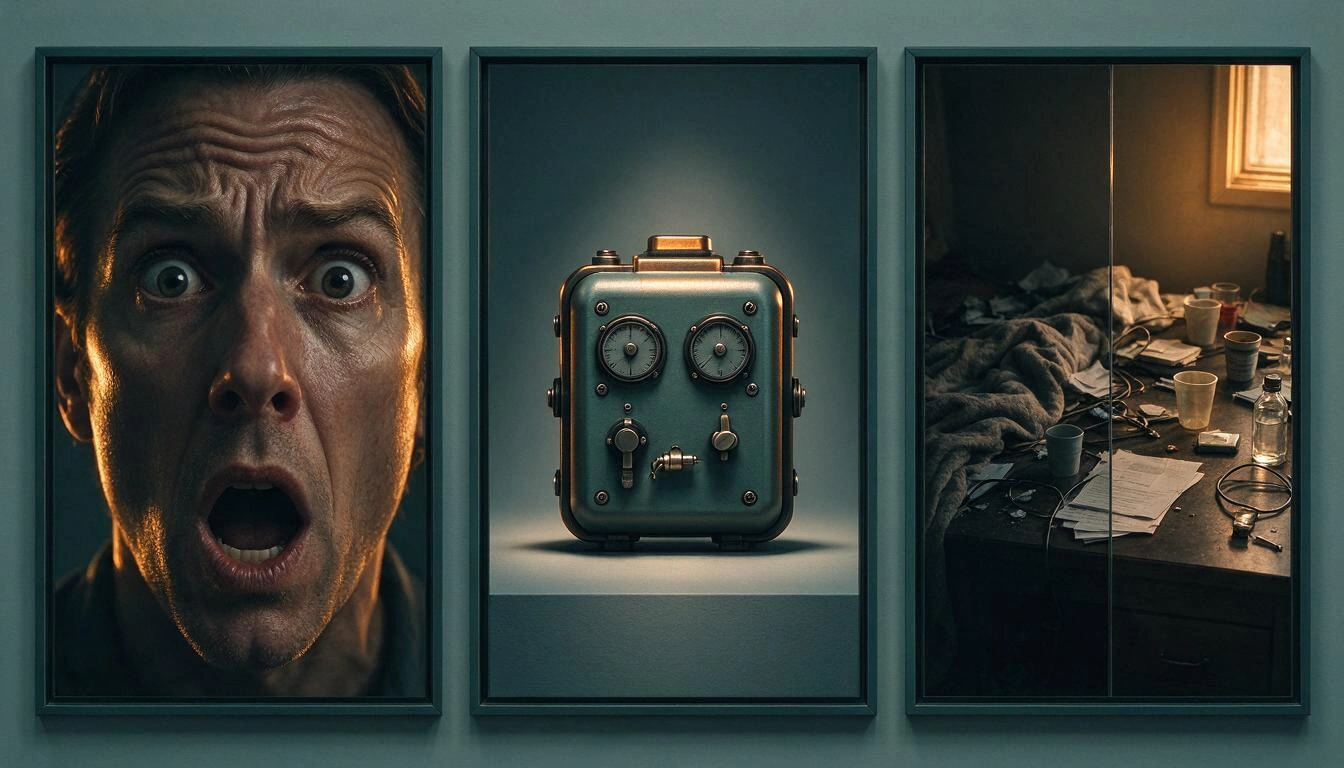
| Variant | Vad som fyller bilden | Vem den riktar sig till | När den misslyckas |
|---|---|---|---|
| Ansikte och känsla | Närbild, tydligt uttryck, enkel bakgrund | Publik som redan känner dig | Kanaler utan ansikte eller ämnen där du inte är kroken |
| Föremål eller resultat | Det fristående föremålet, rent, med riktat ljus | Kall upptäckt i flödet och bland förslag | När föremålet inte känns igen i 120 px |
| Före-efter | Delad komposition, två kontrasterande lägen | Sökning och konkret avsikt | Om de två sidorna liknar varandra för mycket |
Två justeringar som betyder mer än man tror:
- Låt varje variant ha en olika siluett. I flödets storlek läser man inte detaljer, man läser formen. Om alla tre har samma mörka fläck i mitten är de visuellt samma miniatyrbild.
- Låt inte löftet upprepa titeln. Bilden ska tillföra nyfikenhet, inte undertexta det som titeln redan säger. Om titeln redan lovar resultatet slösar en miniatyrbild som upprepar resultatet halva utrymmet.
Regeln om en enda variabel per variant
Om du vill kunna läsa data ska du ändra bara en dimension i taget. Så fort en variant ändrar bildutsnitt, uttryck, bakgrund och färg på en gång går det inte längre att tolka någon skillnad i prestanda: du vet att den bilden går bättre, men inte varför, och kan inte föra över lärdomen till nästa video.
De dimensioner som är värda att isolera, från största till minsta vanliga effekt:
- Motiv: person, föremål eller jämförelse. Det är den grova dimensionen, den som definierar var och en av de tre varianterna.
- Känsla: förvåning, eufori, nyfikenhet, allvar. Varieras inom ansiktsvarianten.
- Bildutsnitt: mycket tätt utsnitt mot utsnitt med kontext.
- Bakgrund och dominerande färg: varmt mot kallt, rent mot fullpackat.
- Överlagrad text: förekomst, längd och placering.
I praktiken, med tre platser: alla tre varianterna skiljer sig åt i motiv (dimension 1) och inom var och en håller du allt annat likadant – samma palett, samma typ av belysning, samma hantering av texten. På så sätt vet du, när du ser att en fungerar, att det är kroken som fungerar och inte färgfiltret. Och blanda inte ihop testet med en titeländring samtidigt: en variabel per experiment, även mellan funktioner.
Alla tre måste klara 120 pixlar
En miniatyrbild som bara fungerar i redigeraren fungerar inte. Samma bild visas på startsidan i stor storlek, i listan med förslag i mellanstorlek och i mobilens flöde med en bredd på bara några tiotal pixlar. Om en av dina tre varianter blir en brun fläck i den storleken konkurrerar den inte: den förbrukar en tredjedel av fördelningen.
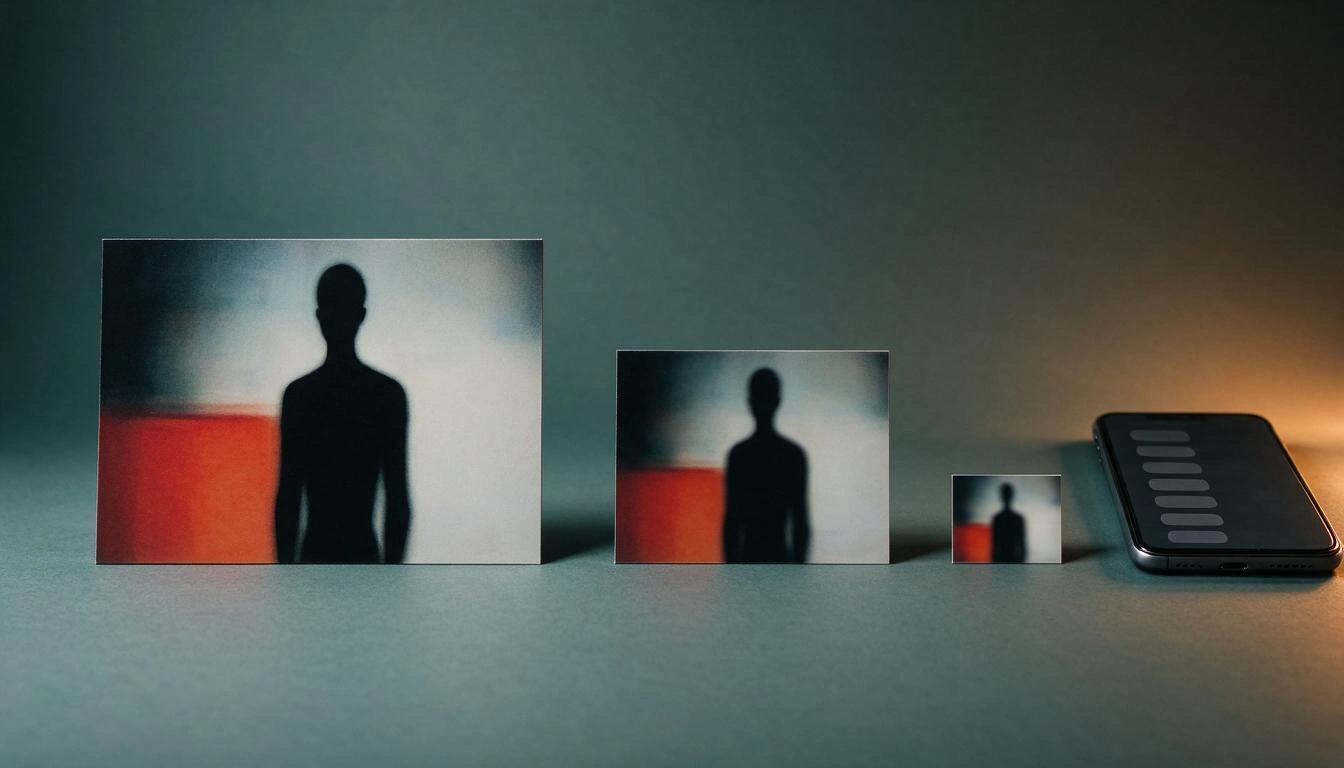
Storleksspannet vidgas dessutom i båda ändar. YouTube är redan plattformen med störst andel av tv-tiden i USA: ett rekord på 15,8 % i augusti 2026 enligt Nielsens Gauge, mer än dubbelt så mycket som Netflix (7,7 %) och över juli månads 14,2 % (PPC Land, 22/10/2026). Det vill säga: samma bild måste gå att läsa i ett vardagsrum med en 55-tums skärm och på en liten ruta i mobilflödet. Där avgörs designen.
Därav två praktiska beslut:
- Testa i verklig storlek innan du laddar upp. Inte med zoom på 100 %: minska bilden till de storlekar som din publik kommer att se den i. Om du i den minsta storleken inte kan urskilja vad som händer i bilden, förkasta den.
- Reservera en ren yta för texten i stället för att bädda in den. En text som bränts in i bilden går inte att korta av, flytta eller översätta utan att generera om bilden. Om kompositionen från början har ett fritt område – ett hörn, en sida – läggs texten ovanpå som ett lager och du kan ändra den hur många gånger du vill. Med tre varianter i spel och versioner per språk multipliceras den skillnaden med tre.
Lägg till en formatdetalj som överraskar många: på mobil ersätts 16:9-miniatyrbilden på vertikala videor av en automatiskt genererad 4:5-miniatyrbild på startsidan, i utforska och i prenumerationer, och din anpassade bild visas fortfarande i uppspelningsflödena och på icke-mobila plattformar (YouTubes hjälp). Om du arbetar i stående format, räkna med den beskärningen.
Tekniska specifikationer: 16:9, 640 px minimum och upp till 50 MB
Arbetsreferensen är fortfarande 16:9, med minst 640 pixlar bredd och formatet JPG eller PNG. Det som har ändrats är taket: YouTubes hjälp rekommenderar numera 3840×2160 (4K) och tillåter filer på upp till 50 MB vid uppladdning från dator, mot de 2 MB som fortfarande gäller för uppladdning från mobilappen (YouTubes hjälp).
| Parameter | Nuvarande värde |
|---|---|
| Proportion | 16:9 |
| Rekommenderad upplösning | 3840×2160 (4K) |
| Minsta bredd | 640 px |
| Format | JPG, PNG |
| Största storlek (dator) | 50 MB |
| Största storlek (mobilapp) | 2 MB |
Vad det här betyder i vardagen:
- 1280×720 räcker fortfarande och är branschens de facto-standard: det uppfyller minimikravet och visas bra på alla ytor. 4K ger dig inte fler klick i flödet.
- Där 4K märks är på tv-skärmen, som är den yta som har vuxit mest. Om din kanal konsumeras mycket på tv är det inte längre en nyck att exportera i 3840×2160.
- De 50 MB är marginal, inte mål. En välkomprimerad JPG på 1280×720 väger några hundra kilobyte. Att ladda upp en PNG på 40 MB förbättrar ingenting och krånglar till flödet om du laddar upp från mobilen, där gränsen fortfarande är 2 MB.
- Exportera samma uppsättning om tre i samma storlek och format. Om en variant är i 4K och de andra två i 720p inför du en variabel som du inte ville mäta.
Vad du gör med mätvärdena när det inte finns någon enskild vinnare
När det inte finns någon vinnare slutar bilden vara analysobjektet och kroken blir det. Med ett A/B-test får du resultatet färdigtuggat – vinnare, "lika resultat" eller inte avgörande, enligt den ram som Search Engine Journal beskriver. Med dynamiska miniatyrbilder finns det inget utslag: det finns tre bilder som fungerar samtidigt, och det du ska utvinna är vilken sorts löfte som fångar vilken del av din publik.
Så länge YouTube inte har publicerat vilken uppdelning per variant du kommer att se i Studio är det förnuftigt att sätta upp ditt eget register. Ett kalkylblad med en rad per video och de här kolumnerna fungerar från första dagen:
- Video och publiceringsdatum.
- Krok för varje variant (ansikte / föremål / före-efter) och en enradsanteckning om bildutsnittet.
- Vilken dimension du medvetet varierade och vad du höll fast.
- CTR och retention för hela videon, på videonivå.
- Fördelning efter trafikkälla (sökning, förslag, flöde, prenumerationer), vilket är det närmaste du kommer att se segment.
Och tre läsregler:
- Byt inte kriterium mitt i säsongen. Med en till fyra videor i månaden tar ett användbart stickprov månader. Om varje video testar något annat har du aldrig något att jämföra.
- Titta på helheten, inte på varianten. Den rätta frågan är inte "vilken vann?", utan "gav det här trion fler kvalificerade klick än den föregående videon med en enda miniatyrbild?".
- Återanvänd kroken som upprepar sig, inte bilden. Om "fritt föremål" fungerar i din nisch tre videor i rad är det du har lärt dig ett kompositionsrecept, inte en fil.
Hur ThumbLab passar in i det här flödet
Att producera tre miniatyrbilder med olika krokar och kontrollera dem i verklig storlek är i grund och botten det flöde som ThumbLab är byggt för, AIsToHires labb för YouTube-miniatyrbilder med AI. Konkret de fyra delar som den här artikeln efterfrågar:
- Varianter utifrån dina egna referenser. Du laddar upp upp till 6 bilder och anger för var och en dess roll – ditt ansikte, produkten, bakgrunden, en stilreferens – och AI:n komponerar utifrån det, i 16:9 eller i 9:16 för Shorts. Varje omgång ger två jämförbara A/B-varianter, så trion med tre krokar bygger du på två omgångar genom att byta motiv, som är precis den dimension du vill isolera. Du kan spara upp till 10 personer med sina foton så att du slipper ladda upp ditt ansikte i varje video.
- Retuschering per område, utan att göra om bilden. Du markerar ett område på miniatyrbilden och ber om ändringen: ta bort ett element, byta ut det, justera ljuset eller ändra uttrycket. Det skapar en ny variant och originalet går inte förlorat, vilket är vad du behöver när du justerar en enda dimension och vill kunna gå tillbaka.
- Texten som redigerbart lager, inte inbränd. Bilden genereras utan bokstäver och med en ren yta reserverad. Typsnitt, färg, kontur, placering i ett 3×3-rutnät och numerisk bricka läggs ovanpå och redigeras direkt, även på andra språk, och rastreras vid export. Att byta texten eller översätta den kostar ingen ny generering.
- Verklighetstest i 360, 168 och 120 px. Innan du laddar upp något till Studio ser du de tre varianterna i den storlek som din publik kommer att se dem, med en mock av YouTubes gränssnitt, och förkastar de som blir en fläck. Det finns dessutom en CTR-poäng för den slutliga kompositionen och export till JPG och PNG i 1280×720, JPG i 4K och 1080×1920 för Shorts.
Ärligt talat: ThumbLab laddar inte upp miniatyrbilderna till YouTube åt dig och aktiverar inte de dynamiska miniatyrbilderna – det gör YouTube när din kanal kommer med i utrullningen. Det den sparar åt dig är den del som har tredubblats: att producera uppsättningen om tre och sålla den innan den når Studio.
Vanliga frågor
Hur många miniatyrbilder kan jag ladda upp per video med dynamiska miniatyrbilder?
Upp till tre. YouTube beskriver dem som "det bästa av tre alternativ" som visas för olika segment av publiken (YouTube Blog, 23/09/2026). Till skillnad från A/B-testet samexisterar alla tre så länge videon är publicerad, i stället för att minskas till en vinnare.
Finns de dynamiska miniatyrbilderna redan på min kanal?
Troligen inte än. De tillkännagavs den 23 september 2026 och utrullningen sker gradvis till behöriga skapare under resten av 2026, kanal för kanal (Miraflow). YouTube har inte publicerat några behörighetskrav eller något datum för allmän tillgänglighet, så det du kan göra är att regelbundet titta i Studio.
Vad är skillnaden mellan dynamiska miniatyrbilder och A/B-testet för miniatyrbilder?
A/B-testet är ett tillfälligt experiment som rangordnar upp till tre paket efter andel av visningstiden och till slut tillämpar en enda vinnare på hela publiken, inom upp till två veckor. Dynamiska miniatyrbilder utser ingen vinnare: de parar ihop var och en av de tre bilderna med det segment den passar bäst för och håller dem aktiva på obestämd tid.
Vilka tre miniatyrbilder bör jag förbereda?
En med ansikte och en tydlig känsla, en med föremålet eller resultatet fritt, och en delad före-efter. Det är tre kompositioner med olika siluett och tre skäl att klicka som inte överlappar: prenumeranten som följer dig, den okända som upptäcker ämnet och den som söker en konkret förvandling. Tre retuscheringar av samma bildutsnitt ger systemet ingenting att fördela.
Vilken storlek ska en YouTube-miniatyrbild ha 2026?
Proportion 16:9, minst 640 pixlar bredd, i JPG eller PNG. YouTubes hjälp rekommenderar numera 3840×2160 (4K) och tillåter upp till 50 MB från dator, mot de 2 MB som fortfarande gäller för uppladdning från mobilappen (YouTubes hjälp). 1280×720 räcker fortfarande gott för flödet.
Är det bättre att lägga texten inuti bilden eller som ett lager ovanpå?
Som ett lager ovanpå, framför allt med tre varianter i spel. En text som genererats inuti bilden går inte att korta av, flytta eller översätta utan att generera om hela bilden, medan ett textlager redigeras på några sekunder och rastreras vid export. Att utforma kompositionen med en ren yta reserverad för texten är det som gör den uppdelningen möjlig.
Hur vet jag vilken variant som fungerar om det inte finns någon enskild vinnare?
Genom att sluta analysera bilder och börja analysera krokar. Registrera per video vilken sorts löfte varje variant använde och vilken dimension du medvetet varierade, och korsa det med videons CTR, retention och fördelning efter trafikkälla. Med en till fyra videor i månaden kommer den användbara lärdomen genom ackumulering över månader, inte per video.
Den verkliga förändringen gäller produktion, inte design
De dynamiska miniatyrbilderna höjer inte ribban för designen: de höjer produktionsvolymen. Du går från en bild per video till tre med olika löften, och dessutom måste du kontrollera att alla tre klarar sig från vardagsrummets tv till en liten ruta i mobilflödet. För en enmanskanal med en till fyra videor i månaden är det den verkliga flaskhalsen, och det är den som bör lösas innan din kanal kommer med i utrullningen.
Om du vill bygga den uppsättningen om tre utan att öppna en bildredigerare täcker ThumbLab från AIsToHire precis den biten: generera A/B-varianter utifrån dina egna referenser, retuschera per område utan att göra om bilden, lägga texten som ett redigerbart och översättningsbart lager och klara verklighetstestet i 360, 168 och 120 pixlar innan du laddar upp något till Studio. Du kan börja med videon du har halvfärdig i labbet för miniatyrbilder till YouTube.
Bygg din uppsättning om tre miniatyrbilder i ThumbLab: generera A/B-varianter utifrån dina egna referenser, retuschera per område, lägg texten som ett redigerbart lager och kontrollera vid 360, 168 och 120 px vilka som håller innan du laddar upp dem till Studio. Registrera dig gratis och testa det med videon du har halvfärdig.
Bygg din uppsättning om tre miniatyrbilder i ThumbLab: generera A/B-varianter utifrån dina egna referenser, retuschera per område, lägg texten som ett redigerbart lager och kontrollera vid 360, 168 och 120 px vilka som håller innan du laddar upp dem till Studio. Registrera dig gratis och testa det med videon du har halvfärdig.Läs vidare
Visa alla inlägg →
Så gör du thumbnails till YouTube 2026: officiella mått, 120-pixlarstestet och en process i 5 steg

Därför har din bilförsäkring stigit 2026: genomsnittspremie på 1 412 € och rekordnivå

Bråka på WhatsApp eller prata ut personligen: vad vetenskapen säger om parkonflikter via meddelanden
