 ThumbLab
Dynamiske miniaturebilleder på YouTube: sådan forbereder du de 3 billeder, det nye system kræver
Teamet hos ThumbLabSkrevet med AI-assistance17 min. læsningKort fortalt
- På Made on YouTube den 23. september 2026 præsenterede YouTube de dynamiske miniaturebilleder: du uploader op til tre billeder til den samme video, og platformen "anbefaler den bedste af tre muligheder til forskellige segmenter af dit publikum" (YouTube Blog, 23.09.2026).
- Det er ikke den sædvanlige A/B-test. Test og sammenligning fordeler op til tre pakker, bedømmer dem efter andel af visningstid i højst to uger og ender med at vælge én eneste vinder til alle. Det dynamiske miniaturebillede vælger ikke: det fordeler og lader dem eksistere side om side.
- Udrulningen sker gradvist til kvalificerede skabere i resten af 2026, kanal for kanal, og YouTube har endnu ikke offentliggjort krav til kvalificering eller en fast dato.
- Det nye arbejde er ikke at lave et bedre miniaturebillede, men at producere tre med virkelig forskellige hooks — ansigt og følelse, objekt eller resultat, før-og-efter. Tre småjusteringer af det samme billedudsnit giver ikke systemet noget at fordele.
- Den tekniske side: 16:9, mindst 640 px i bredden, JPG eller PNG, op til 50 MB fra computer og 2 MB fra mobilappen, med 3840×2160 (4K) som anbefalet opløsning i YouTubes hjælp.
Hvis du laver mellem én og fire videoer om måneden og selv sætter dine miniaturebilleder sammen, ændrer de dynamiske miniaturebilleder din opgave: indtil nu producerede du ét billede og forsvarede det; fra nu af producerer du et sæt på tre, og hvert af dem skal vinde et forskelligt publikum. Denne artikel gennemgår, hvad der vides ud fra funktionens kilder, hvordan man designer et trio, som systemet kan fordele, og hvordan man tjekker det, før man uploader til Studio. Til sidst kan du se, hvordan ThumbLab, AIsToHires laboratorium til miniaturebilleder til YouTube med AI, passer ind i netop det forløb.

Hvad er dynamiske miniaturebilleder på YouTube?
Dynamiske miniaturebilleder er en funktion, der blev annonceret den 23. september 2026 på Made on YouTube, og som gør det muligt at knytte op til tre miniaturebilleder til den samme video og lade YouTube afgøre hvilket billede der vises for hver gruppe af seere, ud fra deres estimerede sandsynlighed for klik og interaktion. Der findes ikke et officielt billede af videoen: forskellige mennesker ser forskellige miniaturebilleder, og de bliver ved med at se dem, så længe videoen er offentliggjort.
Den ordrette beskrivelse fra YouTube Blog er, at du kan "generere miniaturebilleder tilpasset kanalen eller bruge dynamiske miniaturebilleder, så YouTube anbefaler den bedste af tre muligheder til forskellige segmenter af dit publikum". TechCrunch opsummerede det samme dag som at uploade flere miniaturemuligheder og lade systemet automatisk afgøre, hvilken version der skal vises for hver seer ud fra dennes forventede interaktionspotentiale.
Der er to ting, du bør tage højde for, før du planlægger noget:
- Den er ikke på alle kanaler. Miraflows analyse af udrulningen beskriver en gradvis udrulning i resten af 2026, der når frem "kanal for kanal i stedet for at blive aktiveret for alle på én gang", det sædvanlige mønster for Studios AI-funktioner.
- Der mangler offentlige detaljer. På nuværende tidspunkt har YouTube ikke offentliggjort krav til kvalificering, dato for generel tilgængelighed eller hvilke målinger pr. variant du vil se i Studio. Enhver guide, der giver dig konkrete fordelingsprocenter, finder dem på.
Det, der derimod er klart, er den kreative opgave. Og den kan du forberede allerede nu.
Hvordan adskiller de sig fra den A/B-test af miniaturebilleder, der allerede fandtes?
Forskellen er historiens slutning. YouTubes A/B-test (Test og sammenligning) er et eksperiment med udløbsdato: den fordeler op til tre pakker af titel og miniaturebillede mellem tilfældige udsnit af dit rigtige publikum, rangerer dem efter andel af visningstid og anvender efter nogle timer eller op til to uger én enkelt vinder for alle og fjerner de andre. Det dynamiske miniaturebillede slutter aldrig og fravælger ikke: det holder alle tre i live og tildeler hver af dem til det segment, den passer bedst til.
Målingen kommer fra YouTube: da de forklarede A/B-testen af titler, sagde de, at den optimerer efter "samlet visningstid frem for andre målinger som CTR", ifølge Search Engine Journals dækning af den globale udrulning den 4. december 2025. Og det akkumulerede volumen forklarer, hvorfor YouTube er fortsat ad dette spor: skaberne har kørt over 40 millioner eksperimenter med titler og miniaturebilleder, siden funktionen officielt blev lanceret i 2024 (YouTube Blog, 23.09.2026).
| A/B-test (Test og sammenligning) | Dynamiske miniaturebilleder | |
|---|---|---|
| Hvad du uploader | Op til 3 titler, miniaturebilleder eller kombinationer | Op til 3 miniaturebilleder |
| Hvordan det fordeles | Tilfældige udsnit af publikum | Efter publikumssegment, ud fra forventet match |
| Hvad der afgør det | Andel af visningstid | Ikke offentliggjort; match pr. segment |
| Varighed | Fra nogle få dage til 2 uger | Så længe videoen er offentliggjort |
| Resultat | Én vinder til alle; de andre fjernes | Alle tre eksisterer side om side |
| Mulige udfald | Vinder, "lige ydeevne" eller inkonklusiv | Ingen enkelt vinder |
| Status (12.11.2026) | Globalt siden 04.12.2025, computer og lange videoer | Gradvis udrulning til kvalificerede skabere |
De to funktioner konkurrerer ikke: A/B-testen hjælper dig med at opdage, hvilket hook der virker, og det dynamiske miniaturebillede med at udnytte, at flere hooks virker på forskellige publikummer, i stedet for at smide to af tre i skraldespanden. YouTube skubber desuden i samme retning andre steder: Ask Studio vil, med din tilladelse, kunne overvåge miniaturebilledernes ydeevne på gamle videoer og oprette tests for at friske dem op, og i 2027 udvides A/B-testen til tre forskellige klip af en Short (TechCrunch, 23.09.2026).
Det nye problem: tre miniaturebilleder er ikke tre versioner af det samme
Den fejl, der kommer til at koste mest, er at uploade tre varianter af det samme billedudsnit — det samme foto med et andet filter, en anden baggrund eller en flyttet pil — og forvente en fordeling. Hvis alle tre billeder lover det samme, er der ikke noget at segmentere: systemet kan ikke matche hver mulighed med et forskelligt publikum, fordi alle tre taler til det samme publikum. Det almindelige er, at ét æder hele fordelingen, og resten bliver pynt.
Tænk over det omvendt: du vælger ikke mellem tre billeder, du skriver tre løfter til tre forskellige grunde til at klikke.
- Abonnenten, der har fulgt dig i to år, klikker på dig: dit ansigt, din reaktion, det, der er sket for dig.
- Den fremmede i feedet klikker på objektet eller resultatet: hvad er det for noget, hvad kostede det, hvordan blev det.
- Den, der kommer fra søgning, klikker på forvandlingen: udgangstilstanden og sluttilstanden i det samme billede.
Det er tre forskellige læsere af den samme video. Det er præcis det råmateriale, det dynamiske miniaturebillede har brug for, og det er den slags forskel, der ikke kommer af at justere på ét enkelt billede.
De tre hooks, der rent faktisk fordeles: ansigt, objekt og før-og-efter
For en gennemsnitlig video er det trio, der bedst dækker forskellige publikummer: (1) ansigt og følelse, (2) isoleret objekt eller resultat og (3) delt før-og-efter. Det er tre kompositioner med forskelligt visuelt hierarki — et menneske, en ting, en sammenligning — så de kan skelnes selv i bittesmå størrelser og appellerer til motivationer, der ikke overlapper.
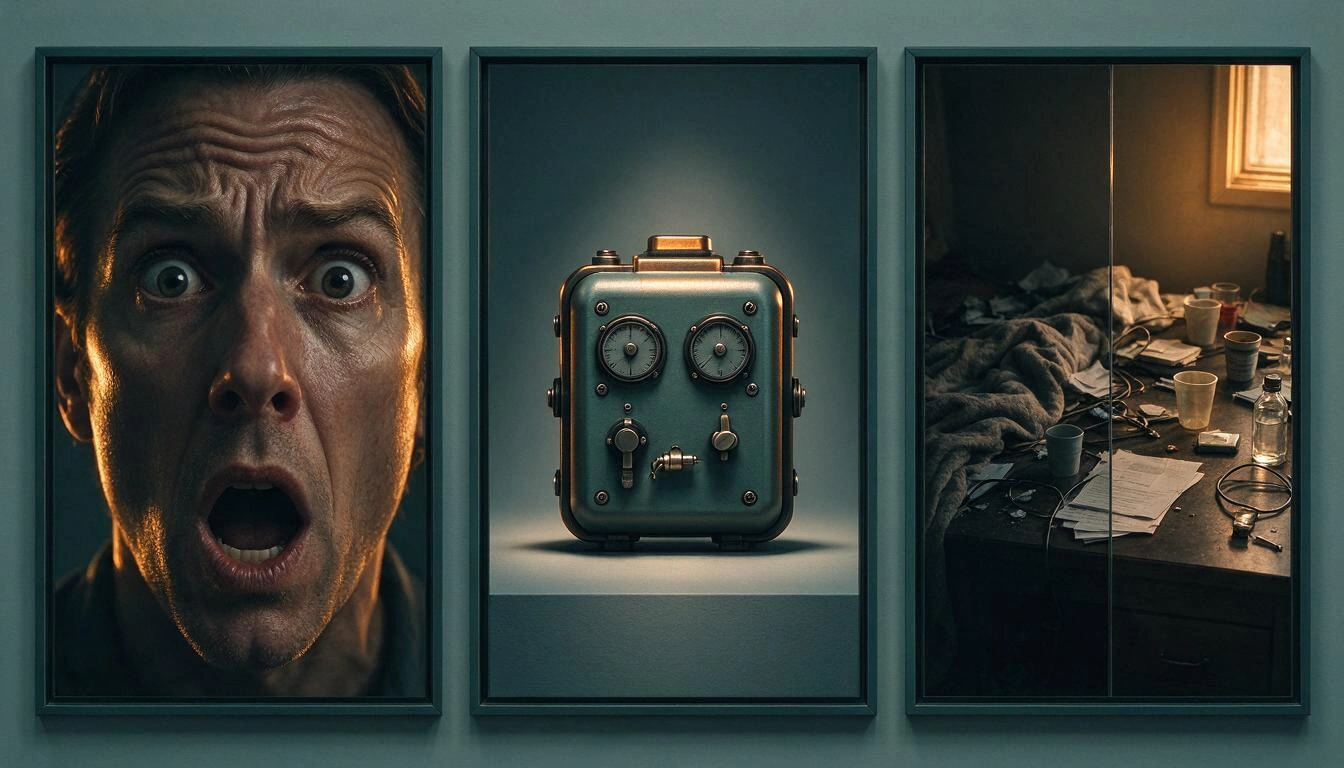
| Variant | Hvad der fylder billedet | Hvem den er rettet mod | Hvornår den fejler |
|---|---|---|---|
| Ansigt og følelse | Nærbillede, tydeligt udtryk, enkel baggrund | Publikum, der allerede kender dig | Kanaler uden ansigt eller emner, hvor du ikke selv er hooket |
| Objekt eller resultat | Det isolerede objekt, rent, med rettet lys | Koldt opdagelsesmøde i feed og foreslåede | Når objektet ikke kan genkendes ved 120 px |
| Før-og-efter | Delt komposition, to kontrasterende tilstande | Søgning og konkret hensigt | Hvis de to sider ligner hinanden for meget |
To justeringer, der betyder mere, end de ser ud til:
- Lad hver variant have en forskellig silhuet. I feedets størrelse læser man ikke detaljer, man læser formen. Hvis alle tre har den samme mørke plet i midten, er de visuelt det samme miniaturebillede.
- Lad løftet ikke gentage titlen. Billedet skal tilføje spænding, ikke blot gentage det, titlen allerede siger. Hvis titlen allerede lover resultatet, spilder det miniaturebillede, der gentager resultatet, halvdelen af pladsen.
Reglen om én variabel pr. variant
Hvis du vil kunne læse data, så skift kun én dimension ad gangen. Så snart en variant ændrer billedudsnit, udtryk, baggrund og farve på én gang, kan enhver forskel i ydeevne ikke længere fortolkes: du ved, at billedet klarer sig bedre, men ikke hvorfor, og du kan ikke overføre læringen til den næste video.
De dimensioner, der er værd at isolere, fra størst til mindst sædvanlig effekt:
- Motiv: person, objekt eller sammenligning. Det er den grove dimension, den der definerer hver af de tre varianter.
- Følelse: overraskelse, begejstring, nysgerrighed, alvor. Varieres inden for ansigtsvarianten.
- Billedudsnit: meget tæt udsnit frem for udsnit med kontekst.
- Baggrund og dominerende farve: varm frem for kold, ren frem for fyldt.
- Overlejret tekst: tilstedeværelse, længde og placering.
I praksis, med tre pladser: alle tre varianter skifter motiv (dimension 1), og inden for hver af dem holder du alt andet ens — samme palet, samme type belysning, samme behandling af teksten. På den måde ved du, når du ser, at én virker, at det er hooket, der virker, og ikke farvefilteret. Og bland ikke testen med en titelændring på samme tid: én variabel pr. eksperiment, også på tværs af funktioner.
Alle tre skal kunne holde ved 120 pixel
Et miniaturebillede, der kun virker i editoren, virker ikke. Det samme billede vises på forsiden i stor størrelse, i listen over foreslåede i mellemstørrelse og i mobilfeedet i en bredde på blot nogle få dusin pixel. Hvis en af dine tre varianter bliver til en brun plet i den størrelse, konkurrerer den ikke: den bruger en tredjedel af fordelingen.
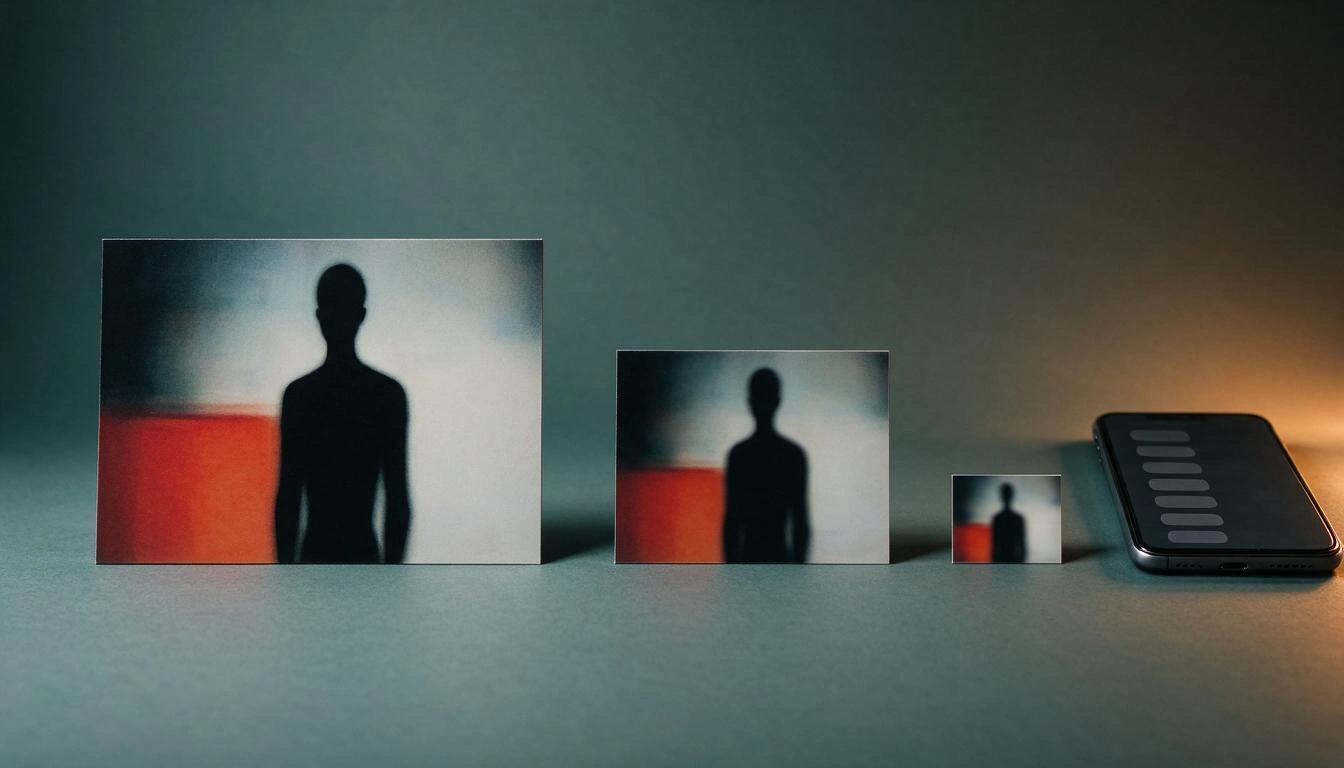
Spændet af størrelser udvides desuden i begge ender. YouTube er nu den platform med den største andel af tv-tiden i USA: en rekord på 15,8 % i august 2026 ifølge Nielsens Gauge, mere end dobbelt så meget som Netflix (7,7 %) og over de 14,2 % i juli (PPC Land, 22.10.2026). Altså: det samme billede skal kunne læses i en stue med et 55-tommers tv og på en lille chip i mobilfeedet. Det er der, designet afgøres.
Heraf to praktiske beslutninger:
- Test i den reelle størrelse, før du uploader. Ikke med zoom på 100 %: ved at forkorte billedet til de størrelser, dit publikum vil se det i. Hvis du i den mindste størrelse ikke kan se, hvad der foregår i billedet, så forkast det.
- Reservér en ren zone til teksten i stedet for at indlejre den. En tekst, der er bagt ind i billedet, kan ikke forkortes, flyttes eller oversættes uden at billedet genereres igen. Hvis kompositionen fødes med et frit område — et hjørne, en side — lægges teksten ovenpå som et lag, og du kan ændre den lige så ofte, du vil. Med tre varianter i spil og versioner pr. sprog bliver den forskel tredoblet.
Tilføj en formatdetalje, der overrasker mange: på mobil erstattes lodrette videoer med et 16:9-miniaturebillede af et autogenereret 4:5-miniaturebillede på forsiden, i udforsk og i abonnementer, og dit tilpassede billede vises stadig i afspilningsfeeds og på ikke-mobile platforme (YouTube Hjælp). Hvis du arbejder lodret, så regn med det udsnit.
Tekniske specifikationer: 16:9, 640 px minimum og op til 50 MB
Arbejdsreferencen er stadig 16:9, med en minimumsbredde på 640 pixel og formatet JPG eller PNG. Det, der har ændret sig, er loftet: YouTubes hjælp anbefaler nu 3840×2160 (4K) og tillader filer på op til 50 MB uploadet fra computer, mod de 2 MB, der stadig gælder for upload fra mobilappen (YouTube Hjælp).
| Parameter | Nuværende værdi |
|---|---|
| Format | 16:9 |
| Anbefalet opløsning | 3840×2160 (4K) |
| Minimumsbredde | 640 px |
| Filformater | JPG, PNG |
| Maksimal størrelse (computer) | 50 MB |
| Maksimal størrelse (mobilapp) | 2 MB |
Hvad det betyder i hverdagen:
- 1280×720 er stadig nok og er branchens de facto-standard: det opfylder minimummet og vises godt på alle flader. 4K giver dig ikke flere klik i feedet.
- Hvor 4K derimod mærkes, er på tv-skærmen, som er den flade, der er vokset mest. Hvis din kanal ses meget på tv, er det ikke længere en luksus at eksportere i 3840×2160.
- De 50 MB er margin, ikke mål. Et godt komprimeret JPG i 1280×720 vejer nogle hundrede kilobyte. At uploade et PNG på 40 MB forbedrer ingenting og gør dit flow besværligt, hvis du uploader fra mobilen, hvor grænsen stadig er 2 MB.
- Eksportér det samme sæt på tre i den samme størrelse og det samme format. Hvis én variant er i 4K og de to andre i 720p, indfører du en variabel, du ikke ville måle.
Hvad gør man med målingerne, når der ikke er en enkelt vinder
Når der ikke er nogen vinder, holder billedet op med at være genstand for analysen, og hooket bliver det. Med en A/B-test får du resultatet færdigtygget — vinder, "lige ydeevne" eller inkonklusivt, ifølge den ramme, Search Engine Journal beskriver —. Med dynamiske miniaturebilleder er der ingen dom: der er tre billeder, der virker på samme tid, og det, du skal uddrage, er hvilken slags løfte der fanger hvilken del af dit publikum.
Så længe YouTube ikke offentliggør, hvilken opdeling pr. variant du vil se i Studio, er det fornuftigt at opbygge dit eget register. Et regneark med én række pr. video og disse kolonner kan bruges fra første dag:
- Video og udgivelsesdato.
- Hver variants hook (ansigt / objekt / før-og-efter) og en note på én linje om billedudsnittet.
- Hvilken dimension du varierede med vilje, og hvad du holdt fast.
- CTR og fastholdelse for hele videoen, på videoniveau.
- Fordeling efter trafikkilde (søgning, foreslåede, feed, abonnementer), hvilket er det tætteste, du kommer på at se segmenter.
Og tre læseregler:
- Skift ikke kriterium midt i sæsonen. Med én til fire videoer om måneden tager en brugbar stikprøve måneder. Hvis hver video tester noget andet, får du aldrig noget at sammenligne.
- Se på helheden, ikke på varianten. Det rigtige spørgsmål er ikke "hvilken vandt?", men "bragte dette trio flere kvalificerede klik end den forrige video med ét enkelt miniaturebillede?".
- Genbrug det hook, der gentager sig, ikke billedet. Hvis "isoleret objekt" virker i din niche tre videoer i træk, er det, du har lært, en kompositionsopskrift, ikke en fil.
Hvordan ThumbLab passer ind i dette flow
At producere tre miniaturebilleder med forskellige hooks og tjekke dem i reel størrelse er i bund og grund det flow, ThumbLab er bygget til, laboratoriet til miniaturebilleder til YouTube med AI fra AIsToHire. Helt konkret de fire dele, som denne artikel efterspørger:
- Varianter ud fra dine egne referencer. Du uploader op til 6 billeder og fortæller hvert billede dets rolle — dit ansigt, produktet, baggrunden, en stilreference — og AI'en komponerer ud fra det, i 16:9 eller i 9:16 til Shorts. Hver runde giver to sammenlignelige A/B-varianter, så trioen med tre hooks sætter du sammen i to runder ved at skifte motiv, hvilket netop er den dimension, du vil isolere. Du kan gemme op til 10 personer med deres fotos, så du ikke skal uploade dit ansigt igen til hver video.
- Retouchering efter zoner, uden at lave billedet om. Du markerer et område på miniaturebilledet og beder om ændringen: slette et element, erstatte det, justere lyset eller ændre udtrykket. Det opretter en ny variant, og originalen går ikke tabt, hvilket er det, du har brug for, når du justerer kun én dimension og vil kunne gå tilbage.
- Teksten som redigerbart lag, ikke indbagt. Billedet genereres uden bogstaver og med en reserveret ren zone. Typografi, farve, kontur, placering i 3×3-gitter og talbadge sammensættes ovenpå og redigeres med det samme, også på andre sprog, og rasteriseres ved eksport. At ændre teksten eller oversætte den koster ikke en ny generering.
- Virkelighedstest ved 360, 168 og 120 px. Før du uploader noget til Studio, ser du de tre varianter i den størrelse, dit publikum vil se dem i, med en mock af YouTubes grænseflade, og forkaster dem, der bliver til en plet. Der er desuden en CTR-score for den endelige komposition og eksport til JPG og PNG 1280×720, JPG 4K og 1080×1920 til Shorts.
Helt ærligt: ThumbLab uploader ikke miniaturebillederne til YouTube for dig og aktiverer ikke de dynamiske miniaturebilleder — det gør YouTube, når din kanal kommer med i udrulningen —. Det, den sparer dig for, er den del, der er tredoblet: at producere sættet på tre og filtrere det, før det når til Studio.
Ofte stillede spørgsmål
Hvor mange miniaturebilleder kan jeg uploade pr. video med de dynamiske miniaturebilleder?
Op til tre. YouTube beskriver dem som "den bedste af tre muligheder", der vises for forskellige segmenter af publikum (YouTube Blog, 23.09.2026). I modsætning til A/B-testen eksisterer alle tre side om side, så længe videoen er offentliggjort, i stedet for at blive reduceret til én vinder.
Er de dynamiske miniaturebilleder allerede tilgængelige på min kanal?
Sandsynligvis ikke endnu. De blev annonceret den 23. september 2026, og udrulningen sker gradvist til kvalificerede skabere i resten af 2026, kanal for kanal (Miraflow). YouTube har ikke offentliggjort krav til kvalificering eller dato for generel tilgængelighed, så vejen frem er at tjekke Studio med jævne mellemrum.
Hvad er forskellen mellem dynamiske miniaturebilleder og A/B-testen af miniaturebilleder?
A/B-testen er et midlertidigt eksperiment, der rangerer op til tre pakker efter andel af visningstid og ender med at anvende én enkelt vinder på hele publikummet inden for op til to uger. De dynamiske miniaturebilleder vælger ikke en vinder: de matcher hvert af de tre billeder med det segment, det passer bedst til, og holder dem aktive på ubestemt tid.
Hvilke tre miniaturebilleder bør jeg forberede?
Ét med ansigt og en tydelig følelse, ét af det isolerede objekt eller resultat og ét delt før-og-efter. Det er tre kompositioner med forskellig silhuet og tre grunde til at klikke, der ikke overlapper: abonnenten, der følger dig, den fremmede, der opdager emnet, og den, der søger en konkret forvandling. Tre småjusteringer af det samme billedudsnit giver ikke systemet noget at fordele.
Hvilken størrelse skal et YouTube-miniaturebillede have i 2026?
Format 16:9, mindst 640 pixel i bredden, i JPG eller PNG. YouTubes hjælp anbefaler nu 3840×2160 (4K) og tillader op til 50 MB fra computer, mod de 2 MB, der stadig gælder for upload fra mobilappen (YouTube Hjælp). 1280×720 opfylder stadig rigeligt til feedet.
Er det bedre at lægge teksten ind i billedet eller lægge den som lag ovenpå?
Som lag ovenpå, især med tre varianter i spil. En tekst, der er genereret inde i billedet, kan ikke forkortes, flyttes eller oversættes uden at hele billedet genereres igen; et tekstlag redigeres på få sekunder og rasteriseres ved eksport. At designe kompositionen med en reserveret ren zone til teksten er det, der gør den adskillelse mulig.
Hvordan ved jeg, hvilken variant der virker, hvis der ikke er en enkelt vinder?
Ved at holde op med at analysere billeder og begynde at analysere hooks. Registrér pr. video, hvilken slags løfte hver variant brugte, og hvilken dimension du varierede med vilje, og krydsreferer det med videoens CTR, fastholdelse og fordeling efter trafikkilde. Med én til fire videoer om måneden kommer den brugbare læring gennem akkumulering over måneder, ikke pr. video.
Den egentlige ændring er i produktionen, ikke i designet
De dynamiske miniaturebilleder hæver ikke designniveauet: de hæver produktionsvolumenet. Du går fra ét billede pr. video til tre med forskellige løfter, og du skal desuden tjekke, at alle tre kan holde fra stuens tv til en lille chip i mobilfeedet. For en kanal med én person og én til fire videoer om måneden er det den reelle flaskehals, og det er den, der bør løses, før din kanal kommer med i udrulningen.
Hvis du vil sætte det sæt på tre sammen uden at åbne et billedredigeringsprogram, dækker ThumbLab fra AIsToHire netop det led: generere A/B-varianter ud fra dine egne referencer, retouchere efter zoner uden at lave billedet om, lægge teksten som et redigerbart og oversætteligt lag og bestå virkelighedstesten ved 360, 168 og 120 pixel, før du uploader noget til Studio. Du kan starte med den video, du har halvfærdig, i laboratoriet til miniaturebilleder til YouTube.
Sammensæt dit sæt på tre miniaturebilleder i ThumbLab: generér A/B-varianter ud fra dine egne referencer, retouchér efter zoner, læg teksten som et redigerbart lag og tjek ved 360, 168 og 120 px, hvilke der holder, før du uploader dem til Studio. Opret konto gratis og prøv det med den video, du har halvfærdig.
Sammensæt dit sæt på tre miniaturebilleder i ThumbLab: generér A/B-varianter ud fra dine egne referencer, retouchér efter zoner, læg teksten som et redigerbart lag og tjek ved 360, 168 og 120 px, hvilke der holder, før du uploader dem til Studio. Opret konto gratis og prøv det med den video, du har halvfærdig.Læs videre
Se alle artikler →
Sådan laver du thumbnails til YouTube i 2026: officielle mål, 120-pixel-testen og en proces i 5 trin

Derfor er din bilforsikring steget i 2026: gennemsnitspræmie på 1.412 € og historisk rekord

At skændes på WhatsApp eller tale om det i person: hvad videnskaben siger om parkonflikter via beskeder
