 ThumbLab
Miniatury dynamiczne YouTube: jak przygotować 3 obrazy, o które prosi nowy system
Zespół ThumbLabNapisane z pomocą AI15 min czytaniaW skrócie
- Na Made on YouTube 23 września 2026 roku YouTube zaprezentował miniatury dynamiczne: przesyłasz do trzech obrazów do tego samego filmu, a platforma „poleca najlepszą z trzech opcji różnym segmentom Twojej widowni” (YouTube Blog, 23.09.2026).
- To nie jest zwykły test A/B. Test i porównanie rozdziela do trzech pakietów, ocenia je według udziału w czasie oglądania przez maksymalnie dwa tygodnie i kończy wyborem jednej zwycięskiej dla wszystkich. Miniatura dynamiczna nie wybiera: rozdziela i współistnieje.
- Wdrażanie jest stopniowe, dla kwalifikujących się twórców w trakcie reszty 2026 roku, kanał po kanale, a YouTube nie opublikował jeszcze wymagań kwalifikacji ani pewnej daty.
- Nowe zadanie to nie zrobienie lepszej miniatury, lecz przygotowanie trzech o naprawdę różnych haczykach — twarz i emocja, przedmiot lub wynik, przed i po. Trzy retusze tego samego kadru nie dają systemowi niczego do rozdzielenia.
- Strona techniczna: 16:9, minimum 640 px szerokości, JPG lub PNG, do 50 MB z komputera i 2 MB z aplikacji mobilnej, z 3840×2160 (4K) jako rozdzielczością zalecaną w pomocy YouTube.
Jeśli robisz od jednego do czterech filmów miesięcznie i sam montujesz miniatury, miniatury dynamiczne zmieniają Ci zadanie: dotąd tworzyłeś jeden obraz i go broniłeś; odtąd tworzysz zestaw trzech, a każdy musi zdobyć inną widownię. Ten artykuł omawia, co wiadomo ze źródeł dotyczących funkcji, jak zaprojektować trio, które system może rozdzielić, i jak to sprawdzić przed wgraniem do Studio. Na końcu zobaczysz, jak ThumbLab, laboratorium miniatur do YouTube z AI od AIsToHire, wpisuje się w ten konkretny proces.

Czym są miniatury dynamiczne YouTube?
Miniatury dynamiczne to funkcja ogłoszona 23 września 2026 roku na Made on YouTube, która pozwala powiązać do trzech miniatur z jednym filmem i pozwala YouTube zdecydować, który obraz pokazać każdej grupie widzów, według szacowanego prawdopodobieństwa kliknięcia i zaangażowania. Nie ma jednego oficjalnego obrazu filmu: różni ludzie widzą różne miniatury i nadal je widzą, dopóki film jest opublikowany.
Dosłowny opis z YouTube Blog mówi, że możesz „generować miniatury dopasowane do kanału lub używać miniatur dynamicznych, by YouTube polecał najlepszą z trzech opcji różnym segmentom Twojej widowni”. TechCrunch streścił to tego samego dnia jako przesłanie kilku opcji miniatury i pozwolenie, by system automatycznie ustalał, którą wersję pokazać każdemu widzowi na podstawie jego przewidywanego potencjału zaangażowania.
Dwie rzeczy warto przyjąć do wiadomości, zanim cokolwiek zaplanujesz:
- Nie jest dostępna na wszystkich kanałach. Analiza wdrożenia Miraflow opisuje stopniowe wdrażanie przez resztę 2026 roku, które trafia „kanał po kanale, zamiast włączać się wszystkim naraz”, czyli typowy wzorzec funkcji AI w Studio.
- Brakuje publicznych szczegółów. Na dziś YouTube nie opublikował wymagań kwalifikacji, daty powszechnej dostępności ani tego, jakie metryki dla poszczególnych wariantów zobaczysz w Studio. Każdy poradnik, który podaje konkretne procenty podziału, je zmyśla.
To, co jest jasne, to zadanie kreatywne. A to można przygotować już teraz.
Czym różnią się od testu A/B miniatur, który już istniał?
Różnica leży w zakończeniu historii. Test A/B YouTube (Test i porównanie) to eksperyment z datą ważności: rozdziela do trzech pakietów tytułu i miniatury między losowe grupy Twojej prawdziwej widowni, układa je według udziału w czasie oglądania i po kilku godzinach lub do dwóch tygodni stosuje jedną zwycięską dla wszystkich, a pozostałe wycofuje. Miniatura dynamiczna nigdy się nie kończy i niczego nie odrzuca: utrzymuje trzy żywe i przypisuje każdą do segmentu, któremu najlepiej pasuje.
Dane o metryce pochodzą od YouTube: przy wyjaśnianiu testu A/B tytułów powiedział, że optymalizuje pod „łączny czas oglądania zamiast innych metryk, takich jak CTR”, według relacji Search Engine Journal z globalnego wdrożenia z 4 grudnia 2025 roku. A skumulowany wolumen wyjaśnia, dlaczego YouTube dalej pociąga ten wątek: twórcy przeprowadzili ponad 40 milionów eksperymentów z tytułami i miniaturami, odkąd funkcja została oficjalnie uruchomiona w 2024 roku (YouTube Blog, 23.09.2026).
| Test A/B (Test i porównanie) | Miniatury dynamiczne | |
|---|---|---|
| Co przesyłasz | Do 3 tytułów, miniatur lub kombinacji | Do 3 miniatur |
| Jak się rozdziela | Losowe grupy widowni | Według segmentu widowni, zgodnie z przewidywanym dopasowaniem |
| Co decyduje | Udział w czasie oglądania | Nieopublikowane; dopasowanie do segmentu |
| Czas trwania | Od kilku dni do 2 tygodni | Dopóki film jest opublikowany |
| Wynik | Jedna zwycięska dla wszystkich; pozostałe wycofane | Wszystkie trzy współistnieją |
| Możliwe wyniki | Zwycięzca, „równa skuteczność” lub brak rozstrzygnięcia | Brak jednej zwycięskiej |
| Stan (12.11.2026) | Globalnie od 04.12.2025, komputer i długie wideo | Stopniowe wdrażanie dla kwalifikujących się twórców |
Obie funkcje nie konkurują: test A/B służy do odkrycia, który haczyk działa, a miniatura dynamiczna do wykorzystania tego, że kilka haczyków działa na różne grupy, zamiast wyrzucać dwa z trzech do kosza. YouTube zresztą pcha w tym samym kierunku także z innych stron: Ask Studio będzie mogło, za Twoją zgodą, monitorować skuteczność miniatur starych filmów i tworzyć testy, by je odświeżyć, a w 2027 test A/B zostanie rozszerzony na trzy różne cięcia Shorta (TechCrunch, 23.09.2026).
Nowy problem: trzy miniatury to nie trzy wersje tej samej
Błąd, który będzie kosztował najwięcej, to przesłanie trzech wariantów tego samego kadru — to samo zdjęcie z innym filtrem, tłem albo przesuniętą strzałką — i oczekiwanie rozdziału. Jeśli wszystkie trzy obrazy obiecują to samo, nie ma czego segmentować: system nie może sparować każdej opcji z inną widownią, bo wszystkie trzy mówią do tej samej. Zwykle jedna zjada cały rozdział, a reszta zostaje dekoracją.
Pomyśl o tym odwrotnie: nie wybierasz między trzema obrazami, piszesz trzy obietnice dla trzech różnych motywów kliknięcia.
- Subskrybent, który obserwuje Cię od dwóch lat, klika dla Ciebie: Twojej twarzy, Twojej reakcji, tego, co Ci się przydarzyło.
- Nieznajomy z feedu klika dla przedmiotu lub wyniku: co to jest, ile kosztowało, jak wyszło.
- Ten, kto trafia z wyszukiwarki, klika dla transformacji: stanu wyjściowego i końcowego na tym samym obrazie.
To trzej różni czytelnicy tego samego filmu. To właśnie surowiec, którego potrzebuje miniatura dynamiczna, i rodzaj różnicy, który nie wychodzi z retuszowania jednego obrazu.
Trzy haczyki, które się rozdzielają: twarz, przedmiot i przed-po
Dla przeciętnego filmu trio, które najlepiej obejmuje różne widownie, to: (1) twarz i emocja, (2) izolowany przedmiot lub wynik i (3) podzielone przed-po. To trzy kompozycje o różnej hierarchii wizualnej — osoba, rzecz, porównanie — więc odróżniają się nawet w miniaturowym rozmiarze i odwołują się do motywacji, które się nie pokrywają.
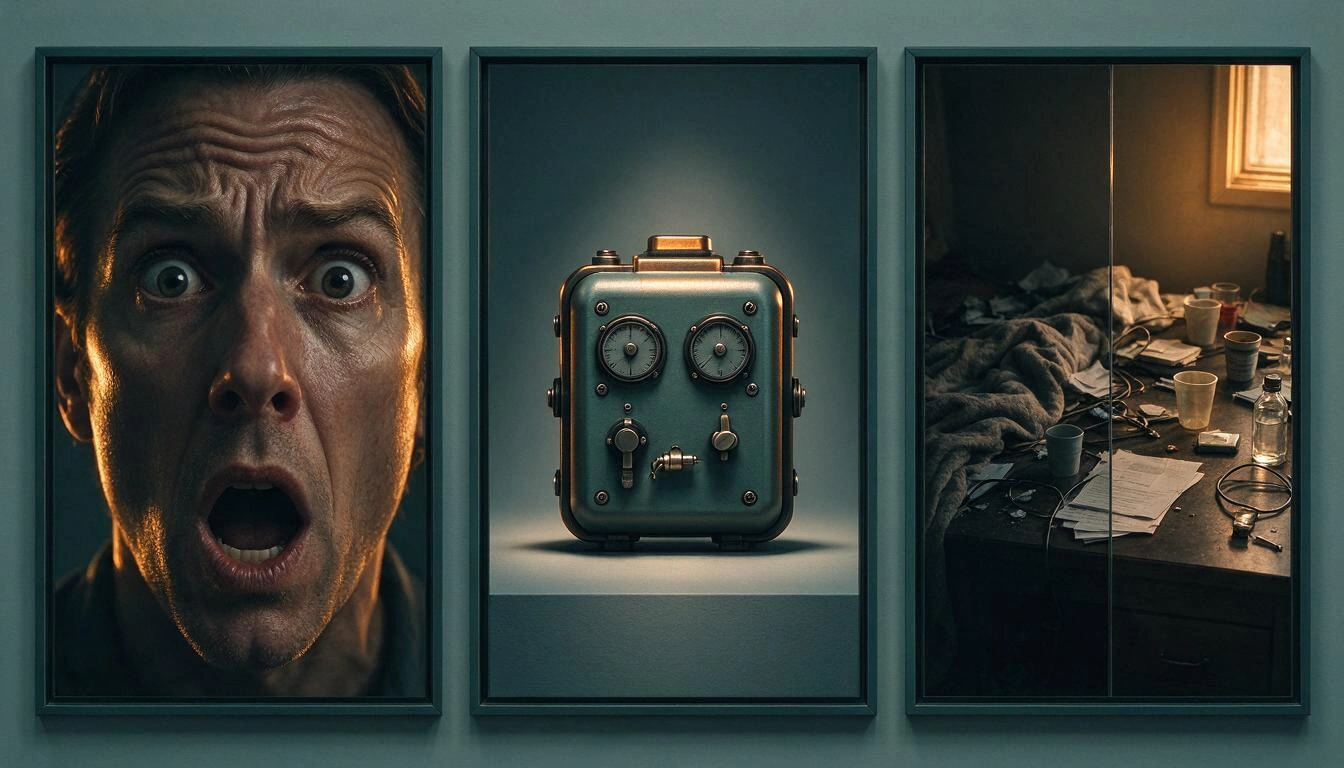
| Wariant | Co wypełnia kadr | Do kogo jest skierowany | Kiedy zawodzi |
|---|---|---|---|
| Twarz i emocja | Zbliżenie, wyraźna mina, proste tło | Widownia, która już Cię zna | Kanały bez twarzy lub tematy, w których to nie Ty jesteś haczykiem |
| Przedmiot lub wynik | Izolowany przedmiot, czysty, z kierunkowym światłem | Zimne odkrywanie w feedzie i poleconych | Gdy przedmiotu nie da się rozpoznać przy 120 px |
| Przed-po | Podzielona kompozycja, dwa kontrastowe stany | Wyszukiwanie i konkretny zamiar | Jeśli obie strony są zbyt podobne |
Dwie poprawki, które znaczą więcej, niż się wydaje:
- Niech każdy wariant ma inną sylwetkę. W rozmiarze feedu nie czyta się szczegółów, czyta się kształt. Jeśli wszystkie trzy mają tę samą ciemną plamę pośrodku, wizualnie to ta sama miniatura.
- Niech obietnica nie powtarza tytułu. Obraz powinien dodawać intrygi, a nie podpisywać to, co już mówi tytuł. Jeśli tytuł już obiecuje wynik, miniatura powtarzająca wynik marnuje połowę miejsca.
Zasada jednej zmiennej na wariant
Jeśli chcesz móc czytać dane, zmieniaj tylko jeden wymiar naraz. Gdy tylko wariant zmienia jednocześnie kadr, wyraz twarzy, tło i kolor, jakakolwiek różnica w skuteczności przestaje być interpretowalna: wiesz, że ten obraz działa lepiej, ale nie wiesz dlaczego, i nie możesz przenieść wniosku na kolejny film.
Wymiary, które warto izolować, od zwykle największego wpływu do najmniejszego:
- Podmiot: osoba, przedmiot lub porównanie. To wymiar gruby, ten, który definiuje każdy z trzech wariantów.
- Emocja: zaskoczenie, euforia, ciekawość, powaga. Zmienia się ją w obrębie wariantu z twarzą.
- Kadr: bardzo ciasny plan kontra plan z kontekstem.
- Tło i dominujący kolor: ciepły kontra zimny, czysty kontra przeładowany.
- Nałożony tekst: obecność, długość i pozycja.
W praktyce, przy trzech miejscach: wszystkie trzy warianty zmieniają podmiot (wymiar 1), a w obrębie każdego zachowujesz wszystko inne bez zmian — ta sama paleta, ten sam rodzaj oświetlenia, to samo potraktowanie tekstu. Dzięki temu, gdy zobaczysz, że jeden działa, będziesz wiedzieć, że działa haczyk, a nie filtr kolorystyczny. I nie mieszaj testu ze zmianą tytułu naraz: jedna zmienna na eksperyment, także między funkcjami.
Wszystkie trzy muszą wytrzymać 120 pikseli
Miniatura, która działa tylko w edytorze, nie działa. Ten sam obraz jest serwowany na stronie filmu w dużym rozmiarze, na liście poleconych w średnim, a w feedzie mobilnym przy szerokości zaledwie kilkudziesięciu pikseli. Jeśli jeden z Twoich trzech wariantów w tym rozmiarze zamienia się w brązową plamę, nie konkuruje: marnuje jedną trzecią rozdziału.
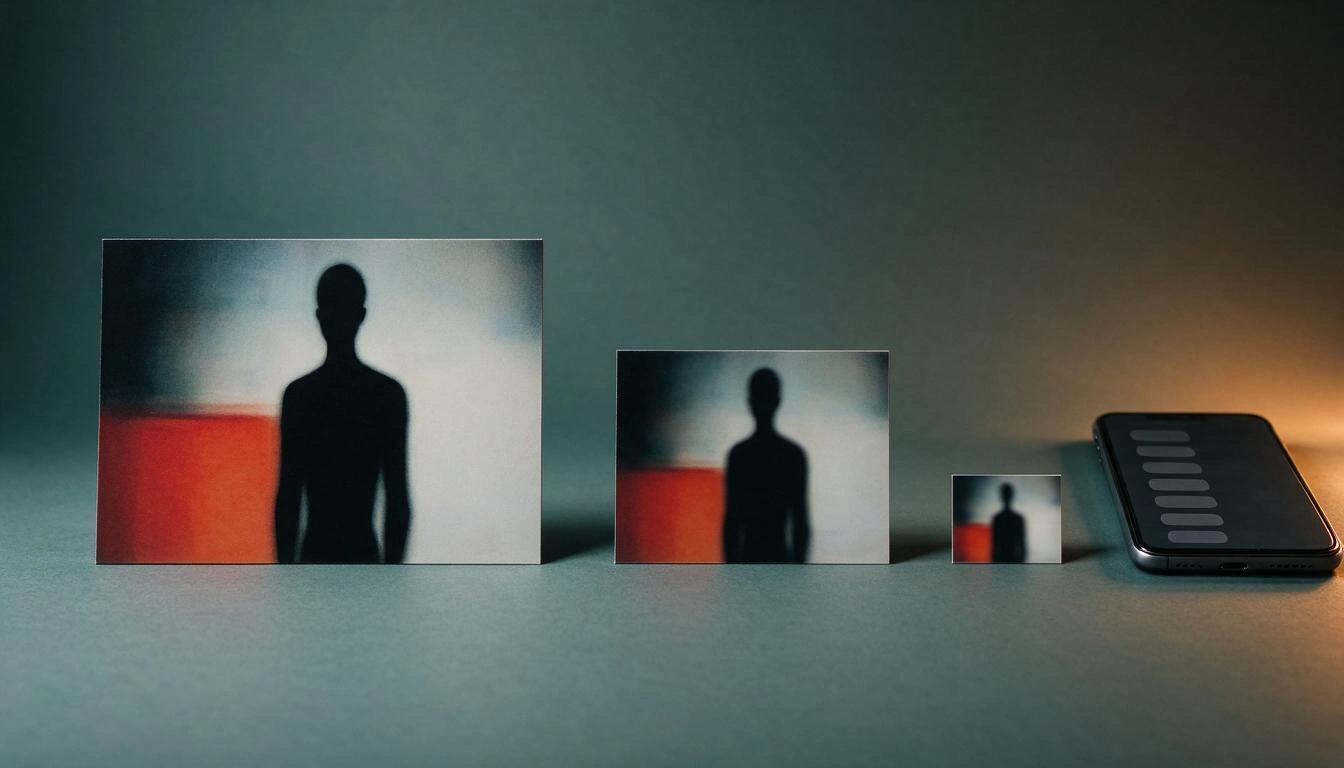
Rozpiętość rozmiarów zresztą się poszerza z obu końców. YouTube jest już platformą z największym udziałem w czasie telewizyjnym w Stanach Zjednoczonych: rekordowe 15,8 % w sierpniu 2026 według Gauge Nielsena, ponad dwukrotnie więcej niż Netflix (7,7 %) i powyżej 14,2 % z lipca (PPC Land, 22.10.2026). Czyli ten sam obraz musi się czytać w salonie na 55 calach i na chipie feedu mobilnego. Tu rozstrzyga się projekt.
Stąd dwie praktyczne decyzje:
- Testuj w rzeczywistym rozmiarze przed wgraniem. Nie przez zoom 100 %: zmniejszając obraz do rozmiarów, w jakich zobaczy go Twoja widownia. Jeśli w najmniejszym rozmiarze nie rozróżniasz, co dzieje się na obrazie, odrzuć go.
- Zarezerwuj czystą strefę na tekst zamiast go wtapiać. Napisu wypalonego w obrazie nie da się skrócić, przesunąć ani przetłumaczyć bez ponownego wygenerowania obrazu. Jeśli kompozycja powstaje z wolnym obszarem — rogiem, bokiem — tekst trafia na wierzch jako warstwa i możesz go zmieniać tyle razy, ile chcesz. Przy trzech wariantach w grze i wersjach językowych ta różnica mnoży się przez trzy.
Dodaj szczegół formatu, który zaskakuje wielu: na telefonie filmy pionowe z miniaturą 16:9 są zastępowane automatycznie wygenerowaną miniaturą 4:5 na stronie głównej, w eksploracji i w subskrypcjach, a Twój własny obraz nadal pojawia się w feedach odtwarzania i na platformach niemobilnych (Pomoc YouTube). Jeśli pracujesz w pionie, licz się z tym kadrowaniem.
Specyfikacja techniczna: 16:9, minimum 640 px i do 50 MB
Punktem odniesienia nadal jest 16:9, z minimalną szerokością 640 pikseli i formatem JPG lub PNG. Zmienił się pułap: pomoc YouTube zaleca teraz 3840×2160 (4K) i dopuszcza pliki do 50 MB przesyłane z komputera, wobec 2 MB, które nadal obowiązują przy przesyłaniu z aplikacji mobilnej (Pomoc YouTube).
| Parametr | Aktualna wartość |
|---|---|
| Proporcje | 16:9 |
| Zalecana rozdzielczość | 3840×2160 (4K) |
| Minimalna szerokość | 640 px |
| Formaty | JPG, PNG |
| Maksymalny rozmiar (komputer) | 50 MB |
| Maksymalny rozmiar (aplikacja mobilna) | 2 MB |
Co to oznacza na co dzień:
- 1280×720 nadal wystarcza i jest standardem de facto w branży: spełnia minimum i dobrze się serwuje na wszystkich powierzchniach. 4K nie da Ci więcej kliknięć w feedzie.
- 4K widać na ekranie telewizora, czyli powierzchni, która urosła najbardziej. Jeśli Twój kanał jest dużo oglądany na TV, eksport w 3840×2160 przestaje być kaprysem.
- 50 MB to zapas, nie cel. Dobrze skompresowany JPG 1280×720 waży kilkaset kilobajtów. Wgranie 40-megabajtowego PNG niczego nie poprawia i komplikuje proces, jeśli wgrywasz z telefonu, gdzie limit nadal wynosi 2 MB.
- Eksportuj ten sam zestaw trzech w tym samym rozmiarze i formacie. Jeśli jeden wariant jest w 4K, a pozostałe dwa w 720p, wprowadzasz zmienną, której nie chciałeś mierzyć.
Co zrobić z metrykami, gdy nie ma jednej zwycięskiej
Gdy nie ma zwycięskiej, przedmiotem analizy przestaje być obraz, a staje się haczyk. W teście A/B wynik dostajesz przeżuty — zwycięzca, „równa skuteczność” lub brak rozstrzygnięcia, według ram opisanych przez Search Engine Journal. Przy miniaturach dynamicznych nie ma werdyktu: są trzy obrazy działające jednocześnie, a Ty masz wydobyć jaki typ obietnicy przyciąga jaką część Twojej widowni.
Dopóki YouTube nie opublikuje, jaki podział na warianty zobaczysz w Studio, rozsądnie jest założyć własny rejestr. Arkusz z jednym wierszem na film i tymi kolumnami przyda się od pierwszego dnia:
- Film i data publikacji.
- Haczyk każdego wariantu (twarz / przedmiot / przed-po) i jednolinijkowa notatka o kadrze.
- Jaki wymiar zmieniłeś celowo, a co pozostało stałe.
- CTR i retencja całego filmu, na poziomie filmu.
- Podział według źródła ruchu (wyszukiwanie, polecane, feed, subskrypcje), co jest najbliżej, jak dojdziesz do oglądania segmentów.
I trzy zasady czytania:
- Nie zmieniaj kryterium w połowie sezonu. Przy jednym–czterech filmach miesięcznie użyteczna próba zbiera się miesiącami. Jeśli każdy film testuje coś innego, nigdy nie będziesz mieć czego porównać.
- Patrz na zestaw, nie na wariant. Właściwe pytanie to nie „który wygrał?”, lecz „czy to trio przyniosło więcej wartościowych kliknięć niż poprzedni film z jedną miniaturą?”.
- Używaj ponownie haczyka, który się powtarza, a nie obrazu. Jeśli „izolowany przedmiot” działa w Twojej niszy trzy filmy z rzędu, to, czego się nauczyłeś, to przepis na kompozycję, a nie plik.
Jak ThumbLab wpisuje się w ten proces
Przygotowanie trzech miniatur o różnych haczykach i sprawdzenie ich w rzeczywistym rozmiarze to w istocie proces, do którego zbudowano ThumbLab, laboratorium miniatur YouTube z AI od AIsToHire. Konkretnie cztery elementy, o które prosi ten artykuł:
- Warianty z Twoich własnych referencji. Przesyłasz do 6 obrazów i każdemu mówisz, jaką pełni rolę — Twoja twarz, produkt, tło, referencja stylu — a AI komponuje na tej podstawie, w 16:9 lub 9:16 dla Shorts. Każde podejście daje dwa porównywalne warianty A/B, więc trio trzech haczyków składasz w dwóch podejściach, zmieniając podmiot, czyli dokładnie ten wymiar, który chcesz izolować. Możesz zapisać do 10 osób z ich zdjęciami, by nie wgrywać swojej twarzy przy każdym filmie.
- Retusz strefowy, bez przerabiania obrazu. Zaznaczasz obszar na miniaturze i prosisz o zmianę: usunięcie elementu, zastąpienie go, korektę światła lub zmianę wyrazu twarzy. Powstaje nowy wariant, a oryginał nie ginie, czego potrzebujesz, gdy dopracowujesz jeden wymiar i chcesz móc wrócić.
- Tekst jako edytowalna warstwa, a nie wypalony. Obraz jest generowany bez liter i z zarezerwowaną czystą strefą. Krój pisma, kolor, kontur, pozycja w siatce 3×3 i odznaka numeryczna nakładane są na wierzch i edytowane natychmiast, także w innych językach, a rasteryzowane przy eksporcie. Zmiana napisu lub jego tłumaczenie nie kosztuje nowego generowania.
- Test rzeczywistości przy 360, 168 i 120 px. Zanim cokolwiek wgrasz do Studio, widzisz trzy warianty w rozmiarze, w jakim zobaczy je Twoja widownia, z makietą interfejsu YouTube, i odrzucasz te, które zamieniają się w plamę. Jest też ocena CTR finalnej kompozycji i eksport do JPG i PNG 1280×720, JPG 4K oraz 1080×1920 dla Shorts.
Szczerze mówiąc: ThumbLab nie wgrywa miniatur na YouTube za Ciebie ani nie włącza miniatur dynamicznych — robi to YouTube, gdy Twój kanał wejdzie do wdrożenia. Oszczędza Ci część, która się potroiła: przygotowanie zestawu trzech i przefiltrowanie go, zanim trafi do Studio.
Najczęstsze pytania
Ile miniatur mogę przesłać do filmu przy miniaturach dynamicznych?
Do trzech. YouTube opisuje je jako „najlepszą z trzech opcji” serwowaną różnym segmentom widowni (YouTube Blog, 23.09.2026). W przeciwieństwie do testu A/B wszystkie trzy współistnieją, dopóki film jest opublikowany, zamiast zredukować się do jednej zwycięskiej.
Czy miniatury dynamiczne są już dostępne na moim kanale?
Prawdopodobnie jeszcze nie. Ogłoszono je 23 września 2026 roku, a wdrażanie jest stopniowe dla kwalifikujących się twórców przez resztę 2026 roku, kanał po kanale (Miraflow). YouTube nie opublikował wymagań kwalifikacji ani daty powszechnej dostępności, więc pozostaje okresowo sprawdzać Studio.
Jaka jest różnica między miniaturami dynamicznymi a testem A/B miniatur?
Test A/B to tymczasowy eksperyment, który układa do trzech pakietów według udziału w czasie oglądania i kończy zastosowaniem jednej zwycięskiej dla całej widowni, w terminie do dwóch tygodni. Miniatury dynamiczne nie wybierają zwycięzcy: parują każdy z trzech obrazów z segmentem, któremu najlepiej pasuje, i utrzymują je aktywne bezterminowo.
Jakie trzy miniatury powinienem przygotować?
Jedną z twarzą i wyraźną emocją, jedną z izolowanym przedmiotem lub wynikiem i jedną podzieloną przed-po. To trzy kompozycje o różnej sylwetce i trzy motywy kliknięcia, które się nie pokrywają: subskrybent, który Cię obserwuje, nieznajomy odkrywający temat i ten, kto szuka konkretnej transformacji. Trzy retusze tego samego kadru nie dają systemowi niczego do rozdzielenia.
Jaki rozmiar powinna mieć miniatura YouTube w 2026?
Proporcje 16:9, minimum 640 pikseli szerokości, w JPG lub PNG. Pomoc YouTube zaleca teraz 3840×2160 (4K) i dopuszcza do 50 MB z komputera, wobec 2 MB, które nadal obowiązują przy przesyłaniu z aplikacji mobilnej (Pomoc YouTube). 1280×720 z nawiązką wystarcza dla feedu.
Czy lepiej umieścić tekst w obrazie, czy jako warstwę na wierzchu?
Jako warstwę na wierzchu, zwłaszcza przy trzech wariantach w grze. Napisu wygenerowanego w obrazie nie da się skrócić, przesunąć ani przetłumaczyć bez ponownego wygenerowania całego obrazu; warstwę tekstu edytuje się w kilka sekund i rasteryzuje przy eksporcie. Zaprojektowanie kompozycji z zarezerwowaną czystą strefą na tekst umożliwia to rozdzielenie.
Skąd mam wiedzieć, który wariant działa, jeśli nie ma jednej zwycięskiej?
Przestając analizować obrazy i zaczynając analizować haczyki. Zapisuj dla każdego filmu, jakiego typu obietnicy użył każdy wariant i jaki wymiar zmieniłeś celowo, i zestawiaj to z CTR, retencją i podziałem według źródła ruchu dla filmu. Przy jednym–czterech filmach miesięcznie użyteczna wiedza przychodzi przez kumulację miesięcy, a nie przez pojedynczy film.
Prawdziwa zmiana dotyczy produkcji, nie projektu
Miniatury dynamiczne nie podnoszą poprzeczki projektu: podnoszą wolumen produkcji. Przechodzisz od jednego obrazu na film do trzech z różnymi obietnicami, a do tego musisz sprawdzić, że wszystkie trzy wytrzymują od salonu z telewizorem po chip feedu mobilnego. Dla kanału jednoosobowego z jednym–czterema filmami miesięcznie to prawdziwe wąskie gardło i warto je rozwiązać, zanim Twój kanał wejdzie do wdrożenia.
Jeśli chcesz złożyć ten zestaw trzech bez otwierania edytora grafiki, ThumbLab od AIsToHire obejmuje dokładnie ten odcinek: generowanie wariantów A/B z Twoich własnych referencji, retusz strefowy bez przerabiania obrazu, tekst jako edytowalna i tłumaczalna warstwa oraz test rzeczywistości przy 360, 168 i 120 pikselach, zanim cokolwiek wgrasz do Studio. Możesz zacząć od filmu, który masz w połowie gotowy, w laboratorium miniatur do YouTube.
Złóż swój zestaw trzech miniatur w ThumbLab: generuj warianty A/B z własnych referencji, retuszuj strefowo, ustaw tekst jako edytowalną warstwę i sprawdź przy 360, 168 i 120 px, które się sprawdzają, zanim wgrasz je do Studio. Zarejestruj się za darmo i wypróbuj na filmie, który masz w połowie gotowy.
Złóż swój zestaw trzech miniatur w ThumbLab: generuj warianty A/B z własnych referencji, retuszuj strefowo, ustaw tekst jako edytowalną warstwę i sprawdź przy 360, 168 i 120 px, które się sprawdzają, zanim wgrasz je do Studio. Zarejestruj się za darmo i wypróbuj na filmie, który masz w połowie gotowy.Czytaj dalej
Zobacz wszystkie artykuły →
Jak zrobić miniaturę na YouTube w 2026 roku: oficjalne wymiary, test 120 pikseli i proces w 5 krokach

Dlaczego twoje ubezpieczenie samochodu zdrożało w 2026: średnia składka 1 412 € i historyczny rekord

Kłótnia na WhatsAppie czy rozmowa na żywo: co mówi nauka o konfliktach w parze przez wiadomości
