 ThumbLab
Dynamische YouTube-Thumbnails: So bereitest du die 3 Bilder vor, die das neue System verlangt
Team von ThumbLabMit KI-Unterstützung verfasst17 Min. LesezeitZusammenfassung
- Im Made on YouTube vom 23. September 2026 stellte YouTube die dynamischen Miniaturen vor: Du lädst bis zu drei Bilder für dasselbe Video hoch und die Plattform "empfiehlt die beste von drei Optionen an verschiedene Segmente deiner Zielgruppe" (YouTube Blog, 23.09.2026).
- Es ist nicht der gewohnte A/B-Test. Der Test und Vergleich verteilt bis zu drei Pakete, bewertet sie nach Sehdauer über einen Zeitraum von maximal zwei Wochen und wählt am Ende eine einzige Gewinnerin für alle aus. Die dynamische Miniatur wählt nicht: verteilt und koexistiert.
- Die Bereitstellung erfolgt schrittweise für berechtigte Creator im Laufe des restlichen Jahres 2026, kanalweise, und YouTube hat bisher keine Anforderungen an die Berechtigung oder ein festes Datum veröffentlicht.
- Die neue Aufgabe besteht nicht darin, eine bessere Miniatur zu erstellen, sondern drei mit wirklich unterschiedlichen Hooks zu produzieren —Gesicht und Emotion, Objekt oder Ergebnis, vorher-nachher—. Drei Anpassungen desselben Rahmens geben dem System nichts zu verteilen.
- Technische Seite: 16:9, mindestens 640 px Breite, JPG oder PNG, bis zu 50 MB von einem Computer und 2 MB von der mobilen App, mit 3840×2160 (4K) als empfohlene Auflösung in der YouTube-Hilfe.
Wenn du zwischen einem und vier Videos im Monat machst und die Miniaturen selbst erstellst, ändern die dynamischen Miniaturen deinen Auftrag: Bis jetzt hast du ein Bild produziert und es verteidigt; ab jetzt produzierst du ein Set von drei und jede muss sich ein unterschiedliches Publikum erarbeiten. Dieser Artikel behandelt, was über die Funktion bekannt ist, wie man ein Trio entwirft, das das System verteilen kann, und wie man dies vor dem Hochladen in Studio überprüft. Am Ende wirst du sehen, wie ThumbLab, das Labor für Miniaturen für YouTube mit KI von AIsToHire, in diesen spezifischen Workflow passt.

Was sind die dynamischen Miniaturen von YouTube?
Die dynamischen Miniaturen sind eine Funktion, die am 23. September 2026 im Made on YouTube angekündigt wurde und es ermöglicht, bis zu drei Miniaturen für dasselbe Video zu verknüpfen und YouTube entscheiden lässt, welches Bild jeder Zuschauergruppe angezeigt wird, basierend auf ihrer geschätzten Klick- und Interaktionswahrscheinlichkeit. Es gibt kein offizielles Bild des Videos: Verschiedene Personen sehen unterschiedliche Miniaturen, und sie sehen es weiterhin, während das Video veröffentlicht ist.
Die wörtliche Beschreibung im YouTube Blog lautet, dass du "Miniaturen an den Kanal anpassen oder dynamische Miniaturen verwenden kannst, damit YouTube die beste von drei Optionen an verschiedene Segmente deiner Zielgruppe empfiehlt". TechCrunch fasste es am selben Tag zusammen als das Hochladen mehrerer Miniatur-Optionen und das automatische Bestimmen durch das System, welche Version jedem Zuschauer basierend auf seinem voraussichtlichen Interaktionspotenzial angezeigt werden soll.
Es gibt zwei Dinge, die man vor der Planung beachten sollte:
- Es ist nicht auf allen Kanälen verfügbar. Die Rollout-Analyse von Miraflow beschreibt eine schrittweise Einführung im Rest von 2026, die "kanalweise erfolgt, anstatt für alle gleichzeitig aktiviert zu werden", das übliche Muster der KI-Funktionen von Studio.
- Öffentliche Details fehlen. Bis heute hat YouTube keine Anforderungen an die Berechtigung, kein Datum für die allgemeine Verfügbarkeit und keine Metriken pro Variante veröffentlicht, die du im Studio sehen wirst. Jeder Leitfaden, der dir konkrete Verteilungsschätzungen gibt, erfindet diese.
Was jedoch klar ist, ist der kreative Auftrag. Und dieser kann bereits vorbereitet werden.
Wie unterscheiden sie sich vom bestehenden A/B-Test für Miniaturen?
Der Unterschied liegt am Ende der Geschichte. Der A/B-Test von YouTube (Test und Vergleich) ist ein Experiment mit Ablaufdatum: Er verteilt bis zu drei Pakete von Titel und Miniatur zwischen zufälligen Abschnitten deines echten Publikums, sortiert sie nach Sehdauer und wendet nach einigen Stunden oder bis zu zwei Wochen einen einzigen Gewinner für alle an und zieht die anderen zurück. Die dynamische Miniatur endet nie und verwirft nicht: Sie hält alle drei lebendig und weist jede dem Segment zu, das am besten passt.
Die Metrik stammt von YouTube: Als der A/B-Test für Titel erklärt wurde, sagte man, dass er "die gesamte Sehdauer gegenüber anderen Metriken wie der CTR optimiert", laut der Berichterstattung von Search Engine Journal über die globale Einführung am 4. Dezember 2025. Und das kumulierte Volumen erklärt, warum YouTube weiterhin an diesem Faden zieht: Die Creator haben über 40 Millionen Experimente mit Titeln und Miniaturen durchgeführt, seit die Funktion 2024 offiziell eingeführt wurde (YouTube Blog, 23.09.2026).
| A/B-Test (Test und Vergleich) | Dynamische Miniaturen | |
|---|---|---|
| Was du hochlädst | Bis zu 3 Titel, Miniaturen oder Kombinationen | Bis zu 3 Miniaturen |
| Wie verteilt wird | Zufällige Abschnitte des Publikums | Nach Publikumsegment, je nach voraussichtlicher Passform |
| Was entscheidet | Sehdauer | Nicht veröffentlicht; Passform nach Segment |
| Dauer | Von ein paar Tagen bis 2 Wochen | Solange das Video veröffentlicht ist |
| Ergebnis | Ein Gewinner für alle; die anderen werden zurückgezogen | Alle drei coexistieren |
| Mögliche Ergebnisse | Gewinner, "gleiche Leistung" oder nicht schlüssig | Keine eindeutige Gewinnerin |
| Status (12.11.2026) | Global seit 04.12.2025, Desktop und lange Videos | Graduale Einführung für berechtigte Creator |
Die beiden Funktionen konkurrieren nicht: Der A/B-Test hilft dir herauszufinden, welcher Hook funktioniert, und die dynamische Miniatur, um von mehreren Hooks zu profitieren, die mit verschiedenen Zielgruppen funktionieren, anstatt zwei von drei in den Müll zu werfen. YouTube drängt zudem in dieselbe Richtung von anderen Seiten: Ask Studio kann mit deiner Erlaubnis die Leistung von Miniaturen alter Videos überwachen und Tests erstellen, um sie aufzufrischen, und 2027 wird der A/B-Test auf drei verschiedene Schnitte eines Shorts ausgeweitet (TechCrunch, 23.09.2026).
Das neue Problem: drei Miniaturen sind nicht drei Versionen desselben
Der Fehler, der am teuersten zu stehen kommt, ist es, drei Varianten des gleichen Rahmens hochzuladen — dasselbe Foto mit einem anderen Filter, einem anderen Hintergrund oder dem verschobenen Pfeil — und auf Verteilung zu warten. Wenn die drei Bilder dasselbe versprechen, gibt es nichts zu segmentieren: Das System kann jede Option nicht mit einem anderen Publikum paaren, weil alle drei dasselbe Publikum ansprechen. Normalerweise frisst eine die Verteilung und die anderen bleiben als Dekoration.
Denk es umgekehrt: Du wählst nicht zwischen drei Bildern, du schreibst drei Versprechen für drei verschiedene Klickmotive.
- Der Abonnent, der dir seit zwei Jahren folgt, klickt wegen dir: deinem Gesicht, deiner Reaktion, was dir passiert ist.
- Der Unbekannte im Feed klickt wegen des Objekts oder des Ergebnisses: was ist das, wie viel hat es gekostet, wie ist es geworden.
- Derjenige, der über die Suche kommt, klickt wegen der Verwandlung: der Ausgangszustand und der Endzustand im selben Bild.
Es sind drei unterschiedliche Leser des gleichen Videos. Das ist genau das Rohmaterial, das die dynamische Miniatur benötigt, und es ist die Art von Unterschied, die nicht durch das Retuschieren eines einzigen Bildes entsteht.
Die drei Hooks, die sich tatsächlich verteilen: Gesicht, Objekt und Vorher-Nachher
Für ein durchschnittliches Video ist das Trio, das am besten verschiedene Zielgruppen abdeckt: (1) Gesicht und Emotion, (2) isoliertes Objekt oder Ergebnis und (3) Vorher-Nachher geteilt. Es sind drei Kompositionen mit unterschiedlicher visueller Hierarchie — eine Person, eine Sache, ein Vergleich — sodass sie selbst in kleinem Maßstab unterscheidbar sind und auf nicht überlappende Motivationen ansprechen.
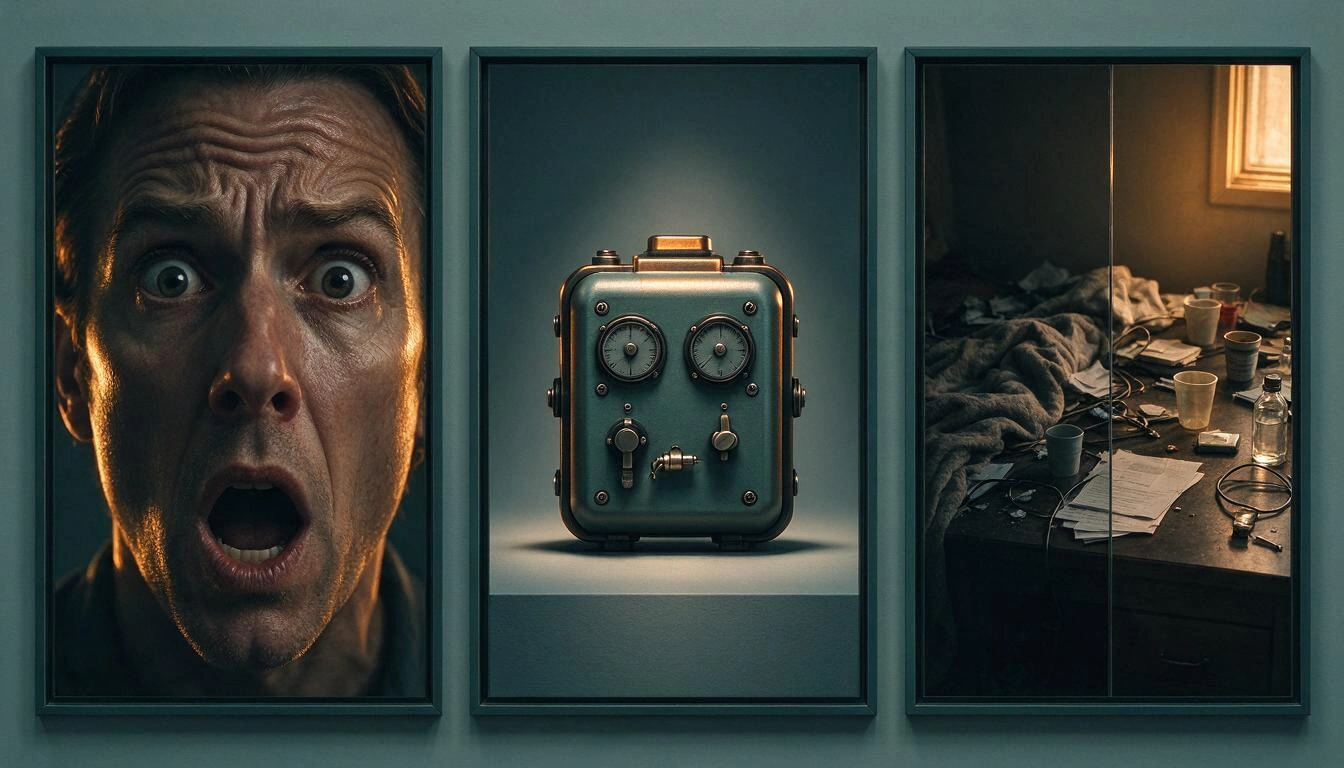
| Variante | Was den Rahmen einnimmt | An wen es gerichtet ist | Wann es scheitert |
|---|---|---|---|
| Gesicht und Emotion | Nahaufnahme, klare Mimik, einfacher Hintergrund | Publikum, das dich bereits kennt | Kanäle ohne Gesicht oder Themen, bei denen du nicht der Hook bist |
| Objekt oder Ergebnis | Das isolierte, saubere Objekt mit gerichtetem Licht | Kalte Entdeckung im Feed und Vorschläge | Wenn das Objekt bei 120 px nicht erkannt wird |
| Vorher-Nachher | Geteilte Komposition, zwei kontrastierende Zustände | Suche und konkrete Absicht | Wenn die beiden Seiten zu ähnlich sind |
Zwei Anpassungen, die wichtiger sind, als es scheint:
- Dass jede Variante eine unterschiedliche Silhouette hat. In Feed-Größe werden die Details nicht gelesen, sondern die Form. Wenn alle drei denselben dunklen Fleck in der Mitte haben, sind sie visuell dieselbe Miniatur.
- Dass das Versprechen sich nicht im Titel wiederholt. Das Bild sollte Neugier wecken, nicht das wiederholen, was der Titel bereits sagt. Wenn der Titel bereits das Ergebnis verspricht, verschwendet die Miniatur, die das Ergebnis wiederholt, die Hälfte des Raums.
Die Regel einer einzigen Variable pro Variante
Wenn du die Daten lesen möchtest, ändere jeweils nur eine Dimension. Sobald eine Variante gleichzeitig Bildausschnitt, Ausdruck, Hintergrund und Farbe ändert, ist jede Leistungsdifferenz nicht mehr interpretierbar: Du weißt, dass dieses Bild besser funktioniert, aber du weißt nicht warum, und du kannst das Lernen nicht auf das nächste Video übertragen.
Die Dimensionen, die es wert sind, isoliert zu werden, von größtem zu kleinem gewohnheitsmäßigen Effekt:
- Subjekt: Person, Objekt oder Vergleich. Es ist die grobe Dimension, die jede der drei Varianten definiert.
- Emotion: Überraschung, Euphorie, Neugier, Ernsthaftigkeit. Sie variiert innerhalb der Gesichtsvariante.
- Bildschnitt: sehr enger Schnitt im Vergleich zu einem Schnitt mit Kontext.
- Hintergrund und dominante Farbe: warm im Vergleich zu kalt, sauber im Vergleich zu überladen.
- Überlagerter Text: Präsenz, Länge und Position.
In der Praxis, mit drei Lücken: die drei Varianten ändern sich im Subjekt (Dimension 1) und innerhalb jeder hältst du alles andere gleich — dieselbe Farbpalette, denselben Lichttyp, dieselbe Textbehandlung —. So wirst du, wenn du siehst, dass eine funktioniert, wissen, dass der funktionierende Teil der Aufhänger und nicht der Farbfilter ist. Und mische den Test nicht mit einer Titeländerung gleichzeitig: eine Variable pro Experiment, auch zwischen Funktionen.
Alle drei müssen bei 120 Pixeln bestehen
Ein Thumbnail, das nur im Editor funktioniert, funktioniert nicht. Dasselbe Bild wird auf der Titelseite in großer Größe, in der Liste der Vorschläge in mittlerer Größe und im mobilen Feed mit einer Breite von nur wenigen Dutzend Pixeln angezeigt. Wenn eine deiner drei Varianten bei dieser Größe zu einem braunen Fleck wird, konkurriert sie nicht: sie verbraucht ein Drittel der Verteilung.
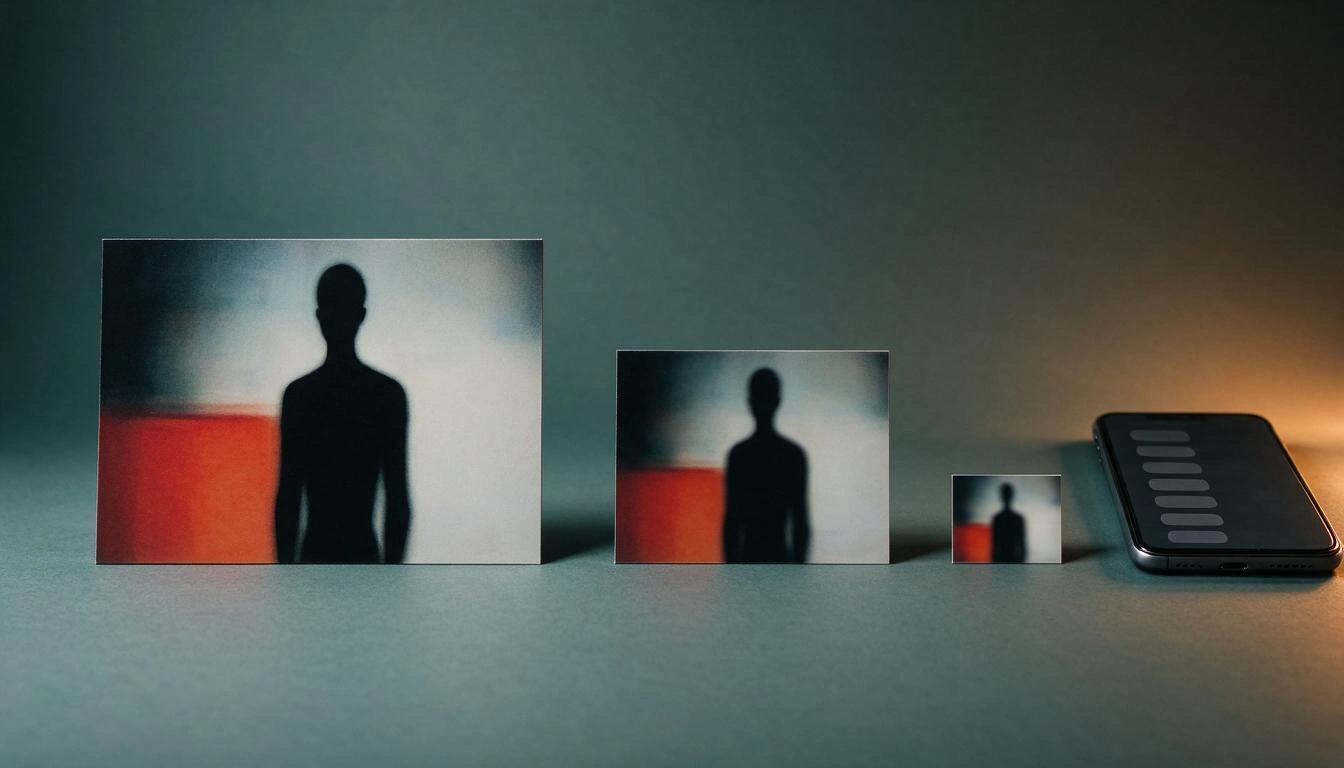
Das Spektrum der Größen weitet sich zudem an beiden Enden aus. YouTube ist bereits die Plattform mit dem größten Anteil der Fernsehdauer in den Vereinigten Staaten: ein Rekord von 15,8 % im August 2026 laut dem Nielsen Gauge, mehr als doppelt so viel wie Netflix (7,7 %) und über den 14,2 % von Juli (PPC Land, 22.10.2026). Das heißt: dasselbe Bild muss in einem 55-Zoll-Wohnzimmer und auf einem mobilen Feed-Chip lesbar sein. Dort wird das Design entschieden.
Daraus ergeben sich zwei praktische Entscheidungen:
- Teste in Originalgröße, bevor du hochlädst. Nicht mit 100 % Zoom: reduziere das Bild auf die Größen, in denen dein Publikum es sehen wird. Wenn du bei der kleinsten Größe nicht erkennst, was im Bild passiert, verwerfe es.
- Lass einen sauberen Bereich für den Text, anstatt ihn einzubetten. Ein in das Bild eingebackenes Schild kann nicht verkürzt, umplatziert oder übersetzt werden, ohne das Bild neu zu erstellen. Wenn die Komposition mit einem freien Bereich — einer Ecke, einer Seite — beginnt, kann der Text als Schicht darüber gelegt werden und du kannst ihn so oft ändern, wie du möchtest. Mit drei Varianten im Spiel und Versionen pro Sprache vervielfacht sich dieser Unterschied um drei.
Füge ein Formatdetail hinzu, das viele Leute überrascht: auf Mobilgeräten werden vertikale Videos mit 16:9-Thumbnails durch ein automatisch generiertes 4:5-Thumbnail auf Startseite, Entdecken und Abonnements ersetzt, und dein benutzerdefiniertes Bild erscheint weiterhin in den Wiedergabelisten und auf nicht-mobilen Plattformen (YouTube-Hilfe). Wenn du vertikal arbeitest, rechne mit diesem Zuschnitt.
Technische Spezifikationen: 16:9, mindestens 640 px und bis zu 50 MB
Der Arbeitsreferenz bleibt 16:9, mit einer Mindestbreite von 640 Pixeln und im Format JPG oder PNG. Was sich geändert hat, ist die Obergrenze: Die YouTube-Hilfe empfiehlt jetzt 3840×2160 (4K) und akzeptiert Dateien von bis zu 50 MB, die vom Computer hochgeladen werden, im Vergleich zu den 2 MB, die weiterhin für das Hochladen von der mobilen App gelten (YouTube-Hilfe).
| Parameter | Aktueller Wert |
|---|---|
| Verhältnis | 16:9 |
| Empfohlene Auflösung | 3840×2160 (4K) |
| Mindestbreite | 640 px |
| Formate | JPG, PNG |
| Maximale Größe (Computer) | 50 MB |
| Maximale Größe (mobile App) | 2 MB |
Was bedeutet das im Alltag:
- 1280×720 bleibt ausreichend und ist der de facto Standard der Branche: es erfüllt das Minimum und wird auf allen Oberflächen gut dargestellt. 4K wird dir keine zusätzlichen Klicks im Feed bringen.
- Wo 4K auffällt, ist auf dem Fernseher, der die Fläche ist, die am meisten gewachsen ist. Wenn dein Kanal viel im Fernsehen konsumiert wird, ist das Exportieren in 3840×2160 kein Luxus mehr.
- Die 50 MB sind ein Spielraum, kein Ziel. Ein gut komprimiertes JPG von 1280×720 wiegt ein paar hundert Kilobyte. Das Hochladen eines 40 MB PNG verbessert nichts und erschwert den Ablauf, wenn du von deinem Handy hochlädst, wo das Limit weiterhin 2 MB beträgt.
- Exportiere das gleiche Set von drei in der gleichen Größe und im gleichen Format. Wenn eine Variante in 4K und die anderen beiden in 720p sind, führst du eine Variable ein, die du nicht messen wolltest.
Was tun mit den Metriken, wenn es keinen eindeutigen Gewinner gibt
Wenn es keinen Gewinner gibt, hört das Analyseobjekt auf, das Bild zu sein, und wird zu dem Hook. Mit einem A/B-Test bekommst du das Ergebnis auf dem Silbertablett — Gewinner, "gleiche Leistung" oder nicht schlüssig, je nach Rahmen, den Search Engine Journal beschreibt —. Bei dynamischen Thumbnails gibt es kein Urteil: Es gibt drei Bilder, die gleichzeitig funktionieren, und was du herausfinden musst, ist welcher Art von Versprechen welche Teile deines Publikums anspricht.
Solange YouTube nicht veröffentlicht, welche Aufschlüsselung nach Variante du im Studio sehen wirst, ist es sinnvoll, dein eigenes Protokoll zu führen. Ein Blatt mit einer Zeile pro Video und diesen Spalten ist ab dem ersten Tag nützlich:
- Video und Veröffentlichungsdatum.
- Hook jeder Variante (Gesicht / Objekt / Vorher-Nachher) und eine einzeilige Notiz über den Rahmen.
- Welche Dimension hast du absichtlich variiert und was hast du fix gehalten.
- CTR und vollständige Video-Retention auf Videoebene.
- Verteilung nach Traffic-Quelle (Suche, Vorschläge, Feed, Abonnements), was dir am nächsten kommt, um Segmente zu sehen.
Und drei Regeln zur Lesung:
- Ändere nicht die Kriterien mitten in der Saison. Mit ein bis vier Videos pro Monat dauert eine nützliche Stichprobe Monate. Wenn jedes Video etwas anderes testet, wirst du niemals etwas haben, was du vergleichen kannst.
- Betrachte das Gesamtbild, nicht die Variante. Die richtige Frage ist nicht "Welcher hat gewonnen?", sondern "Hat dieses Trio mehr qualifizierte Klicks gebracht als das vorherige Video mit einem einzigen Thumbnail?".
- Wiederverwende den Hook, der sich wiederholt, nicht das Bild. Wenn "isoliertes Objekt" in deiner Nische drei Videos hintereinander funktioniert, was du gelernt hast, ist ein Rezept für die Komposition, kein Archiv.
Wie ThumbLab in diesen Fluss passt
Drei Thumbnails mit unterschiedlichen Hooks zu produzieren und sie in Originalgröße zu überprüfen, ist im Wesentlichen der Fluss, für den ThumbLab gebaut wurde, das Labor für YouTube-Thumbnails mit KI von AIsToHire. Konkret die vier Teile, die dieser Artikel verlangt:
- Varianten basierend auf deinen eigenen Referenzen. Du lädst bis zu 6 Bilder hoch und sagst jedem seine Rolle — dein Gesicht, das Produkt, der Hintergrund, eine Stilreferenz — und die KI komponiert darauf basierend, im Format 16:9 oder 9:16 für Shorts. Jede Serie liefert zwei vergleichbare A/B-Varianten, sodass du das Trio von drei Hooks in zwei Serien montierst, indem du das Subjekt wechselst, was genau die Dimension ist, die du isolieren möchtest. Du kannst bis zu 10 Personen mit ihren Fotos speichern, um dein Gesicht nicht bei jedem Video erneut hochladen zu müssen.
- Bereichsretusche, ohne das Bild neu zu erstellen. Du markierst einen Bereich auf dem Thumbnail und forderst die Änderung an: ein Element löschen, ersetzen, das Licht anpassen oder den Ausdruck ändern. Es wird eine neue Variante erstellt und das Original geht nicht verloren, was du brauchst, wenn du eine einzige Dimension anpasst und zurückgehen möchtest.
- Der Text als editierbare Ebene, nicht gebacken. Das Bild wird ohne Buchstaben und mit einem sauberen reservierten Bereich generiert. Schriftart, Farbe, Umriss, Position im 3×3-Raster und numerisches Badge werden darüber komponiert und sofort bearbeitet, auch in anderen Sprachen, und werden beim Export gerastert. Das Ändern des Schildes oder das Übersetzen kostet keine neue Generierung.
- Realitätsprüfung in 360, 168 und 120 px. Bevor du irgendetwas ins Studio hochlädst, siehst du die drei Varianten in der Größe, in der dein Publikum sie sehen wird, mit einem Mockup der YouTube-Oberfläche, und verwirfst die, die zu einem Fleck werden. Es gibt außerdem eine CTR-Bewertung der endgültigen Komposition und den Export in JPG und PNG 1280×720, JPG 4K und 1080×1920 für Shorts.
Ehrlich gesagt: ThumbLab lädt die Thumbnails nicht für dich auf YouTube hoch und aktiviert die dynamischen Thumbnails — das macht YouTube, wenn dein Kanal im Rollout ist —. Was es dir erspart, ist der Teil, der sich verdreifacht hat: das Set von drei zu produzieren und es zu filtern, bevor es ins Studio gelangt.
Häufig gestellte Fragen
Wie viele Miniaturen kann ich pro Video mit dynamischen Miniaturen hochladen?
Bis zu drei. YouTube beschreibt sie als "die beste von drei Optionen", die verschiedenen Segmenten des Publikums serviert werden (YouTube Blog, 23.09.2026). Im Gegensatz zum A/B-Test konkurrieren die drei, während das Video veröffentlicht ist, anstatt sich auf einen Gewinner zu reduzieren.
Sind die dynamischen Miniaturen bereits auf meinem Kanal verfügbar?
Wahrscheinlich noch nicht. Sie wurden am 23. September 2026 angekündigt und die Bereitstellung erfolgt schrittweise an berechtigte Creator im restlichen Jahr 2026, Kanal für Kanal (Miraflow). YouTube hat keine Anforderungen an die Berechtigung oder ein allgemeines Verfügbarkeitsdatum veröffentlicht, daher ist der beste Weg, regelmäßig im Studio nachzusehen.
Was ist der Unterschied zwischen dynamischen Miniaturen und dem A/B-Test von Miniaturen?
Der A/B-Test ist ein zeitlich begrenztes Experiment, das bis zu drei Pakete nach Sehdauer anordnet und am Ende einen einzigen Gewinner für das gesamte Publikum anwendet, innerhalb von bis zu zwei Wochen. Dynamische Miniaturen wählen keinen Gewinner aus: Sie koppeln jedes der drei Bilder mit dem Segment, das am besten passt, und halten sie unbegrenzt aktiv.
Welche drei Miniaturen sollte ich vorbereiten?
Eine mit einem klaren Gesichtsausdruck, eine vom Objekt oder dem isolierten Ergebnis und eine von vorher-nachher geteilt. Es sind drei Kompositionen mit unterschiedlichem Silhouetten und drei Klickmotive, die sich nicht überschneiden: der Abonnent, der dir folgt, der Unbekannte, der das Thema entdeckt, und derjenige, der nach einer konkreten Transformation sucht. Drei Anpassungen des gleichen Rahmens geben dem System nichts zu verteilen.
Welche Größe sollte eine YouTube-Miniatur im Jahr 2026 haben?
Seitenverhältnis 16:9, mindestens 640 Pixel breit, im JPG- oder PNG-Format. Die YouTube-Hilfe empfiehlt jetzt 3840×2160 (4K) und akzeptiert bis zu 50 MB von einem Computer, im Gegensatz zu den 2 MB, die weiterhin für Uploads von der mobilen App gelten (YouTube-Hilfe). 1280×720 erfüllt weiterhin mehr als ausreichend für den Feed.
Ist es besser, den Text in das Bild einzufügen oder ihn als Schicht darüber zu legen?
Als Schicht darüber, insbesondere mit drei Varianten im Spiel. Ein Text, der innerhalb des Bildes generiert wird, kann nicht verkürzt, neu platziert oder übersetzt werden, ohne das gesamte Bild neu zu erstellen; eine Textschicht kann in Sekunden bearbeitet und beim Export gerastert werden. Die Komposition so zu gestalten, dass ein sauberer Bereich für den Text reserviert ist, ermöglicht diese Trennung.
Wie weiß ich, welche Variante funktioniert, wenn es keinen eindeutigen Gewinner gibt?
Indem du aufhörst, Bilder zu analysieren, und anfängst, Haken zu analysieren. Notiere für jedes Video, welche Art von Versprechen jede Variante verwendet hat und welche Dimensionen du absichtlich variiert hast, und korreliere das mit dem CTR, der Retention und der Verteilung nach Traffic-Quelle des Videos. Mit ein bis vier Videos pro Monat kommt das nützliche Lernen durch Ansammlung von Monaten, nicht durch Videos.
Der wirkliche Wandel ist in der Produktion, nicht im Design
Dynamische Miniaturen erhöhen nicht den Designstandard: sie erhöhen das Produktionsvolumen. Du wechselst von einem Bild pro Video zu drei mit unterschiedlichen Versprechungen, und du musst auch sicherstellen, dass alle drei von einem Fernseher bis zu einem mobilen Feed-Chip bestehen. Für einen Kanal einer Person mit ein bis vier Videos pro Monat ist das der echte Engpass, und den gilt es zu lösen, bevor dein Kanal in die Bereitstellung eintritt.
Wenn du dieses Spiel aus drei ohne einen Bildbearbeitungseditor aufbauen möchtest, deckt ThumbLab von AIsToHire genau diesen Abschnitt ab: Varianten A/B aus deinen eigenen Referenzen generieren, bereichsweise retuschieren, ohne das Bild neu zu erstellen, den Text als bearbeitbare und übersetzbare Schicht hinzufügen und den Realitätscheck bei 360, 168 und 120 Pixeln bestehen, bevor du etwas ins Studio hochlädst. Du kannst mit dem Video beginnen, das du gerade im Miniaturenlabor für YouTube hast.
Erstelle dein Set aus drei Thumbnails in ThumbLab: Generiere A/B-Varianten aus deinen eigenen Referenzen, bearbeite sie in Zonen, füge den Text als editierbare Ebene hinzu und überprüfe in 360, 168 und 120 px, welche bestehen, bevor du sie in Studio hochlädst. Registriere dich kostenlos und teste es mit dem Video, das du gerade bearbeitest.
Erstelle dein Set aus drei Thumbnails in ThumbLab: Generiere A/B-Varianten aus deinen eigenen Referenzen, bearbeite sie in Zonen, füge den Text als editierbare Ebene hinzu und überprüfe in 360, 168 und 120 px, welche bestehen, bevor du sie in Studio hochlädst. Registriere dich kostenlos und teste es mit dem Video, das du gerade bearbeitest.Weiterlesen
Alle Artikel ansehen →
Wie man 2026 Miniaturen für YouTube erstellt: offizielle Maße, der 120-Pixel-Test und ein 5-Schritte-Prozess

Warum Ihre Autoversicherung 2026 gestiegen ist: Durchschnittsprämie von 1.412 € und historischer Rekord

Über WhatsApp diskutieren oder persönlich sprechen: Was sagt die Wissenschaft über Konflikte in Beziehungen durch Nachrichten
