 ThumbLab
תמונות ממוזערות דינמיות ביוטיוב: איך מכינים את 3 התמונות שהמערכת החדשה דורשת
הצוות של ThumbLabנכתב בעזרת בינה מלאכותית14 דקות קריאהבקצרה
- ב־Made on YouTube ב־23 בספטמבר 2026 הציגה יוטיוב את התמונות הממוזערות הדינמיות: מעלים עד שלוש תמונות לאותו סרטון, והפלטפורמה "ממליצה על הטובה מבין שלוש האפשרויות לפלחים שונים של הקהל שלך" (YouTube Blog, 23/09/2026).
- זה לא מבחן ה־A/B הרגיל. בדיקה והשוואה מחלקת עד שלוש חבילות, שופטת אותן לפי נתח זמן צפייה במשך שבועיים לכל היותר, ובסוף בוחרת מנצחת אחת לכולם. התמונה הממוזערת הדינמית לא בוחרת: היא מחלקת ומקיימת את כולן במקביל.
- ההשקה היא הדרגתית ליוצרים זכאים לאורך שארית 2026, ערוץ אחר ערוץ, ויוטיוב עדיין לא פרסמה תנאי זכאות או תאריך מחייב.
- העבודה החדשה היא לא ליצור תמונה ממוזערת טובה יותר, אלא להפיק שלוש עם הוקים שונים באמת: פנים ורגש, אובייקט או תוצאה, לפני־ואחרי. שלושה ליטושים של אותה קומפוזיציה לא נותנים למערכת שום דבר לחלק.
- הצד הטכני: 16:9, רוחב מינימלי של 640 פיקסלים, JPG או PNG, עד 50 MB ממחשב ו־2 MB מאפליקציית המובייל, עם 3840×2160 (4K) כרזולוציה המומלצת במרכז העזרה של יוטיוב.
אם אתה מפרסם בין סרטון אחד לארבעה בחודש ובונה את התמונות הממוזערות בעצמך, התמונות הממוזערות הדינמיות משנות לך את המשימה: עד היום הפקת תמונה אחת והגנת עליה; מעכשיו אתה מפיק סט של שלוש, וכל אחת צריכה לנצח קהל אחר. המאמר הזה סוקר מה ידוע ממקורות על התכונה, איך מעצבים שלישייה שהמערכת יכולה לחלק, ואיך לבדוק אותה לפני העלאה ל־Studio. בסוף תראה איך ThumbLab, המעבדה של AIsToHire לתמונות ממוזערות ליוטיוב בבינה מלאכותית, משתלבת בתהליך הספציפי הזה.

מהן תמונות ממוזערות דינמיות ביוטיוב?
תמונות ממוזערות דינמיות הן תכונה שהוכרזה ב־23 בספטמבר 2026 ב־Made on YouTube, שמאפשרת לשייך עד שלוש תמונות ממוזערות לאותו סרטון ומשאירה ליוטיוב להחליט איזו תמונה להציג לכל קבוצת צופים, לפי הסבירות המוערכת שלהם ללחוץ וליצור אינטראקציה. אין תמונה רשמית אחת לסרטון: אנשים שונים רואים תמונות שונות, וממשיכים לראות אותן כל עוד הסרטון מפורסם.
התיאור המילולי ב־YouTube Blog הוא שאפשר "ליצור תמונות ממוזערות מותאמות לערוץ או להשתמש בתמונות ממוזערות דינמיות כדי שיוטיוב תמליץ על הטובה מבין שלוש האפשרויות לפלחים שונים של הקהל שלך". TechCrunch סיכם זאת באותו יום כהעלאת כמה אפשרויות של תמונה ממוזערת והשארת ההחלטה למערכת, שקובעת אוטומטית איזו גרסה להציג לכל צופה לפי פוטנציאל האינטראקציה החזוי שלו.
יש שני דברים שכדאי להפנים לפני שמתכננים משהו:
- זה לא זמין בכל הערוצים. ניתוח ההשקה של Miraflow מתאר פריסה הדרגתית לאורך שארית 2026 שמגיעה "ערוץ אחר ערוץ, במקום להיפתח לכולם בבת אחת", הדפוס הרגיל של תכונות הבינה המלאכותית ב־Studio.
- חסרים פרטים ציבוריים. נכון להיום יוטיוב לא פרסמה תנאי זכאות, תאריך זמינות כללית או אילו מדדים לכל וריאנט תראה ב־Studio. כל מדריך שנותן לך אחוזי חלוקה מדויקים ממציא אותם.
מה שכן ברור הוא המשימה היצירתית. ואותה אפשר להכין כבר עכשיו.
במה הן שונות ממבחן ה־A/B של תמונות ממוזערות שכבר היה קיים?
ההבדל הוא סוף הסיפור. מבחן ה־A/B של יוטיוב (בדיקה והשוואה) הוא ניסוי עם תאריך תפוגה: הוא מחלק עד שלוש חבילות של כותרת ותמונה ממוזערת בין פלחים אקראיים של הקהל האמיתי שלך, מדרג אותן לפי נתח זמן צפייה ולאחר כמה שעות, או עד שבועיים, מחיל מנצחת אחת לכולם ומסיר את השאר. התמונה הממוזערת הדינמית לא מסתיימת ולא פוסלת: היא משאירה את שלושתן חיות ומקצה כל אחת לפלח שמתאים לה יותר.
נתון המדד הוא של יוטיוב: כשהסבירה את מבחן ה־A/B של כותרות, אמרה שהוא מבצע אופטימיזציה לפי "זמן צפייה כולל ולא לפי מדדים אחרים כמו CTR", לפי הסיקור של Search Engine Journal על ההשקה הגלובלית ב־4 בדצמבר 2025. והנפח המצטבר מסביר למה יוטיוב ממשיכה למשוך בחוט הזה: יוצרים ביצעו יותר מ־40 מיליון ניסויים של כותרות ותמונות ממוזערות מאז שהתכונה הושקה רשמית ב־2024 (YouTube Blog, 23/09/2026).
| מבחן A/B (בדיקה והשוואה) | תמונות ממוזערות דינמיות | |
|---|---|---|
| מה מעלים | עד 3 כותרות, תמונות ממוזערות או שילובים | עד 3 תמונות ממוזערות |
| איך מחלקים | פלחים אקראיים של הקהל | לפי פלח קהל, לפי התאמה חזויה |
| מה מכריע | נתח זמן צפייה | לא פורסם; התאמה לפי פלח |
| משך | מכמה ימים עד שבועיים | כל עוד הסרטון מפורסם |
| תוצאה | מנצחת אחת לכולם; השאר מוסרות | שלושתן מתקיימות במקביל |
| תוצאות אפשריות | מנצחת, "ביצועים שווים" או לא חד־משמעי | בלי מנצחת יחידה |
| מצב (12/11/2026) | גלובלי מאז 04/12/2025, מחשב ווידאו ארוך | השקה הדרגתית ליוצרים זכאים |
שתי התכונות לא מתחרות: מבחן ה־A/B משמש לגלות איזה הוק עובד, והתמונה הממוזערת הדינמית כדי לנצל את העובדה שכמה הוקים עובדים עם קהלים שונים במקום לזרוק שניים מתוך שלושה לפח. יוטיוב גם דוחפת לאותו כיוון בדרכים אחרות: Ask Studio יוכל, באישורך, לעקוב אחר הביצועים של תמונות ממוזערות בסרטונים ישנים וליצור בדיקות כדי לרענן אותן, וב־2027 מבחן ה־A/B יורחב לשלושה קטעים שונים של Short (TechCrunch, 23/09/2026).
הבעיה החדשה: שלוש תמונות ממוזערות הן לא שלוש גרסאות של אותה תמונה
הטעות שתעלה הכי ביוקר היא להעלות שלושה וריאנטים של אותה קומפוזיציה, אותו צילום עם פילטר אחר, רקע אחר או חץ שהוזז, ולצפות לחלוקה. אם שלוש התמונות מבטיחות אותו דבר, אין מה לפלח: המערכת לא יכולה להתאים כל אפשרות לקהל אחר, כי שלושתן מדברות לאותו קהל. הדבר הרגיל הוא שאחת תאכל את החלוקה והשאר יישארו כקישוט.
תחשוב על זה הפוך: אתה לא בוחר בין שלוש תמונות, אתה כותב שלוש הבטחות לשלוש סיבות שונות ללחיצה.
- המנוי שעוקב אחריך כבר שנתיים לוחץ בגללך אתה: הפנים שלך, התגובה שלך, מה שקרה לך.
- הזר מהפיד לוחץ בגלל האובייקט או התוצאה: מה זה, כמה עלה, איך יצא.
- מי שמגיע מחיפוש לוחץ בגלל השינוי: מצב המוצא והמצב הסופי באותה תמונה.
אלה שלושה קוראים שונים של אותו סרטון. זה בדיוק חומר הגלם שהתמונה הממוזערת הדינמית צריכה, וזה סוג ההבדל שלא נולד מליטוש של תמונה אחת.
שלושת ההוקים שכן מתחלקים: פנים, אובייקט ולפני־ואחרי
לסרטון ממוצע, השלישייה שמכסה בצורה הטובה ביותר קהלים שונים היא: (1) פנים ורגש, (2) אובייקט או תוצאה מבודדים ו(3) לפני־ואחרי מפוצל. אלה שלוש קומפוזיציות עם היררכיה חזותית שונה, אדם, דבר והשוואה, ולכן הן נבדלות גם בגודל זעיר ופונות למניעים שאינם חופפים.
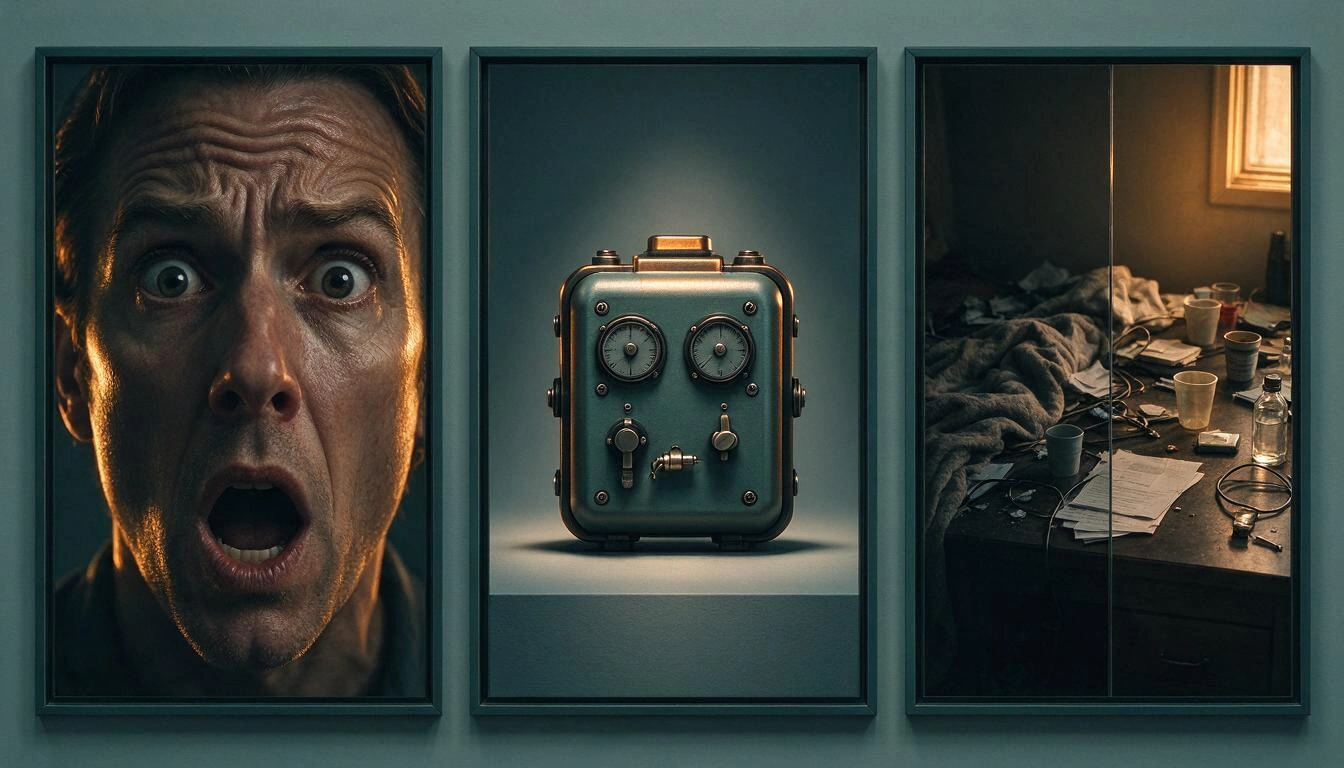
| וריאנט | מה ממלא את הפריים | למי הוא מכוון | מתי הוא נכשל |
|---|---|---|---|
| פנים ורגש | קלוז־אפ, הבעה ברורה, רקע פשוט | קהל שכבר מכיר אותך | ערוצים בלי פנים או נושאים שבהם אתה לא ההוק |
| אובייקט או תוצאה | האובייקט מבודד, נקי, עם תאורה מכוונת | גילוי קר בפיד ובמוצעים | כשהאובייקט לא מזוהה ב־120 פיקסלים |
| לפני־ואחרי | קומפוזיציה מפוצלת, שני מצבים מנוגדים | חיפוש וכוונה ספציפית | אם שני הצדדים דומים מדי |
שתי התאמות שחשובות יותר ממה שנראה:
- שלכל וריאנט תהיה צללית שונה. בגודל של פיד לא קוראים פרטים, קוראים צורה. אם בשלושתן יש אותו כתם כהה במרכז, מבחינה חזותית זו אותה תמונה ממוזערת.
- שההבטחה לא תחזור על הכותרת. התמונה צריכה להוסיף עניין, לא לכתוב כתוביות למה שהכותרת כבר אומרת. אם הכותרת כבר מבטיחה את התוצאה, תמונה שחוזרת על התוצאה מבזבזת חצי מהמקום.
כלל המשתנה האחד לכל וריאנט
אם אתה רוצה להיות מסוגל לקרוא את הנתונים, שנה רק ממד אחד בכל פעם. ברגע שוריאנט משנה בבת אחת קומפוזיציה, הבעה, רקע וצבע, כל הבדל בביצועים מפסיק להיות ניתן לפירוש: אתה יודע שהתמונה הזו עובדת טוב יותר, אבל לא יודע למה, ואי אפשר להעביר את הלקח לסרטון הבא.
הממדים ששווה לבודד, מההשפעה הרגילה הגבוהה לנמוכה:
- הנושא: אדם, אובייקט או השוואה. זה הממד הגס, זה שמגדיר כל אחד משלושת הוריאנטים.
- רגש: הפתעה, אופוריה, סקרנות, רצינות. משנים אותו בתוך וריאנט הפנים.
- קומפוזיציה: שוט צמוד מאוד לעומת שוט עם הקשר.
- רקע וצבע דומיננטי: חם מול קר, נקי מול עמוס.
- טקסט מעל: נוכחות, אורך ומיקום.
בפועל, עם שלושה מקומות: שלושת הוריאנטים משתנים בנושא (ממד 1), ובתוך כל אחד משאירים את כל השאר זהה, אותה פלטה, אותו סוג תאורה, אותו טיפול בטקסט. כך, כשתראה שאחד עובד, תדע שמה שעובד הוא ההוק ולא פילטר הצבע. ואל תערבב את הבדיקה עם החלפת כותרת בו בזמן: משתנה אחד לכל ניסוי, גם בין תכונות.
שלושתן צריכות להחזיק מעמד ב־120 פיקסלים
תמונה ממוזערת שעובדת רק בעורך לא עובדת. אותה תמונה מוגשת בדף הסרטון בגודל גדול, ברשימת המוצעים בגודל בינוני ובפיד במובייל ברוחב של כמה עשרות פיקסלים בלבד. אם אחד משלושת הוריאנטים שלך הופך לכתם חום בגודל הזה, הוא לא מתחרה: הוא מבזבז שליש מהחלוקה.
טווח הגדלים גם מתרחב משני הקצוות. יוטיוב היא כבר הפלטפורמה עם נתח הזמן הגדול ביותר בצפייה בטלוויזיה בארצות הברית: שיא של 15.8% באוגוסט 2026 לפי ה־Gauge של Nielsen, יותר מכפליים מ־Netflix (7.7%) ומעל 14.2% ביולי (PPC Land, 22/10/2026). כלומר: אותה תמונה צריכה להיקרא בסלון עם מסך של 55 אינץ' וגם בצ'יפ בפיד במובייל. שם מוכרע העיצוב.
מכאן שתי החלטות מעשיות:
- בדוק בגודל אמיתי לפני ההעלאה. לא בזום של 100%: מקטינים את התמונה לגדלים שבהם הקהל שלך יראה אותה. אם בגודל הקטן ביותר אתה לא מבחין מה קורה בתמונה, פסול אותה.
- שמור אזור נקי לטקסט במקום להטמיע אותו. כיתוב שנאפה בתוך התמונה אי אפשר לקצר, להזיז או לתרגם בלי ליצור את התמונה מחדש. אם הקומפוזיציה נולדת עם אזור פנוי, פינה או צד, הטקסט מונח מעל כשכבה ואפשר לשנות אותו כמה פעמים שרוצים. עם שלושה וריאנטים במשחק וגרסאות לפי שפה, ההבדל הזה מוכפל פי שלושה.
הוסף פרט פורמט שתופס הרבה אנשים לא מוכנים: במובייל, סרטונים אנכיים עם תמונה ממוזערת 16:9 מוחלפים בתמונה ממוזערת 4:5 שנוצרת אוטומטית בדף הבית, בחקור ובמנויים, והתמונה המותאמת שלך ממשיכה להופיע בפידים של ההשמעה ובפלטפורמות שאינן מובייל (מרכז העזרה של יוטיוב). אם אתה עובד אנכית, קח בחשבון את החיתוך הזה.
מפרט טכני: 16:9, 640 פיקסלים לפחות ועד 50 MB
נקודת הייחוס לעבודה היא עדיין 16:9, עם רוחב מינימלי של 640 פיקסלים ופורמט JPG או PNG. מה ששינה הוא התקרה: מרכז העזרה של יוטיוב ממליץ כעת על 3840×2160 (4K) ומאפשר קבצים עד 50 MB שמועלים ממחשב, לעומת 2 MB שממשיכים לחול על העלאה מאפליקציית המובייל (מרכז העזרה של יוטיוב).
| פרמטר | ערך נוכחי |
|---|---|
| יחס | 16:9 |
| רזולוציה מומלצת | 3840×2160 (4K) |
| רוחב מינימלי | 640 px |
| פורמטים | JPG, PNG |
| גודל מרבי (מחשב) | 50 MB |
| גודל מרבי (אפליקציית מובייל) | 2 MB |
מה זה אומר ביום־יום:
- 1280×720 עדיין מספיק והוא התקן בפועל בתעשייה: הוא עומד במינימום ומוצג היטב בכל המשטחים. ה־4K לא יביא לך יותר קליקים בפיד.
- המקום שבו ה־4K כן מורגש הוא מסך הטלוויזיה, המשטח שצמח הכי הרבה. אם הערוץ שלך נצרך הרבה בטלוויזיה, ייצוא ב־3840×2160 הופך מגחמה לצורך.
- 50 ה־MB הם מרווח, לא יעד. JPG מכווץ היטב ב־1280×720 שוקל כמה מאות קילובייטים. העלאת PNG של 40 MB לא משפרת דבר ומסבכת את התהליך אם אתה מעלה מהמובייל, שם המגבלה עדיין 2 MB.
- ייצא את אותו סט של שלוש באותו גודל ופורמט. אם וריאנט אחד ב־4K ושני האחרים ב־720p, אתה מכניס משתנה שלא רצית למדוד.
מה עושים עם המדדים כשאין מנצחת יחידה
כשאין מנצחת, מושא הניתוח מפסיק להיות התמונה והופך להיות ההוק. במבחן A/B התוצאה מגיעה מוכנה, מנצחת, "ביצועים שווים" או לא חד־משמעי, לפי המסגרת שSearch Engine Journal מתארת. עם תמונות ממוזערות דינמיות אין פסק דין: יש שלוש תמונות שפועלות בו זמנית, ומה שצריך להפיק מהן הוא איזה סוג הבטחה מושך איזה חלק מהקהל שלך.
כל עוד יוטיוב לא מפרסמת איזה פילוח לכל וריאנט תראה ב־Studio, הדבר הנבון הוא להקים רישום משלך. גיליון עם שורה לכל סרטון והעמודות האלה משמש מהיום הראשון:
- הסרטון ותאריך הפרסום.
- ההוק של כל וריאנט והערה בשורה אחת על הקומפוזיציה.
- איזה ממד שינית בכוונה ומה השארת קבוע.
- CTR ושימור של הסרטון השלם, ברמת הסרטון.
- חלוקה לפי מקור תנועה (חיפוש, מוצעים, פיד, מנויים), הדבר הקרוב ביותר שתגיע אליו לראות פלחים.
ושלושה כללי קריאה:
- אל תשנה קריטריון באמצע העונה. עם סרטון אחד עד ארבעה בחודש, מדגם שימושי לוקח חודשים. אם כל סרטון בודק משהו אחר, לעולם לא יהיה לך מה להשוות.
- הסתכל על הסט, לא על הוריאנט. השאלה הנכונה היא לא "איזו ניצחה?", אלא "האם השלישייה הזו הביאה יותר קליקים איכותיים מהסרטון הקודם עם תמונה ממוזערת אחת?".
- השתמש מחדש בהוק שחוזר על עצמו, לא בתמונה. אם "אובייקט מבודד" עובד בנישה שלך שלושה סרטונים ברצף, מה שלמדת הוא מתכון קומפוזיציה, לא קובץ.
איך ThumbLab משתלב בתהליך הזה
להפיק שלוש תמונות ממוזערות עם הוקים שונים ולבדוק אותן בגודל אמיתי זה, בעיקרו של דבר, התהליך שבשבילו נבנה ThumbLab, המעבדה של AIsToHire לתמונות ממוזערות ליוטיוב בבינה מלאכותית. ליתר דיוק, ארבעת החלקים שהמאמר הזה דורש:
- וריאנטים מהייחוסים שלך. מעלים עד 6 תמונות ואומרים לכל אחת מה התפקיד שלה, הפנים שלך, המוצר, הרקע, ייחוס סגנון, והבינה המלאכותית מרכיבה משם, ב־16:9 או ב־9:16 עבור Shorts. כל סבב נותן שני וריאנטים A/B שאפשר להשוות, כך ששלישיית שלושת ההוקים נבנית בשני סבבים עם החלפת הנושא, בדיוק הממד שאתה רוצה לבודד. אפשר לשמור עד 10 אנשים עם התמונות שלהם כדי לא להעלות את הפנים שלך מחדש בכל סרטון.
- רטוש לפי אזורים, בלי ליצור את התמונה מחדש. מסמנים אזור על התמונה הממוזערת ומבקשים את השינוי: מחיקת אלמנט, החלפתו, כוונון התאורה או שינוי ההבעה. נוצר וריאנט חדש והמקור לא הולך לאיבוד, וזה מה שצריך כשמכוונים ממד אחד ורוצים להיות מסוגלים לחזור אחורה.
- הטקסט כשכבה ניתנת לעריכה, לא אפוי. התמונה נוצרת בלי אותיות ועם אזור נקי שמור. גופן, צבע, קו מתאר, מיקום ברשת 3×3 ותג מספרי מורכבים מעל ונערכים מיד, גם בשפות אחרות, ומרסטרים בעת הייצוא. שינוי הכיתוב או תרגומו לא עולה יצירה חדשה.
- בדיקת מציאות ב־360, 168 ו־120 פיקסלים. לפני שמעלים משהו ל־Studio רואים את שלושת הוריאנטים בגודל שבו הקהל שלך יראה אותם, עם דמות של ממשק יוטיוב, ופוסלים את אלה שהופכות לכתם. יש גם ציון CTR של הקומפוזיציה הסופית וייצוא ל־JPG ו־PNG ב־1280×720, JPG ב־4K ו־1080×1920 עבור Shorts.
בכנות: ThumbLab לא מעלה את התמונות הממוזערות ליוטיוב בשבילך ולא מפעיל את התמונות הממוזערות הדינמיות, את זה עושה יוטיוב כשהערוץ שלך ייכנס להשקה. מה שהוא חוסך לך הוא החלק שהוכפל פי שלושה: להפיק את סט השלוש ולסנן אותו לפני שהוא מגיע ל־Studio.
שאלות נפוצות
כמה תמונות ממוזערות אפשר להעלות לסרטון עם תמונות ממוזערות דינמיות?
עד שלוש. יוטיוב מתארת אותן כ"הטובה מבין שלוש האפשרויות" שמוגשת לפלחים שונים של הקהל (YouTube Blog, 23/09/2026). בניגוד למבחן ה־A/B, שלושתן מתקיימות במקביל כל עוד הסרטון מפורסם, במקום להצטמצם למנצחת אחת.
האם תמונות ממוזערות דינמיות כבר זמינות בערוץ שלי?
כנראה עדיין לא. הן הוכרזו ב־23 בספטמבר 2026 וההשקה הדרגתית ליוצרים זכאים לאורך שארית 2026, ערוץ אחר ערוץ (Miraflow). יוטיוב לא פרסמה תנאי זכאות או תאריך זמינות כללית, ולכן הדרך היא לבדוק את Studio מדי פעם.
מה ההבדל בין תמונות ממוזערות דינמיות למבחן ה־A/B של תמונות ממוזערות?
מבחן ה־A/B הוא ניסוי זמני שמדרג עד שלוש חבילות לפי נתח זמן צפייה ובסוף מחיל מנצחת אחת על כל הקהל, בתוך עד שבועיים. תמונות ממוזערות דינמיות לא בוחרות מנצחת: הן מתאימות כל אחת משלוש התמונות לפלח שמתאים לה יותר ומשאירות אותן פעילות ללא הגבלת זמן.
אילו שלוש תמונות ממוזערות כדאי להכין?
אחת של פנים עם רגש ברור, אחת של האובייקט או התוצאה מבודדים ואחת של לפני־ואחרי מפוצל. אלה שלוש קומפוזיציות עם צללית שונה ושלוש סיבות ללחיצה שאינן חופפות: המנוי שעוקב אחריך, הזר שמגלה את הנושא ומי שמחפש שינוי מסוים. שלושה ליטושים של אותה קומפוזיציה לא נותנים למערכת שום דבר לחלק.
איזה גודל צריכה להיות תמונה ממוזערת ביוטיוב ב־2026?
יחס 16:9, רוחב מינימלי של 640 פיקסלים, ב־JPG או PNG. מרכז העזרה של יוטיוב ממליץ כעת על 3840×2160 (4K) ומאפשר עד 50 MB ממחשב, לעומת 2 MB שממשיכים לחול על העלאה מאפליקציית המובייל (מרכז העזרה של יוטיוב). 1280×720 עדיין עומד בדרישות בהחלט עבור הפיד.
עדיף להכניס את הטקסט בתוך התמונה או להניח אותו כשכבה מעל?
כשכבה מעל, במיוחד עם שלושה וריאנטים במשחק. כיתוב שנוצר בתוך התמונה אי אפשר לקצר, להזיז או לתרגם בלי ליצור מחדש את כל התמונה; שכבת טקסט נערכת בשניות ומרסטרת בעת הייצוא. תכנון הקומפוזיציה עם אזור נקי שמור לטקסט הוא מה שמאפשר את ההפרדה הזו.
איך אני יודע איזה וריאנט עובד אם אין מנצחת יחידה?
מפסיקים לנתח תמונות ומתחילים לנתח הוקים. רושמים לכל סרטון איזה סוג הבטחה השתמש בו כל וריאנט ואיזה ממד שינית בכוונה, ומצליבים זאת עם ה־CTR, השימור והחלוקה לפי מקור תנועה של הסרטון. עם סרטון אחד עד ארבעה בחודש, הלמידה השימושית מגיעה מהצטברות של חודשים, לא מסרטון בודד.
השינוי האמיתי הוא בהפקה, לא בעיצוב
תמונות ממוזערות דינמיות לא מעלות את רף העיצוב: הן מעלות את נפח ההפקה. עוברים מתמונה אחת לסרטון לשלוש עם הבטחות שונות, ובנוסף צריך לוודא ששלושתן מחזיקות מעמד מהסלון עם הטלוויזיה ועד צ'יפ בפיד במובייל. עבור ערוץ של אדם אחד עם סרטון אחד עד ארבעה בחודש, זה צוואר הבקבוק האמיתי, וכדאי לפתור אותו לפני שהערוץ שלך נכנס להשקה.
אם אתה רוצה להרכיב את הסט של שלוש בלי לפתוח עורך תמונות, ThumbLab של AIsToHire מכסה בדיוק את הקטע הזה: יצירת וריאנטי A/B מהייחוסים שלך, ריטוש לפי אזורים בלי ליצור מחדש את התמונה, הנחת הטקסט כשכבה ניתנת לעריכה ולתרגום, ומעבר בדיקת המציאות ב־360, 168 ו־120 פיקסלים לפני שמעלים משהו ל־Studio. אפשר להתחיל מהסרטון שנמצא אצלך באמצע במעבדת התמונות הממוזערות ליוטיוב.
הרכב את סט שלוש התמונות הממוזערות שלך ב־ThumbLab: צור וריאנטי A/B מהייחוסים שלך, רטוש לפי אזורים, הנח את הטקסט כשכבה ניתנת לעריכה ובדוק ב־360, 168 ו־120 פיקסלים אילו מהן מחזיקות מעמד לפני שאתה מעלה אותן ל־Studio. הירשם בחינם ונסה זאת עם הסרטון שנמצא אצלך באמצע.
הרכב את סט שלוש התמונות הממוזערות שלך ב־ThumbLab: צור וריאנטי A/B מהייחוסים שלך, רטוש לפי אזורים, הנח את הטקסט כשכבה ניתנת לעריכה ובדוק ב־360, 168 ו־120 פיקסלים אילו מהן מחזיקות מעמד לפני שאתה מעלה אותן ל־Studio. הירשם בחינם ונסה זאת עם הסרטון שנמצא אצלך באמצע.להמשך קריאה
כל המאמרים →
איך מכינים תמונות ממוזערות ל-YouTube ב-2026: מידות רשמיות, בדיקת 120 הפיקסלים ותהליך של 5 שלבים

להתווכח בוואטסאפ או לדבר פנים אל פנים: מה המדע אומר על קונפליקטים זוגיים בהודעות

מפת חשיבה, מפה מושגית ומתאר: ההבדלים ומתי להשתמש בכל אחד
