 ThumbLab
YouTube 動態縮圖:如何準備新系統要求的 3 張圖片
团队: ThumbLab在 AI 协助下撰写15 分鐘閱讀重點摘要
- 在 2026 年 9 月 23 日的 Made on YouTube 大會上,YouTube 發表了動態縮圖:同一支影片最多可上傳三張圖片,平台會「向不同的觀眾群推薦三個選項中最好的那一個」(YouTube Blog,2026/09/23)。
- 這不是以往的 A/B 測試。測試與比較最多會分配三組素材,以觀看時間占比評斷,最長進行兩週,最後選出一個對所有人通用的優勝者。動態縮圖則不選擇:它是分配並讓三者並存。
- 推出方式是在 2026 年剩餘時間內逐步開放給符合資格的創作者,一個頻道一個頻道地進行,YouTube 目前尚未公布資格條件或確切日期。
- 新的工作不是把縮圖做得更好,而是製作三張鉤子真正不同的縮圖——臉孔與情緒、物件或成果、前後對比。同一個構圖的三次微調,無法給系統任何可分配的東西。
- 技術面:16:9,寬度至少 640 px,JPG 或 PNG,從電腦上傳最大 50 MB、從行動 App 上傳最大 2 MB,YouTube 說明文件建議的解析度為 3840×2160(4K)。
如果你每月製作一到四支影片,縮圖也是自己做,那麼動態縮圖會改變你的工作內容:過去你只需產出一張圖並為它辯護;從現在起,你要產出一組三張,而且每一張都得贏得不同的觀眾。本文整理目前有來源可查的功能資訊、如何設計一組系統能夠分配的三張縮圖,以及如何在上傳到 Studio 之前先驗證。最後你會看到 AIsToHire 的 AI YouTube 縮圖實驗室 ThumbLab,如何融入這個具體流程。

什麼是 YouTube 動態縮圖?
動態縮圖是在 2026 年 9 月 23 日 Made on YouTube 大會上公布的功能,可讓你為同一支影片關聯最多三張縮圖,並由 YouTube 依據預估的點擊與互動機率,決定向每一群觀眾顯示哪一張圖片。影片沒有唯一的官方圖片:不同的人看到不同的縮圖,而且只要影片仍在發布狀態,就會一直如此。
YouTube Blog 的原文描述是,你可以「產生符合頻道風格的縮圖,或使用動態縮圖,讓 YouTube 向不同的觀眾群推薦三個選項中最好的那一個」。TechCrunch 當天將其概括為:上傳多個縮圖選項,由系統依據預期的互動潛力,自動判斷向每位觀眾顯示哪一個版本。
在規劃任何事情之前,有兩件事必須先接受:
- 並非所有頻道都有。Miraflow 的推出分析描述了 2026 年剩餘時間內的逐步開放,會「一個頻道一個頻道地推出,而不是一次對所有人啟用」,這是 Studio AI 功能的慣常模式。
- 公開細節不足。截至今日,YouTube 尚未公布資格條件、全面開放日期,也沒有說明你在 Studio 中會看到哪些各版本指標。任何給你具體分配百分比的指南,都是在憑空捏造。
可以確定的是創作上的要求。而這一點現在就可以開始準備。
它與原本的縮圖 A/B 測試有什麼不同?
差別在於故事的結局。YouTube 的 A/B 測試(測試與比較)是有期限的實驗:它會把最多三組標題與縮圖素材,分配給你真實觀眾中隨機的幾個群組,依觀看時間占比排名,並在數小時到最多兩週後,套用一個對所有人通用的優勝者,同時淘汰其餘的。動態縮圖則永不結束、也不淘汰:它讓三張縮圖都保持有效,並把每一張分配給最適合的觀眾群。
指標的資料來自 YouTube:根據 Search Engine Journal 對 2025 年 12 月 4 日全球推出的報導,YouTube 在說明標題 A/B 測試時表示,它是針對「總觀看時間,而非 CTR 等其他指標」進行最佳化。而累積的使用量,也說明了 YouTube 為什麼持續朝這個方向推進:自 2024 年該功能正式推出以來,創作者已進行超過 4,000 萬次標題與縮圖實驗(YouTube Blog,2026/09/23)。
| A/B 測試(測試與比較) | 動態縮圖 | |
|---|---|---|
| 上傳內容 | 最多 3 個標題、縮圖或組合 | 最多 3 張縮圖 |
| 分配方式 | 觀眾的隨機分組 | 依觀眾群,根據預估的契合度 |
| 決定依據 | 觀看時間占比 | 未公布;依觀眾群的契合度 |
| 期間 | 數天到 2 週 | 只要影片仍在發布狀態 |
| 結果 | 一個通用優勝者;其餘淘汰 | 三張並存 |
| 可能的結局 | 優勝者、「表現相同」或無法定論 | 沒有唯一的優勝者 |
| 狀態(2026/11/12) | 自 2025/12/04 起全球開放,桌面版與長影片 | 逐步開放給符合資格的創作者 |
這兩項功能並不互相競爭:A/B 測試幫你找出哪種鉤子有效,動態縮圖則是善用不同鉤子對不同觀眾各自有效這一點,而不是把三張裡的兩張丟進垃圾桶。YouTube 在其他方面也朝著同一個方向推進:Ask Studio 在你同意後,將能監看舊影片的縮圖表現並建立測試來重新整理它們,而在 2027 年,A/B 測試將擴展到 一支 Short 的三個不同剪輯版本(TechCrunch,2026/09/23)。
新的問題:三張縮圖不是同一張的三個版本
代價最高的錯誤,是上傳同一個構圖的三個變體——同一張照片換個濾鏡、換個背景,或把箭頭挪個位置——然後期待系統去分配。如果三張圖片承諾的是同一件事,就沒有什麼可以區隔:系統無法把每個選項配對給不同的觀眾,因為這三張對著同一群人說話。通常的結果是,其中一張吃掉了全部的流量,其餘只是擺設。
反過來想:你不是在三張圖片中做選擇,而是在為三種不同的點擊動機寫下三個承諾。
- 已經追蹤你兩年的訂閱者,會因為你而點擊:你的臉、你的反應、你遇到的事。
- 動態消息中的陌生人,會因為物件或成果而點擊:那是什麼東西、花了多少錢、結果如何。
- 從搜尋進來的人,會因為轉變而點擊:起始狀態與最終狀態出現在同一張圖片裡。
這是同一支影片的三種不同讀者。這正是動態縮圖所需的原料,也是只靠微調單一圖片無法產生的那種差異。
真正能被分配的三種鉤子:臉孔、物件與前後對比
對一般影片而言,最能涵蓋不同觀眾的組合是:(1) 臉孔與情緒、(2) 單獨呈現的物件或成果,以及 (3) 分割式前後對比。這是三種視覺層次各異的構圖——一個人、一件東西、一組對照——所以即使縮到很小也能區分,並且訴諸互不重疊的動機。
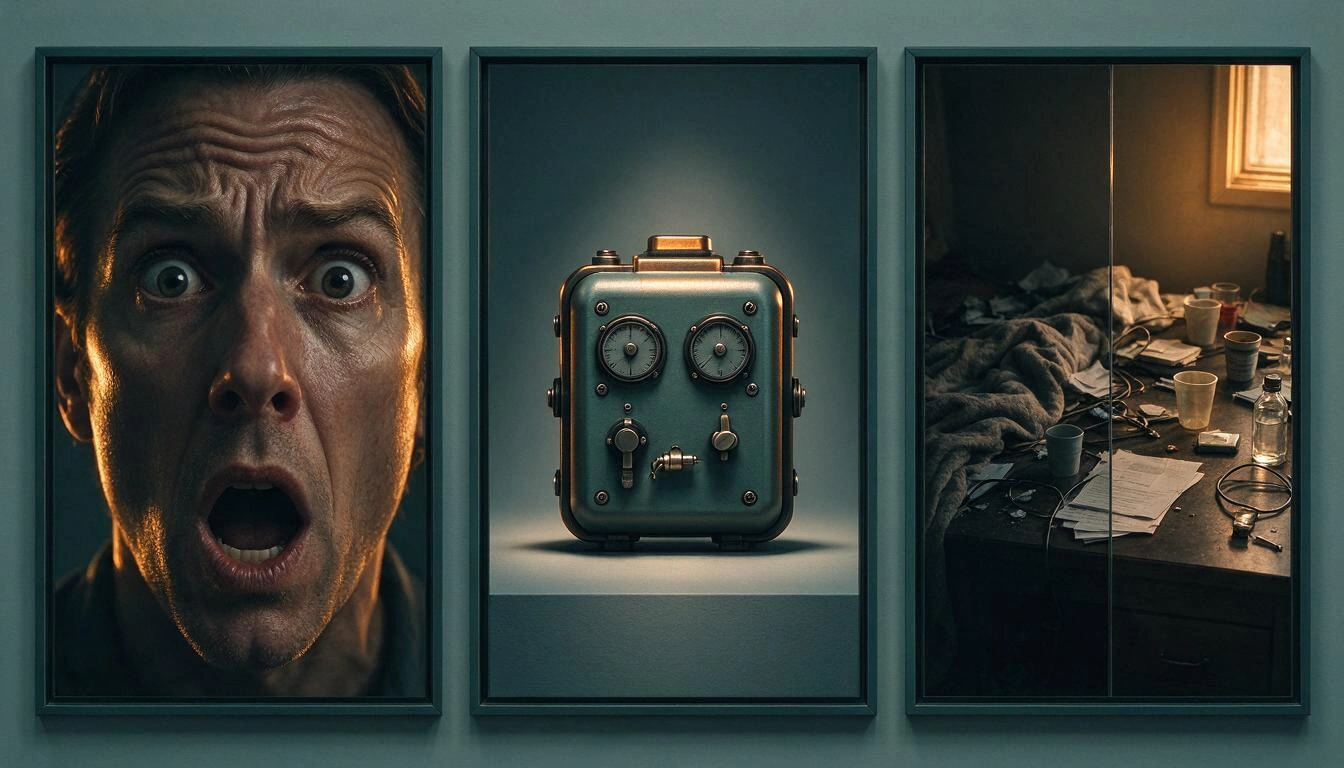
| 變體 | 畫面主體 | 針對對象 | 何時會失效 |
|---|---|---|---|
| 臉孔與情緒 | 特寫、表情清晰、背景簡單 | 已經認識你的觀眾 | 沒有露臉的頻道,或你本人不是賣點的主題 |
| 物件或成果 | 單獨、乾淨、打了定向光的物件 | 在動態消息與推薦中冷啟動探索 | 物件在 120 px 下無法辨認時 |
| 前後對比 | 分割式構圖,兩種對比鮮明的狀態 | 搜尋與明確意圖 | 兩側看起來太相似時 |
有兩個調整,比看起來更重要:
- 讓每個變體都有不同的剪影。在動態消息的尺寸下,看不到細節,只看得到形狀。如果三張的中央都是同一團深色,那麼從視覺上看,它們就是同一張縮圖。
- 讓承諾不要與標題重複。圖片應該增添懸念,而不是替標題已經說過的內容加上字幕。如果標題已經承諾了結果,那麼重複結果的縮圖就浪費了一半的空間。
每個變體只改變一個變數的規則
如果你想看懂資料,每次只改變一個維度。一旦某個變體同時改變了構圖、表情、背景與色彩,任何表現上的差異就都無法解讀:你知道那張圖表現較好,卻不知道原因,也無法把學到的經驗帶到下一支影片。
值得單獨隔離的維度,依通常影響由大到小排列:
- 主體:人物、物件或對照。這是最粗的維度,定義了三個變體各自是什麼。
- 情緒:驚訝、興奮、好奇、嚴肅。在臉孔變體內部調整。
- 構圖:大特寫與帶有情境的鏡位。
- 背景與主色:暖色與冷色、乾淨與繁雜。
- 疊加文字:有無、長度與位置。
實務上,有三個名額:三個變體改變的是主體(維度 1),而在每個變體內部,其他一切都保持不變——相同的色盤、相同類型的光線、相同的文字處理方式。這樣一來,當你看到某一張有效,就會知道有效的是鉤子,而不是色彩濾鏡。也不要在做測試的同時更換標題:每次實驗只改一個變數,不同功能之間也一樣。
三張都要能在 120 像素下撐住
只在編輯器裡有效的縮圖,就是無效的縮圖。同一張圖片會以大尺寸出現在首頁,以中等尺寸出現在推薦清單,並以僅有數十像素寬的尺寸出現在行動版動態消息。如果你三個變體中的某一個,在那個尺寸下變成一團棕色,它就不是在競爭:它是在白白耗掉三分之一的流量。
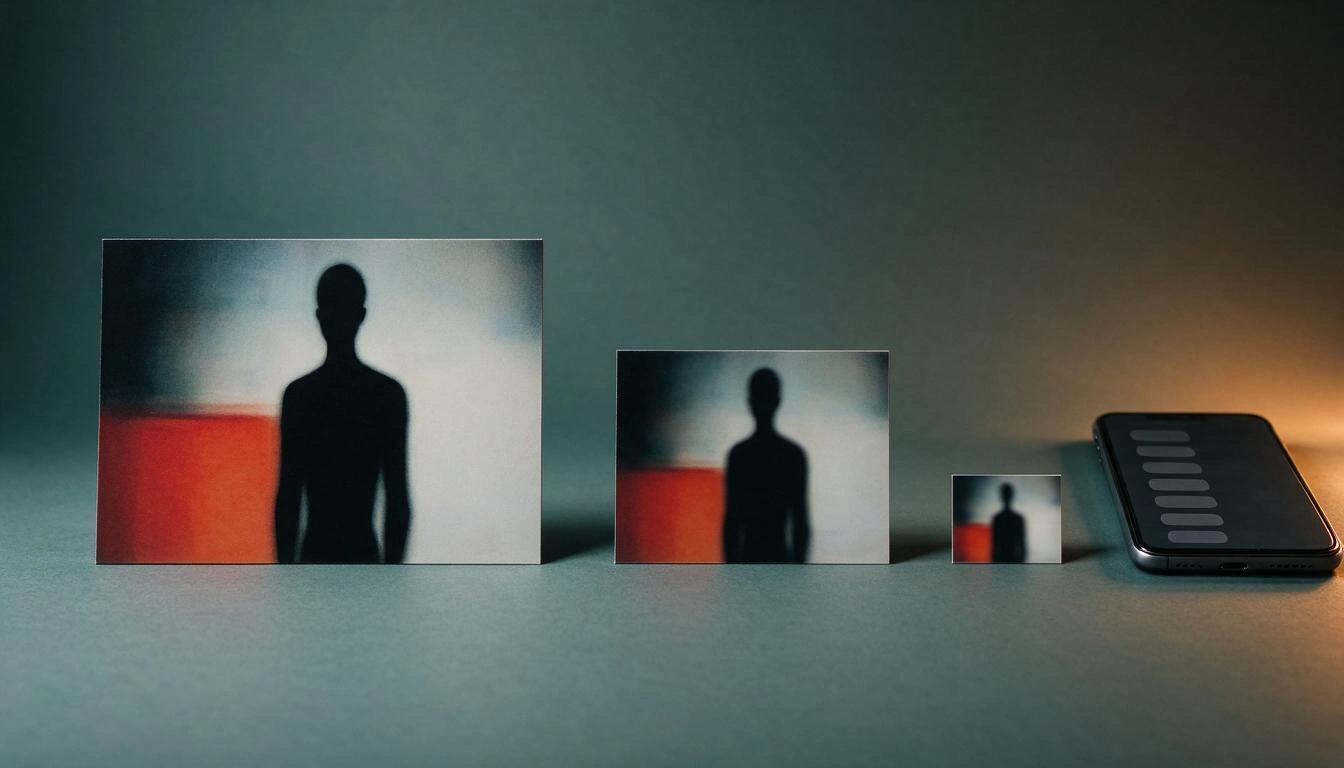
此外,尺寸的範圍正從兩端同時拓寬。YouTube 如今已是在美國電視觀看時間中占比最高的平台:根據 Nielsen 的 Gauge,2026 年 8 月創下 15.8% 的紀錄,是 Netflix(7.7%)的兩倍以上,並高於 7 月的 14.2%(PPC Land,2026/10/22)。也就是說:同一張圖片既要能在 55 吋的客廳電視上辨讀,也要能在行動版動態消息的小縮圖上辨讀。設計的成敗就在這裡。
由此衍生兩個實務決定:
- 上傳前以實際尺寸測試。不是放大到 100% 檢視,而是把圖片縮小到觀眾實際會看到的尺寸。如果在最小的尺寸下,你分不出圖片裡發生了什麼事,就捨棄它。
- 預留一塊乾淨的文字區域,而不是把文字嵌進去。燒進圖片的標語無法縮短、無法重新排版,也無法翻譯,除非重新生成圖片。如果構圖一開始就留有空白區域——一個角落、一側——文字就可以作為圖層疊在上面,你想改多少次都可以。當有三個變體、還要加上各語言版本時,這個差別會乘上三倍。
另外補充一個讓很多人措手不及的格式細節:在行動裝置上,使用 16:9 縮圖的直式影片,會在首頁、探索與訂閱內容中被自動產生的 4:5 縮圖取代,而你的自訂圖片仍會出現在播放動態與非行動平台上(YouTube 說明)。如果你製作的是直式內容,要把這種裁切算進去。
技術規格:16:9、最小 640 px、最大 50 MB
工作上的基準仍然是 16:9,寬度至少 640 像素,格式為 JPG 或 PNG。改變的是上限:YouTube 說明文件現在建議使用 3840×2160(4K),並接受從電腦上傳最大 50 MB 的檔案,而從行動 App 上傳則仍適用 2 MB 的限制(YouTube 說明)。
| 參數 | 目前數值 |
|---|---|
| 比例 | 16:9 |
| 建議解析度 | 3840×2160(4K) |
| 最小寬度 | 640 px |
| 格式 | JPG、PNG |
| 檔案大小上限(電腦) | 50 MB |
| 檔案大小上限(行動 App) | 2 MB |
這在日常使用上意味著:
- 1280×720 仍然足夠,也是業界的事實標準:它符合最低要求,在所有版位上都能良好呈現。4K 不會讓你在動態消息中獲得更多點擊。
- 4K 真正看得出差別的地方是電視螢幕,也是成長最快的版位。如果你的頻道有很多人用電視觀看,以 3840×2160 匯出就不再是奢侈的選項。
- 50 MB 是餘裕,不是目標。壓縮良好的 1280×720 JPG 只有幾百 KB。上傳一個 40 MB 的 PNG 不會帶來任何好處,而且如果你是從手機上傳,限制仍是 2 MB,只會讓流程更麻煩。
- 用相同的尺寸與格式匯出同一組三張。如果一個變體是 4K,另外兩個是 720p,你就引入了一個你原本不想測量的變數。
沒有唯一優勝者時,指標該怎麼看
沒有優勝者的時候,分析的對象不再是圖片,而是鉤子。A/B 測試會把結果整理好交給你——優勝者、「表現相同」或無法定論,這是 Search Engine Journal 所描述的框架。動態縮圖則沒有裁決:有三張圖片同時在運作,你要萃取的是哪一種承諾能吸引你觀眾中的哪一部分。
在 YouTube 公布 Studio 會顯示哪些各版本的細分數據之前,比較明智的做法是自己建立一份紀錄。一份每支影片一列、包含下列欄位的試算表,從第一天起就能派上用場:
- 影片與發布日期。
- 各變體的鉤子(臉孔/物件/前後對比),以及一行關於構圖的備註。
- 你刻意改變了哪個維度、固定了哪些。
- 整支影片層級的 CTR 與留存率。
- 依流量來源(搜尋、推薦、動態消息、訂閱內容)的分布,這是你最接近看見各觀眾群的方式。
以及三條判讀規則:
- 不要在一季中途改變標準。每月一到四支影片,要累積出有用的樣本需要好幾個月。如果每支影片都在測不同的東西,你就永遠沒有可比較的對象。
- 看整體,而不是單一變體。正確的問題不是「哪一張贏了?」,而是「這一組三張,帶來的優質點擊,是否比上一支只用一張縮圖的影片更多?」。
- 重複使用反覆奏效的鉤子,而不是圖片。如果「單獨呈現的物件」在你的領域連續三支影片都有效,你學到的是一種構圖配方,而不是一個檔案。
ThumbLab 如何融入這個流程
製作三張鉤子各異的縮圖,並以實際尺寸檢驗,本質上正是 ThumbLab 所設計的流程,它是 AIsToHire 的 AI YouTube 縮圖實驗室。具體來說,就是本文所要求的四個環節:
- 從你自己的參考圖產生變體。你最多可上傳 6 張圖片,並告訴每一張的角色——你的臉、產品、背景、風格參考——AI 就會據此構圖,格式為 16:9,或 Shorts 使用的 9:16。每次生成會給出兩個可比較的 A/B 變體,所以三種鉤子的組合只要兩次生成、改變主體即可完成,而這正是你想隔離的維度。你最多可以儲存 10 個人物及其照片,不必每支影片都重新上傳自己的臉。
- 分區修圖,不必重做整張圖。在縮圖上標出一個區域並提出修改:刪除某個元素、替換它、調整光線,或改變表情。它會建立新的變體,而且原圖不會遺失,當你只調整單一維度並想隨時回到先前版本時,這正是你需要的。
- 文字是可編輯的圖層,而不是燒進圖片。圖片生成時不含文字,並預留一塊乾淨的區域。字體、顏色、描邊、3×3 網格中的位置與數字徽章都疊在上面組合,並可即時編輯,包括其他語言,匯出時才會轉為點陣圖。更換標語或翻譯它,不需要花一次新的生成。
- 360、168 與 120 px 的現實檢驗。在把任何東西上傳到 Studio 之前,你可以搭配 YouTube 介面模擬,以觀眾實際會看到的尺寸檢視三個變體,並淘汰那些變成一團模糊的。此外還有針對最終構圖的 CTR 評分,並可匯出 JPG 與 PNG 1280×720、JPG 4K,以及 Shorts 使用的 1080×1920。
老實說:ThumbLab 不會替你把縮圖上傳到 YouTube,也不會啟用動態縮圖——那是 YouTube 在你的頻道進入推出範圍時才會做的事。它幫你省下的,是已經變成三倍的那一部分:製作這組三張,並在它到達 Studio 之前先篩選過。
常見問題
使用動態縮圖時,每支影片可以上傳幾張縮圖?
最多三張。YouTube 將其描述為向不同觀眾群提供的「三個選項中最好的那一個」(YouTube Blog,2026/09/23)。與 A/B 測試不同,只要影片仍在發布狀態,三張縮圖會並存,而不是縮減為一個優勝者。
我的頻道現在已經可以使用動態縮圖了嗎?
很可能還不行。該功能於 2026 年 9 月 23 日公布,並在 2026 年剩餘時間內逐步開放給符合資格的創作者,一個頻道一個頻道地推出(Miraflow)。YouTube 尚未公布資格條件或全面開放日期,所以只能定期檢查 Studio。
動態縮圖與縮圖 A/B 測試有什麼差別?
A/B 測試是暫時性的實驗,依觀看時間占比為最多三組素材排名,並在最長兩週內,對所有觀眾套用一個唯一的優勝者。動態縮圖不選優勝者:它把三張圖片各自配對給最適合的觀眾群,並無限期保持有效。
我應該準備哪三張縮圖?
一張帶有明確情緒的臉孔、一張單獨呈現的物件或成果,以及一張分割式的前後對比。這是三種剪影各異的構圖,也是三種互不重疊的點擊動機:追蹤你的訂閱者、發現這個主題的陌生人,以及尋找特定轉變的人。同一個構圖的三次微調,無法給系統任何可分配的東西。
2026 年的 YouTube 縮圖應該是多大?
比例 16:9,寬度至少 640 像素,格式為 JPG 或 PNG。YouTube 說明文件現在建議使用 3840×2160(4K),並接受從電腦上傳最大 50 MB 的檔案,而從行動 App 上傳則仍適用 2 MB 的限制(YouTube 說明)。對動態消息而言,1280×720 依然綽綽有餘。
文字放在圖片裡比較好,還是作為圖層疊在上面比較好?
作為圖層疊在上面比較好,尤其是在有三個變體的情況下。生成在圖片內部的標語,無法在不重新生成整張圖片的情況下縮短、重新排版或翻譯;文字圖層則可以在幾秒鐘內編輯,並在匯出時轉為點陣圖。把構圖設計成預留一塊乾淨的文字區域,正是讓這種分離成為可能的關鍵。
如果沒有唯一的優勝者,我怎麼知道哪個變體有效?
停止分析圖片,開始分析鉤子。針對每支影片記錄各變體使用了哪種承諾,以及你刻意改變了哪個維度,並與該影片的 CTR、留存率與流量來源分布交叉比對。以每月一到四支影片來說,有用的學習來自數個月的累積,而不是單一影片。
真正的改變在於製作,而不在於設計
動態縮圖並沒有拉高設計的門檻:它拉高的是製作量。你從每支影片一張圖片,變成三張承諾各異的圖片,而且還得確認這三張從客廳電視到行動版動態消息的小縮圖都撐得住。對於每月一到四支影片的單人頻道而言,這是真正的瓶頸,也是在你的頻道進入推出範圍之前最值得先解決的事。
如果你想在不開啟圖片編輯器的情況下組出這一組三張,AIsToHire 的 ThumbLab 剛好涵蓋這一段:用你自己的參考圖產生 A/B 變體、分區修圖而不必重做整張圖、把文字設為可編輯且可翻譯的圖層,並在把任何東西上傳到 Studio 之前,先通過 360、168 與 120 像素的現實檢驗。你可以從手上做到一半的影片開始,進入 YouTube 縮圖實驗室。
在 ThumbLab 組出你的三張縮圖組合:用自己的參考圖產生 A/B 版本、分區修圖、把文字設為可編輯圖層,並在 360、168 與 120 px 下確認哪些撐得住,再上傳到 Studio。免費註冊,用你手上做到一半的影片試試看。
在 ThumbLab 組出你的三張縮圖組合:用自己的參考圖產生 A/B 版本、分區修圖、把文字設為可編輯圖層,並在 360、168 與 120 px 下確認哪些撐得住,再上傳到 Studio。免費註冊,用你手上做到一半的影片試試看。


