 Aeopro
Pourquoi ChatGPT ne cite pas votre site web : l'audit AEO que presque personne ne fait correctement
Équipe de AeoproRédigé avec l'aide de l'IA20 min de lectureEn résumé
- Il existe trois familles de bots IA, pas une : ceux de formation (GPTBot, ClaudeBot, Google-Extended), ceux de recherche et citation (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Bingbot) et ceux déclenchés par l'utilisateur (ChatGPT-User, Claude-User, Perplexity-User). Bloquer les premiers est une décision légitime ; bloquer les seconds, c'est disparaître des réponses.
- Bloquer
GPTBotne bloque pasOAI-SearchBot, et bloquerGoogle-Extendedne te sort pas des AI Overviews : Google documente que ce token n'affecte pas l'inclusion dans Google Search (Google Search Central). - Si ton contenu n'apparaît qu'après l'exécution de JavaScript, il existe des bots qui verront une page presque vide. Le diagnostic se fait en comparant le HTML brut avec le DOM rendu.
llms.txtn'est pas la solution : Google dit que tu n'as pas besoin de créer des fichiers texte pour l'IA ni de schéma spécial pour apparaître dans les AI Overviews ou le Mode IA (Google, AI features), et John Mueller a déclaré en janvier 2026 que Google ne soutient pasllms.txt(Search Engine Roundtable, 20-janv-2026).- Le trafic que renvoient les moteurs d'IA est faible et coûteux à obtenir : Cloudflare a évalué en juillet 2025 qu'avec OpenAI, il est "750 fois plus difficile" d'obtenir une visite qu'avec Google d'avant, et avec Anthropic "30 000 fois" (Cloudflare, 1-juil-2025).
Si tu es arrivé ici en cherchant pourquoi ChatGPT ne cite pas ton site, la réponse est rarement "mon contenu n'est pas bon". Dans la plupart des cas audités, le problème est technique et ennuyeux : une ligne dans le robots.txt, un WAF qui renvoie 403 à tout user-agent étrange, ou un site conçu comme une application à page unique dont le texte n'existe pas jusqu'à ce que le navigateur exécute JavaScript. Cet article explique comment chaque chose est vérifiée manuellement et avec quelles sources, et à la fin, tu verras comment Aeopro, l'outil d'audit AEO de AIsToHire, automatise les mêmes vérifications sur une URL.
Qu'est-ce que l'AEO et en quoi diffère-t-il du SEO ?
L'AEO (Answer Engine Optimization) est le travail de préparation d'un site web pour que les moteurs de réponse —ChatGPT, Claude, Perplexity, Gemini, Copilot— puissent le lire, le comprendre et le citer lors de la génération d'une réponse. Le SEO classique optimise pour une liste de dix liens bleus ; l'AEO optimise pour être l'une des trois ou quatre sources que le modèle résume et relie. Ils partagent beaucoup (indexabilité, performance, contenu utile), mais ont des défauts propres que le SEO traditionnel n'a jamais mesurés.
La différence pratique : un site impeccable pour Google peut être invisible pour un moteur d'IA s'il bloque le bot qui cite, s'il répond 403 à ce bot ou si son texte ne se rend que côté client. Et inversement : Google affirme qu'il n'y a pas d'exigences supplémentaires pour apparaître dans les AI Overviews ou le Mode IA au-delà des bonnes pratiques de SEO (Google Search Central, AI features). Autrement dit : dans l'écosystème Google, l'AEO consiste surtout à ne rien casser ; dans l'écosystème OpenAI/Anthropic/Perplexity, il existe des directives spécifiques que tu dois gérer.
| SEO classique | AEO / moteurs de réponse | |
|---|---|---|
| Objectif | Position dans la SERP | Être source citée dans la réponse |
| Bot qui importe | Googlebot, Bingbot | OAI-SearchBot, Claude-SearchBot, PerplexityBot, Bingbot, Googlebot |
| Unité de contenu | La page | Le passage autonome |
| Signal technique critique | Indexabilité | Accessibilité au bot + contenu en HTML sans JS |
| Métrique | Position, clics, CTR | Pourcentage d'apparition dans les réponses, citations |
| Contrôle de coupe | — | nosnippet, max-snippet, data-nosnippet |
Les bots IA se divisent en trois familles et les confondre coûte cher
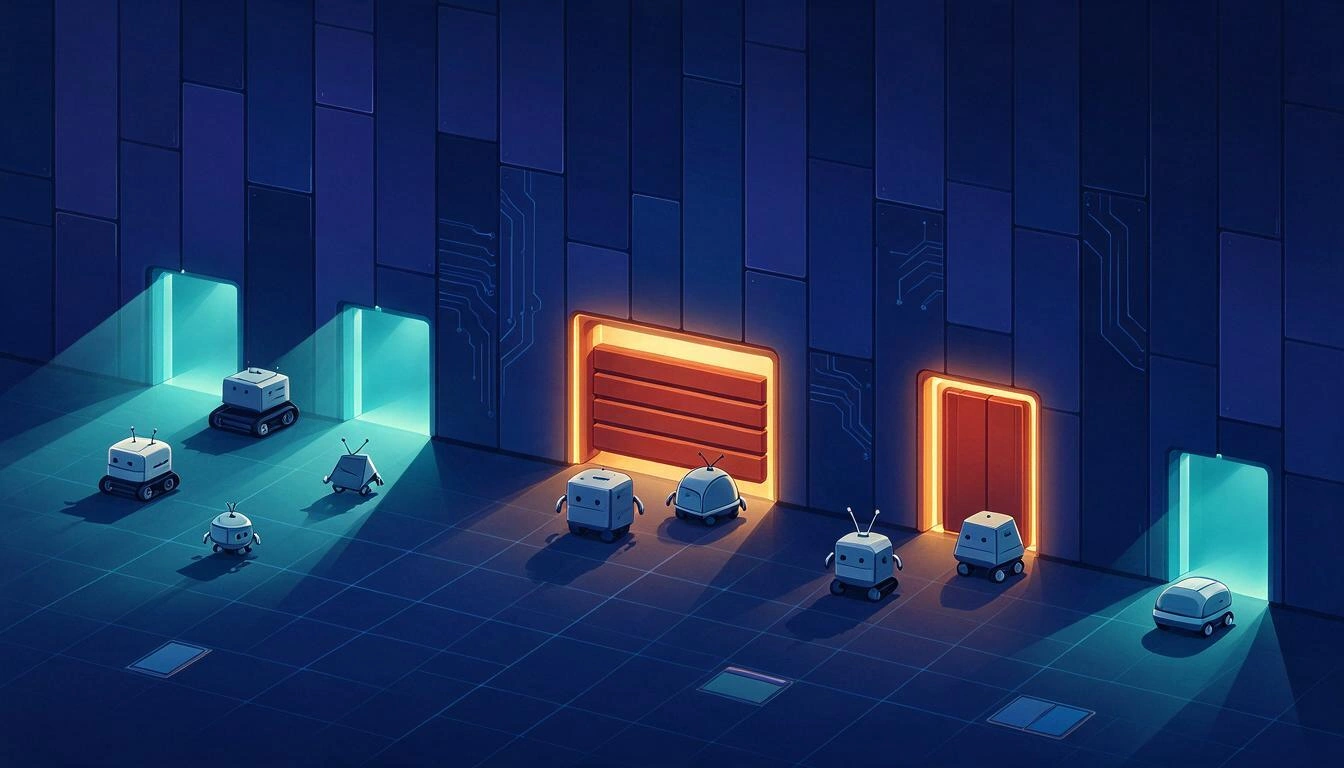
Il existe trois types de robots et chacun est contrôlé par son propre jeton dans robots.txt: entraînement, recherche/citation et fetch déclenché par l'utilisateur. Bloquer celui de l'entraînement est une décision commerciale parfaitement raisonnable —vous ne voulez pas alimenter des modèles gratuitement—; bloquer celui de recherche signifie que l'assistant ne peut pas vous lire lorsque quelqu'un demande ce que vous vendez. Presque tous les robots.txt "anti-IA" copiés depuis des forums bloquent les deux choses en même temps sans le vouloir.
Voici le tableau qu'il est utile d'avoir sous les yeux, avec la documentation officielle de chaque fournisseur :
| User-agent | Fournisseur | À quoi ça sert | Le bloquer vous prive-t-il de citations ? |
|---|---|---|---|
GPTBot | OpenAI | Entraînement de modèles | Non |
OAI-SearchBot | OpenAI | Indexation pour la recherche de ChatGPT | Oui |
ChatGPT-User | OpenAI | Visite déclenchée par un utilisateur | Oui (OpenAI avertit que les règles de robots.txt peuvent ne pas s'appliquer) |
OAI-AdsBot | OpenAI | Vérification des pages d'atterrissage des annonces sur ChatGPT | Non |
ClaudeBot | Anthropic | Entraînement | Non |
Claude-SearchBot | Anthropic | Indexation pour les résultats de recherche | Oui |
Claude-User | Anthropic | Visite lorsqu'un utilisateur demande à Claude | Oui |
PerplexityBot | Perplexity | Indexer et lier dans les résultats | Oui |
Perplexity-User | Perplexity | Visite déclenchée par l'utilisateur (ignore robots.txt, selon sa doc) | Oui |
Google-Extended | Entraînement et grounding de Gemini | N'affecte pas Google Search | |
Bingbot | Microsoft | Index de Bing (et produits qui l'utilisent) | Oui |
Sources : OpenAI, documentation des bots; Anthropic, suivi web; Perplexity, bots; Google, robots communs. Consultées le 26 octobre 2026.
Trois nuances que presque personne n'applique correctement :
- Les jetons sont indépendants.
DisallowpourGPTBotn'affecte pasOAI-SearchBot, niClaudeBotàClaude-SearchBot. Chaque agent a besoin de son propre groupe. - Les fetchers d'utilisateur jouent avec d'autres règles. OpenAI documente que, parce qu'ils sont initiés par une personne, les règles de
robots.txtpeuvent ne pas s'appliquer àChatGPT-User; Perplexity dit directement quePerplexity-Usera tendance à les ignorer. Compter uniquement surrobots.txtpour "fermer la porte" ne fonctionne pas de manière uniforme. Google-Extendedn'est pas l'interrupteur des AI Overviews. Google documente que ce jeton gère l'entraînement et le grounding de Gemini, et que "cela n'affecte pas l'inclusion du site dans Google Search ni n'est utilisé comme signal de classement". Pour limiter ce que Google affiche dans ses fonctionnalités IA, les contrôles sontnosnippet,data-nosnippet,max-snippetetnoindex.
Si votre texte n'existe que après l'exécution de JavaScript, pour une IA votre page peut être vide
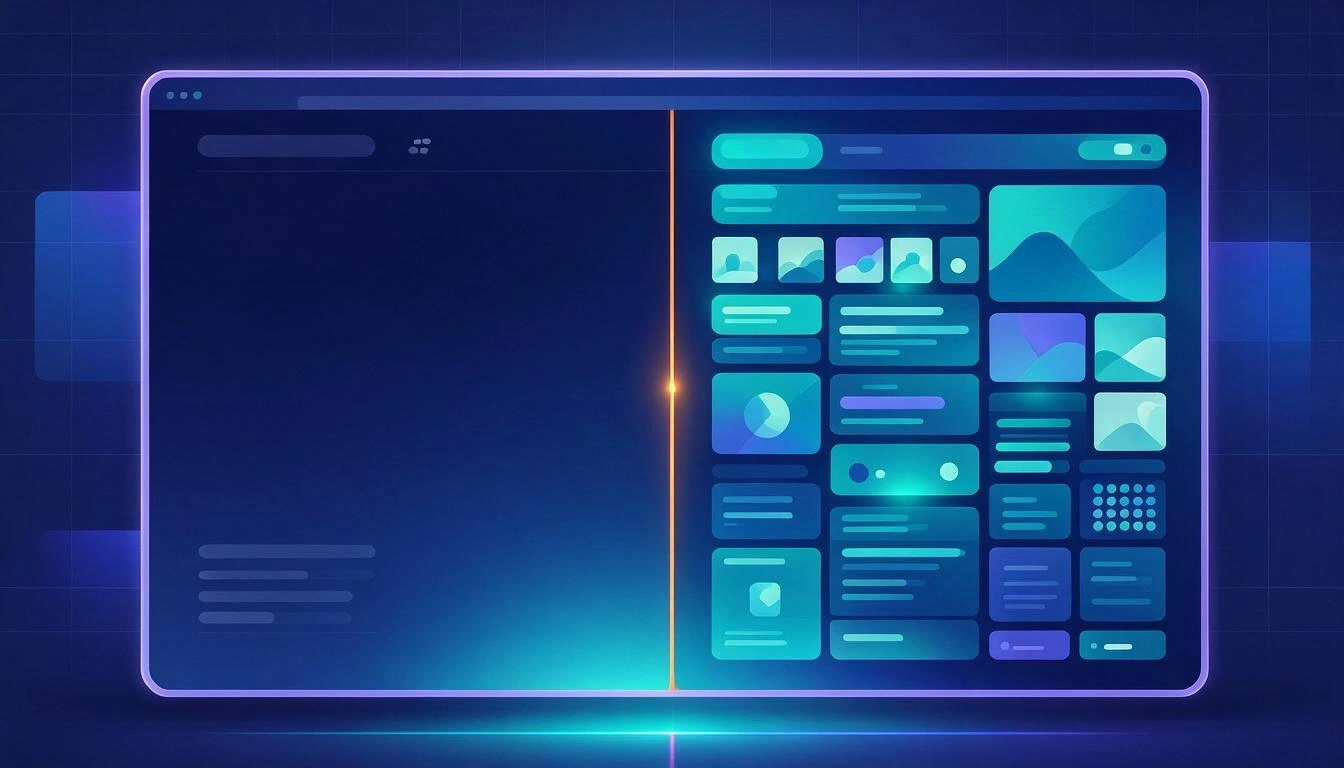
La deuxième cause la plus fréquente d'invisibilité est le rendu côté client. Un bot qui n'exécute pas JavaScript voit le HTML renvoyé par le serveur; si votre site est une SPA (React, Vue, Angular) sans rendu côté serveur, ce HTML peut être un <div id="root"> vide et trois balises script. Googlebot rend; tous les robots IA ne se comportent pas de la même manière ni ne documentent qu'ils le font.
Le test se fait en deux étapes et ne nécessite pas d'outils payants :
# 1) Ce qu'un bot sans JavaScript voit : compte les mots du HTML brut
curl -sL -A "OAI-SearchBot/1.4" https://votredomaine.com/une-page \
  | sed -e 's/<[^>]*>/ /g' | tr -s ' \n' ' ' | wc -w

# 2) Vous renvoie-t-il 403 ou 200 lorsque vous changez l'agent utilisateur ?
curl -s -o /dev/null -w "%{http_code}\n" -A "PerplexityBot" https://votredomaine.com/
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0" https://votredomaine.com/
Si le premier chiffre est à deux chiffres et que la page réelle a mille mots, là est votre problème. Si la deuxième commande renvoie 403 avec l'agent utilisateur du bot et 200 avec celui du navigateur, votre CDN ou votre WAF bloque ce que vous n'avez jamais configuré : c'est l'échec silencieux le plus courant, car il n'apparaît dans aucun outil SEO.
Que faire si le HTML brut est vide, par ordre de coût :
- Rendu côté serveur ou statique pour les pages que vous souhaitez qu'on vous cite (Next.js, Nuxt, Astro, ou prerender à la périphérie). C'est la vraie solution.
- Prerender sélectif du contenu critique : le premier bloc de réponse, le H1, les données de contact et le JSON-LD dans le HTML initial, même si le reste s'hydrate ensuite.
- Ne servez jamais aux bots une version différente du contenu que voit l'utilisateur : c'est du cloaking et c'est une infraction aux directives de spam de Google.
Le mur de cookies et le 403 sont un diagnostic, pas un détail
Si votre page n'affiche du contenu qu'après avoir accepté une bannière de consentement, ce que le bot voit, c'est la bannière. Les robots ne cliquent pas sur "Accepter" : ils capturent l'état initial. Il en va de même pour les murs d'enregistrement, les interstitials de géolocalisation et les protections anti-bot agressives.
Cela ne signifie pas retirer le consentement —vous avez des obligations RGPD à respecter—, mais que le contenu indexable doit être dans le HTML derrière la bannière, pas conditionné à son acceptation. Une bannière qui bloque le <body> avec un overlay est compatible avec l'AEO; une bannière qui empêche le serveur d'envoyer le contenu, non.
llms.txt: que dit Google et que peux-tu vraiment attendre
llms.txt est une proposition communautaire de fichier à la racine du domaine avec un index en Markdown du site pour la consommation de modèles. Ce n'est pas une norme (cela ne vient pas de l'IETF ni du W3C) et Google a dit explicitement qu'il ne l'utilise pas : son guide des fonctionnalités d'IA affirme que "tu n'as pas besoin de créer de nouveaux fichiers lisibles par machine, de fichiers texte pour l'IA ni de balisage" pour apparaître dans les AI Overviews ou AI Mode, et John Mueller a nié en janvier 2026 que la présence du fichier dans certains domaines de Google constituait un soutien (Search Engine Roundtable, 20-janv-2026).
Conclusion pratique : le mettre coûte dix minutes et ne casse rien, mais ce n'est pas un levier de visibilité et cela ne remplace certainement pas ce qui précède. Si tu décides de l'avoir, qu'il soit correct (un véritable index de tes URLs importantes, maintenu), et ne le considère pas comme un travail accompli en AEO.
Il n'y a pas non plus de "schéma magique" pour apparaître dans les réponses d'IA
Google est explicite : il n'y a pas de données structurées spéciales à ajouter pour apparaître dans les AI Overviews ou AI Mode (Google, fonctionnalités IA). Le JSON-LD vaut encore la peine pour une autre raison : il désambigue. Un Organization avec sameAs, un Article avec author et datePublished, un FAQPage avec les questions telles qu'elles sont écrites par les gens, un Product avec offers et aggregateRating disent à n'importe quel système quelle entité tu es et ce que tu affirmes, sans qu'il ait besoin de le déduire du balisage.
Alors traite le balisage comme une hygiène des données, pas comme un truc de visibilité :
| Type de page | JSON-LD qui apporte vraiment | Champs qui font la différence |
|---|---|---|
| Accueil d'entreprise | Organization | name, url, logo, sameAs, contactPoint |
| Article de blog | Article / BlogPosting | headline, author, datePublished, dateModified |
| Fiche de produit | Product | offers.price, availability, brand, gtin |
| Page de service local | LocalBusiness | address, openingHours, areaServed |
| Questions fréquentes | FAQPage | question littérale + réponse complète |
Comment écrire un contenu citant : réponse d'abord et passages autonomes
Un moteur de réponse ne cite pas des pages : il cite des passages. Le modèle qui fonctionne est de mettre la réponse complète dans les deux ou trois premières phrases de chaque section, de manière à ce que ce fragment soit compris isolément, sans dépendre du paragraphe précédent ni d'un "comme nous l'avons dit auparavant". Ensuite, en dessous, le développement, les données et les nuances.
Règles concrètes, pas génériques :
- Un en-tête = une question ou une affirmation vérifiable. "Prix" ne peut pas être cité ; "Combien coûte un audit AEO en Espagne" peut.
- Autonomie. Chaque section doit résoudre sa propre question sans pronoms pointant à l'extérieur. Si en copiant le premier paragraphe et en le lisant seul, cela ne s'entend pas, réécris-le.
- Données avec source et date. Les modèles et les réviseurs humains rejettent les chiffres orphelins. "68 %" sans qui le mesure et quand ne vaut rien.
- Tableaux pour tout ce qui est comparable. Ce sont le format qui survit le mieux à l'extraction.
- Entités explicites. Nomme ta marque, ta ville, ton produit et tes concurrents avec le nom complet au moins une fois ; ne présume pas que cela se déduit du contexte.
- Dates visibles.
dateModifiedréel et une date dans le texte. La fraîcheur pèse.
Combien de trafic peux-tu attendre ? Peu, mais différent
Les chiffres disponibles pointent vers la même chose : les moteurs de réponse réduisent le clic et renvoient beaucoup moins de trafic par page explorée qu'un moteur de recherche classique. Le Pew Research Center a mesuré le comportement réel de 900 adultes américains sur 68 879 recherches Google (données de mars 2025) : lorsque résumés d'IA apparaissaient, les utilisateurs cliquaient sur un résultat dans 8 % des visites, contre 15 % lorsqu'il n'apparaissait pas ; les liens dans le résumé ont été cliqués dans 1 % des visites (Pew Research Center, 22-juil-2025).
| Donnée | Chiffre | Source et date |
|---|---|---|
| Clic sur un résultat avec résumé d'IA | 8 % des visites | Pew Research Center, 22-juil-2025 (données de mars 2025) |
| Clic sur un résultat sans résumé d'IA | 15 % des visites | Pew Research Center, 22-juil-2025 |
| Clic sur les liens du résumé lui-même | 1 % des visites | Pew Research Center, 22-juil-2025 |
| Session terminée après la page de résultats | 26 % avec résumé vs. 16 % sans lui | Pew Research Center, 22-juil-2025 |
| Difficulté d'obtenir une visite vs. Google classique | ×750 avec OpenAI, ×30 000 avec Anthropic | Cloudflare, 1-juil-2025 |
| Chute prévue du volume de recherche traditionnel pour 2026 | −25 % | Gartner, communiqué de presse 19-fév-2024 |
Deux lectures honnêtes de ce tableau. La première : si ton plan d'affaires dépend d'un flot de clics depuis ChatGPT, les chiffres ne le soutiennent pas aujourd'hui. La seconde : la citation elle-même a de la valeur de marque et de préférence — apparaître comme la source recommandée lorsque quelqu'un demande "quel cabinet me convient à Valence" pèse même s'il n'y a pas de clic — et le coût de ne pas être là est asymétrique, car tes concurrents y sont. La prévision de Gartner, d'ailleurs, a été publiée en février 2024 et il convient de la traiter comme ce qu'elle est : une prévision, pas un fait mesuré.
Comment auditer votre site pour les moteurs d'IA en 7 étapes
Voici la séquence complète, dans l'ordre où elle compte. Les étapes 1 à 3 sont éliminatoires : si elles échouent, le reste est sans importance.
robots.txt, agent par agent. Ouvrezhttps://votredomaine.com/robots.txtet évaluez l'URL concrète contre chaque token du tableau précédent, en respectant la priorité (le groupe spécifique l'emporte sur*; entreAllowetDisallow, la règle de motif la plus longue l'emporte).- Réponse réelle avec user-agent de bot. Vérifiez le code d'état avec
curl -A. Recherchez 403, 429, redirections étranges et défis JavaScript de votre WAF. - Directives de découpage. Vérifiez
X-Robots-Tagdans les en-têtes et<meta name="robots">: unnoindex,nosnippetoumax-snippet:0hérité d'une migration vous auto-limite sans que personne ne s'en rende compte. - Brut contre rendu. Comptez les mots du HTML sans JavaScript et comparez-les avec la page rendue. Notez quels blocs manquent.
- Structure extractible. Un seul H1, hiérarchie des en-têtes sans sauts, chaque section répondant à sa question dans le premier paragraphe, tables au lieu de paragraphes comparatifs.
- Identité et données structurées. JSON-LD valide, dates réelles, auteur identifiable,
OrganizationavecsameAs. - Mesure et répétition. Séparez le trafic d'IA dans l'analyse (les referrers des assistants sont identifiables) et répétez l'audit après chaque déploiement pour voir l'avant et l'après.
Ce que l'on NE peut pas savoir avec certitude (et méfiez-vous de ceux qui vous le promettent)
Personne ne peut vous garantir une citation dans ChatGPT, ni mesurer "votre position" dans un moteur de réponse comme on mesure une position sur Google. Les réponses génératives ne sont pas déterministes : la même question, deux fois, peut citer des sources différentes, et les fournisseurs ne publient ni un index consultable ni une API de classement. Tout "3ème place dans ChatGPT" est, au mieux, un échantillonnage.
Ce qui peut être mesuré avec rigueur :
- Accessibilité : si un bot particulier peut ou non télécharger une URL particulière. C'est binaire et vérifiable.
- Extractibilité : combien de votre contenu existe sans JavaScript et comment il est structuré.
- Apparition échantillonnée : poser la même question N fois et rapporter dans quel pourcentage de réponses votre marque apparaît, toujours avec la date et le nombre de répétitions à côté. C'est un indicateur, pas un classement.
Si un outil ou une agence vous promet "être dans ChatGPT" avec un nombre garanti, le problème n'est pas l'outil : c'est la promesse.
Aeopro : les mêmes vérifications, sur une URL et dans un rapport
Faire manuellement les 7 étapes pour une page prend quelques heures ; pour un site entier, des jours. Aeopro, l'application d'audit AEO de AIsToHire, automatise exactement cette séquence : vous collez une URL et vous obtenez 99 vérifications déterministes avec deux scores —AEO, qui pèse 70 % du résultat global, et SEO classique, 30 %— et les poids de chaque catégorie publiés dans l'application pour que vous puissiez suivre d'où provient chaque point.
Ce qui correspond à ce que vous venez de lire :
| Ce qu'il faut vérifier | Que fait Aeopro |
|---|---|
robots.txt agent par agent | Croise votre robots.txt avec 11 bots d'IA, séparant ceux d'entraînement de ceux de réponse, et montre la ligne exacte qui cause chaque blocage |
| Réponse réelle à un bot | Sondage de votre site avec user-agent de bot pour attraper 403, murs de WAF et directives noindex/nosnippet |
| Brut contre rendu | Télécharge la page deux fois (HTML brut et DOM rendu), vous dit quel pourcentage du contenu est disponible sans hydratation et liste les blocs manquants |
| Corriger ce qui échoue | 44 des 99 règles apportent un patch générable : le JSON-LD complet, le TL;DR et la FAQ rédigés pour votre contenu, la section réécrite au format réponse-première, le llms.txt et les metas. Le patch de robots.txt se compose sans IA, avec un interrupteur par bot |
| Apparition dans les réponses | Test de visibilité : trois questions éditables de votre secteur, lancées trois fois chacune, avec le pourcentage d'apparition de votre marque, le ton et quels concurrents apparaissent à votre place — toujours présenté comme un échantillonnage avec sa date, jamais comme un oui ou un non absolu |
| Répéter après le déploiement | Réanalyse avec l'avant et l'après, et un registre versionné du catalogue de règles pour que le score soit explicable des mois après |
Le rapport déterministe et la réanalyse ne consomment pas de tokens : vous pouvez auditer et ré-auditer. Ils ne consomment que les actions dans lesquelles l'IA écrit, et toujours une à une, lorsque vous les activez. Vous pouvez le voir sur la page d'Aeopro, l'outil d'audit AEO et de visibilité en IA d'AIsToHire.
Questions fréquentes
Pourquoi ChatGPT ne cite-t-il pas mon site web ?
Par ordre de fréquence : parce que votre robots.txt bloque OAI-SearchBot (souvent sans le vouloir, en bloquant "l'IA" en bloc), parce que votre serveur ou votre WAF renvoie 403 aux user-agents de bot, parce que votre contenu n'existe qu'après l'exécution de JavaScript, parce qu'il n'y a pas de passage qui réponde à la question de manière autonome, ou parce que simplement d'autres sources sont plus citées pour ce sujet. Les trois premières causes sont techniques et se vérifient en quelques minutes.
Si je bloque GPTBot, vais-je cesser d'apparaître dans ChatGPT ?
Pas nécessairement. GPTBot est le robot d'entraînement ; celui qui indexe pour la recherche de ChatGPT est OAI-SearchBot. Ce sont des tokens indépendants dans robots.txt, donc vous pouvez refuser de nourrir l'entraînement tout en restant citables. Ce qui vous sort des réponses, c'est de bloquer OAI-SearchBot (documentation d'OpenAI).
Ai-je besoin d'un fichier llms.txt ?
Ce n'est pas indispensable et, à ce jour, il n'y a pas de preuve publique que les grands fournisseurs l'utilisent en production. Google affirme qu'il n'est pas nécessaire d'avoir des fichiers texte pour l'IA ni de balisage spécial pour apparaître dans ses fonctions d'IA, et en janvier 2026, John Mueller a nié que Google le soutienne. L'ajouter ne nuit pas ; croire qu'avec cela vous avez déjà fait AEO, oui.
Comment savoir si mon site web s'affiche sans JavaScript ?
Téléchargez le HTML brut avec curl -sL https://tudominio.com | sed -e 's/<[^>]*>/ /g' | wc -w et comparez le compte de mots avec ce que vous voyez dans le navigateur. Si la différence est d'un ordre de grandeur, votre contenu dépend du rendu côté client. Dans Aeopro, cette comparaison est faite, avec les deux textes côte à côte et la liste des blocs manquants.
L'AEO remplace-t-il le SEO ?
Non. Le SEO reste la base : si vous n'êtes pas indexé et que vous n'êtes ni rapide ni utile, il n'y a pas d'AEO possible. Google le dit avec ses mots : les bonnes pratiques de SEO restent valables pour ses fonctions d'IA et il n'y a pas d'exigences supplémentaires. L'AEO ajoute une couche : accessibilité à des bots qui ne sont pas Googlebot, contenu extractible sans JavaScript et passages autonomes.
Quel trafic vais-je gagner si je suis cité dans ChatGPT ?
Moins que ce que vous aimeriez, et il convient de l'accepter dès le début. Pew a mesuré que les liens dans un résumé d'IA de Google sont cliqués dans 1 % des visites, et Cloudflare a estimé en juillet 2025 que recevoir une visite via OpenAI est environ 750 fois plus difficile qu'avec le moteur de recherche classique. La valeur de la citation réside davantage dans la marque et la préférence que dans le clic direct.
Peut-on garantir d'apparaître dans les réponses de l'IA ?
Non, et aucun outil honnête ne le garantira. Les réponses génératives varient entre les exécutions et les fournisseurs n'exposent pas un classement consultable. Ce qui peut être garanti, c'est d'éliminer les blocages techniques qui vous excluent aujourd'hui et de mesurer l'apparition par échantillonnage, avec date et nombre de répétitions.
À quelle fréquence est-il conseillé de répéter l'audit ?
Après chaque déploiement touchant les modèles, robots.txt, CDN ou WAF, et comme révision de fond tous les un ou deux mois : les noms des bots et les directives changent plusieurs fois par an. En 2025 et 2026, de nouveaux tokens ont été ajoutés — OAI-SearchBot, Claude-SearchBot, OAI-AdsBot — qui n'existaient pas lorsque beaucoup de gens ont écrit leur robots.txt.
Conclusion : d'abord éliminez les blocages, ensuite écrivez pour être cité
L'AEO, aujourd'hui, est 20 % écriture et 80 % ne pas gêner. Avant de réécrire un seul paragraphe, vérifiez que les bots qui citent peuvent télécharger votre page, que votre serveur ne leur répond pas 403 et que votre contenu existe sans JavaScript ; ces trois choses expliquent la plupart des invisibilités que l'on voit dans un audit. Ensuite viennent les passages autonomes, les tableaux, le JSON-LD propre et les dates réelles.
Si vous voulez le tableau complet d'une URL sans y consacrer l'après-midi, Aeopro — l'outil d'audit AEO de AIsToHire — effectue les 99 vérifications, vous montre le fragment exact de votre HTML qui provoque chaque problème et, dans 44 d'entre elles, vous génère le patch prêt à coller : auditer un site web avec Aeopro.
Collez l'URL de votre site dans Aeopro et vérifiez en moins d'une minute si les bots qui citent des sources peuvent vous lire, ce qui les en empêche et quelle est la solution exacte.
Collez l'URL de votre site dans Aeopro et vérifiez en moins d'une minute si les bots qui citent des sources peuvent vous lire, ce qui les en empêche et quelle est la solution exacte.Continuer la lecture
Voir tous les articles →
93 % des recherches en mode IA ne génèrent aucun clic : ce que cela signifie pour votre site en 2026

Pourquoi votre assurance automobile a augmenté en 2026 : prime moyenne de 1 412 € et record historique

Discuter par WhatsApp ou en personne : que dit la science sur les conflits de couple par messages
