 Aeopro
Varför ChatGPT inte citerar din webbplats: AEO-granskningen som nästan ingen gör rätt
Teamet på AeoproSkriven med AI-stöd18 min läsningSammanfattning
- Det finns tre familjer av AI-botar, inte en: de för träning (GPTBot, ClaudeBot, Google-Extended), de för sökning och citering (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Bingbot) och de som utlöses av användaren (ChatGPT-User, Claude-User, Perplexity-User). Att blockera de första är ett legitimt beslut; att blockera de andra är att försvinna ur svaren.
- Att blockera
GPTBotblockerar inteOAI-SearchBot, och att blockeraGoogle-Extendedtar inte bort dig från AI Overviews: Google dokumenterar att den token inte påverkar inkluderingen i Google Search (Google Search Central). - Om ditt innehåll bara visas efter att JavaScript har körts kommer vissa botar att se en nästan tom sida. Diagnosen ställs genom att jämföra rå HTML med renderad DOM.
llms.txtär inte lösningen: Google säger att du inte behöver skapa textfiler för AI eller något särskilt schema för att synas i AI Overviews eller AI Mode (Google, AI features), och John Mueller uppgav i januari 2026 att Google inte stöderllms.txt(Search Engine Roundtable, 20 jan 2026).- Trafiken som AI-motorerna ger tillbaka är liten och dyr att få: Cloudflare angav i juli 2025 att det är "750 gånger svårare" att få ett besök via OpenAI än via Google som det var förr, och "30 000 gånger" via Anthropic (Cloudflare, 1 jul 2025).
Om du har hamnat här på jakt efter varför ChatGPT inte citerar din webbplats är svaret sällan "mitt innehåll är inte bra". I de flesta granskade fallen är problemet tekniskt och tråkigt: en rad i robots.txt, en WAF som returnerar 403 till alla ovanliga user-agents, eller en webbplats byggd som en ensidig applikation vars text inte finns förrän webbläsaren kör JavaScript. Den här artikeln förklarar hur du kontrollerar varje sak för hand och med vilka källor, och i slutet får du se hur Aeopro, AEO-granskningsverktyget från AIsToHire, automatiserar samma kontroller på en URL.
Vad är AEO och hur skiljer det sig från SEO?
AEO (Answer Engine Optimization) är arbetet med att förbereda en webbplats så att svarsmotorerna –ChatGPT, Claude, Perplexity, Gemini, Copilot– kan läsa, förstå och citera den när de genererar ett svar. Klassisk SEO optimerar för en lista med tio blå länkar; AEO optimerar för att vara en av de tre eller fyra källor som modellen sammanfattar och länkar till. De har mycket gemensamt (indexerbarhet, prestanda, användbart innehåll), men har egna fel som traditionell SEO aldrig har mätt.
Skillnaden i praktiken: en webbplats som är oklanderlig för Google kan vara osynlig för en AI-motor om den blockerar boten som citerar, om den svarar 403 till den boten eller om texten bara renderas på klientsidan. Och tvärtom: Google uppger att det inte finns några ytterligare krav för att synas i AI Overviews eller AI Mode utöver god SEO-praxis (Google Search Central, AI features). Det vill säga: i Googles ekosystem handlar AEO framför allt om att inte förstöra något; i ekosystemet kring OpenAI/Anthropic/Perplexity finns det specifika direktiv som du faktiskt måste hantera.
| Klassisk SEO | AEO / svarsmotorer | |
|---|---|---|
| Mål | Position i SERP | Att vara en citerad källa i svaret |
| Bot som räknas | Googlebot, Bingbot | OAI-SearchBot, Claude-SearchBot, PerplexityBot, Bingbot, Googlebot |
| Innehållsenhet | Sidan | Det fristående stycket |
| Kritisk teknisk signal | Indexerbarhet | Åtkomst för boten + innehåll i HTML utan JS |
| Mått | Position, klick, CTR | Andel förekomster i svar, citeringar |
| Kontroll över utdrag | — | nosnippet, max-snippet, data-nosnippet |
AI-botarna delas in i tre familjer och det kostar att blanda ihop dem
Det finns tre typer av crawlers och var och en styrs med sin egen token i robots.txt: träning, sökning/citering och hämtning som utlöses av användaren. Att blockera träningsboten är ett fullt rimligt affärsbeslut –du vill inte mata modeller gratis–; att blockera sökboten innebär att assistenten inte kan läsa dig när någon frågar om det du säljer. Nästan alla "anti-AI"-robots.txt som kopieras från forum blockerar båda sakerna på en gång utan att det är meningen.
Det här är tabellen som är bra att ha framför sig, med varje leverantörs officiella dokumentation:
| User-agent | Leverantör | Vad den gör | Förlorar du citeringar om du blockerar den? |
|---|---|---|---|
GPTBot | OpenAI | Träning av modeller | Nej |
OAI-SearchBot | OpenAI | Indexering för ChatGPT:s sökning | Ja |
ChatGPT-User | OpenAI | Besök som utlöses av en användare | Ja (OpenAI varnar för att reglerna i robots.txt kanske inte gäller) |
OAI-AdsBot | OpenAI | Kontroll av målsidor för annonser i ChatGPT | Nej |
ClaudeBot | Anthropic | Träning | Nej |
Claude-SearchBot | Anthropic | Indexering för sökresultat | Ja |
Claude-User | Anthropic | Besök när en användare frågar Claude | Ja |
PerplexityBot | Perplexity | Indexera och länka i resultat | Ja |
Perplexity-User | Perplexity | Besök som utlöses av användaren (ignorerar robots.txt, enligt deras dokumentation) | Ja |
Google-Extended | Träning och grounding för Gemini | Påverkar inte Google Search | |
Bingbot | Microsoft | Bings index (och produkter som använder det) | Ja |
Källor: OpenAI, dokumentation om botar; Anthropic, webbcrawling; Perplexity, botar; Google, vanliga crawlers. Hämtade den 26 oktober 2026.
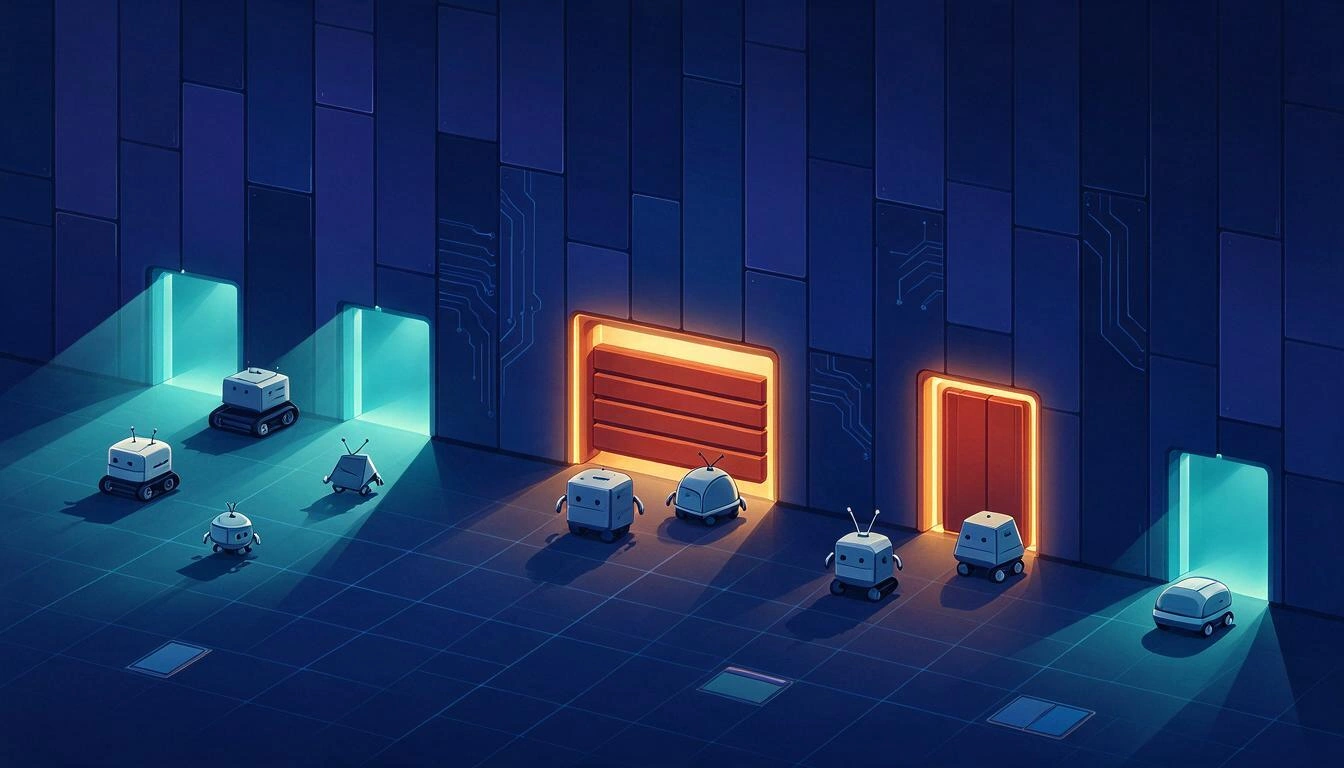
Tre nyanser som nästan ingen tillämpar rätt:
- Token är oberoende av varandra.
DisallowförGPTBotpåverkar inteOAI-SearchBot, och inte hellerClaudeBotpåverkarClaude-SearchBot. Varje agent behöver sin egen grupp. - Användarens hämtare följer andra regler. OpenAI dokumenterar att reglerna i
robots.txtkanske inte gällerChatGPT-User, eftersom besöket initieras av en person; Perplexity säger rakt ut attPerplexity-Useroftast ignorerar dem. Att enbart lita pårobots.txtför att "stänga dörren" fungerar inte enhetligt. Google-Extendedär inte strömbrytaren för AI Overviews. Google dokumenterar att den token styr träning och grounding för Gemini, och att den "inte påverkar webbplatsens inkludering i Google Search och inte används som rankingsignal". För att begränsa vad Google visar i sina AI-funktioner är kontrollernanosnippet,data-nosnippet,max-snippetochnoindex.
Om din text bara finns efter att JavaScript har körts kan din sida vara tom för en AI
Den näst vanligaste orsaken till osynlighet är rendering på klientsidan. En bot som inte kör JavaScript ser den HTML som servern returnerar; om din webbplats är en SPA (React, Vue, Angular) utan rendering på servern kan den HTML:en vara en tom <div id="root"> och tre script-taggar. Googlebot renderar; inte alla AI-crawlers beter sig likadant eller dokumenterar att de gör det.
Testet görs i två steg och kräver inga betalverktyg:
# 1) Vad en bot ser utan JavaScript: räkna orden i den råa HTML:en
curl -sL -A "OAI-SearchBot/1.4" https://tudominio.com/una-pagina \
  | sed -e 's/<[^>]*>/ /g' | tr -s ' \n' ' ' | wc -w

# 2) Får du 403 eller 200 när du byter user-agent?
curl -s -o /dev/null -w "%{http_code}\n" -A "PerplexityBot" https://tudominio.com/
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0" https://tudominio.com/
Om den första siffran har två siffror och den riktiga sidan har tusen ord är där ditt problem. Om det andra kommandot returnerar 403 med en bots user-agent och 200 med en webbläsares, så gör din CDN eller din WAF den blockering som du aldrig har konfigurerat: det är det vanligaste tysta felet, eftersom det inte syns i något SEO-verktyg.
Vad du gör om den råa HTML:en är tom, i ordning efter kostnad:
- Rendering på servern eller statisk för de sidor du vill bli citerad på (Next.js, Nuxt, Astro, eller prerender på edge). Det är den verkliga lösningen.
- Selektiv prerender av det kritiska innehållet: det första svarsblocket, H1, kontaktuppgifterna och JSON-LD i den ursprungliga HTML:en, även om resten hydreras senare.
- Servera aldrig botarna en annan version av innehållet än den som användaren ser: det är cloaking och ett brott mot Googles spamriktlinjer.
Cookiemuren och 403 är diagnos, inte en detalj
Om din sida bara visar innehåll efter att ett samtyckesbanner har godkänts är det banneret som boten ser. Crawlers klickar inte på "Acceptera": de fångar upp utgångsläget. Detsamma gäller registreringsmurar, interstitials för geolokalisering och aggressiva anti-botskydd.
Det betyder inte att du ska ta bort samtycket –du har GDPR-skyldigheter att uppfylla–, utan att det indexerbara innehållet ska ligga i HTML:en bakom banneret, inte vara villkorat av att det godkänns. Ett banner som blockerar <body> med en overlay går att förena med AEO; ett banner som hindrar servern från att skicka innehållet gör det inte.
llms.txt: vad Google säger och vad du verkligen kan förvänta dig
llms.txt är ett förslag från communityn om en fil i domänens rot med ett index över webbplatsen i Markdown, avsett för modeller. Det är inte en standard (den kommer varken från IETF eller W3C) och Google har uttryckligen sagt att de inte använder den: deras guide om AI-funktioner säger att "du behöver inte skapa nya maskinläsbara filer, textfiler för AI eller någon markup" för att synas i AI Overviews eller AI Mode, och John Mueller dementerade i januari 2026 att förekomsten av filen på vissa av Googles domäner skulle vara ett stöd (Search Engine Roundtable, 20 jan 2026).
Den praktiska slutsatsen: att lägga till den tar tio minuter och förstör ingenting, men den är inget verktyg för synlighet och ersätter absolut inte det som nämnts ovan. Om du bestämmer dig för att ha den, se till att den är korrekt (ett verkligt index över dina viktiga URL:er, som hålls uppdaterat) och räkna den inte som utfört AEO-arbete.
Det finns inte heller något "magiskt schema" för att synas i AI-svar
Google är tydligt: det finns ingen särskild strukturerad data som måste läggas till för att synas i AI Overviews eller AI Mode (Google, AI features). JSON-LD är fortfarande värt besväret av ett annat skäl: det skapar entydighet. En Organization med sameAs, en Article med author och datePublished, en FAQPage med frågorna precis som folk skriver dem, en Product med offers och aggregateRating talar om för alla system vilken entitet du är och vad du påstår, utan att de behöver sluta sig till det utifrån layouten.
Behandla därför markup som datahygien, inte som ett synlighetstrick:
| Typ av sida | JSON-LD som faktiskt bidrar | Fält som gör skillnad |
|---|---|---|
| Företagets startsida | Organization | name, url, logo, sameAs, contactPoint |
| Blogginlägg | Article / BlogPosting | headline, author, datePublished, dateModified |
| Produktsida | Product | offers.price, availability, brand, gtin |
| Sida för lokal tjänst | LocalBusiness | address, openingHours, areaServed |
| Vanliga frågor | FAQPage | ordagrann fråga + fullständigt svar |
Så skriver du citerbart innehåll: svaret först och fristående stycken
En svarsmotor citerar inte sidor: den citerar stycken. Mönstret som fungerar är att lägga det fullständiga svaret i de två eller tre första meningarna i varje avsnitt, så att utdraget går att förstå isolerat, utan att bero på stycket före eller på ett "som vi sa tidigare". Därunder kommer utvecklingen, data och nyanser.
Konkreta regler, inte allmänna:
- En rubrik = en fråga eller ett verifierbart påstående. "Priser" går inte att citera; "Vad kostar en AEO-granskning i Spanien" går.
- Fristående. Varje avsnitt ska lösa sin egen fråga utan pronomen som pekar utanför. Om det första stycket inte går att förstå när du kopierar det och läser det för sig, skriv om det.
- Data med källa och datum. Modeller och mänskliga granskare förkastar föräldralösa siffror. "68 %" utan att veta vem som mäter det och när är värdelöst.
- Tabeller för allt som går att jämföra. De är det format som klarar extrahering bäst.
- Uttryckliga entiteter. Nämn ditt varumärke, din stad, din produkt och dina konkurrenter med fullständigt namn minst en gång; utgå inte från att det framgår av sammanhanget.
- Synliga datum. Ett verkligt
dateModifiedoch ett datum i texten. Aktualitet väger tungt.
Hur mycket trafik kan du förvänta dig? Lite, men annorlunda
De tillgängliga siffrorna pekar åt samma håll: svarsmotorerna minskar klicken och ger mycket mindre trafik per crawlad sida än en klassisk sökmotor. Pew Research Center mätte det faktiska beteendet hos 900 vuxna amerikaner över 68 879 Google-sökningar (data från mars 2025): när en AI-sammanfattning visades klickade användarna på ett resultat vid 8 % av besöken, jämfört med 15 % när den inte visades; länkarna inne i sammanfattningen klickades vid 1 % av besöken (Pew Research Center, 22 jul 2025).
| Uppgift | Siffra | Källa och datum |
|---|---|---|
| Klick på ett resultat med AI-sammanfattning | 8 % av besöken | Pew Research Center, 22 jul 2025 (data från mars 2025) |
| Klick på ett resultat utan AI-sammanfattning | 15 % av besöken | Pew Research Center, 22 jul 2025 |
| Klick på länkarna i själva sammanfattningen | 1 % av besöken | Pew Research Center, 22 jul 2025 |
| Session som avslutas efter resultatsidan | 26 % med sammanfattning mot 16 % utan | Pew Research Center, 22 jul 2025 |
| Svårighet att få ett besök jämfört med klassiska Google | ×750 med OpenAI, ×30 000 med Anthropic | Cloudflare, 1 jul 2025 |
| Förväntad minskning av volymen traditionella sökningar till 2026 | −25 % | Gartner, pressmeddelande 19 feb 2024 |
Två ärliga tolkningar av den tabellen. Den första: om din affärsplan beror på en ström av klick från ChatGPT bär siffrorna inte upp den i dag. Den andra: själva citeringen har värde för varumärket och preferensen –att synas som den rekommenderade källan när någon frågar "vilken redovisningsbyrå passar mig i Valencia" väger tungt även utan klick–, och kostnaden för att inte synas är asymmetrisk, eftersom dina konkurrenter gör det. Gartners prognos publicerades för övrigt i februari 2024 och bör behandlas som det den är: en prognos, inte ett uppmätt faktum.
Så granskar du din webbplats för AI-motorer i 7 steg
Det här är hela sekvensen, i den ordning som spelar roll. Steg 1 till 3 är utslagsgivande: om de misslyckas är resten irrelevant.
robots.txt, agent för agent. Öppnahttps://tudominio.com/robots.txtoch utvärdera den aktuella URL:en mot varje token i tabellen ovan, med hänsyn till företrädesordningen (den specifika gruppen vinner över*; mellanAllowochDisallowvinner regeln med det längsta mönstret).- Verkligt svar med en bots user-agent. Kontrollera statuskoden med
curl -A. Leta efter 403, 429, konstiga omdirigeringar och JavaScript-utmaningar från din WAF. - Direktiv för begränsning av utdrag. Granska
X-Robots-Tagi headers och<meta name="robots">: ettnoindex,nosnippetellermax-snippet:0som har ärvts från en migrering begränsar dig själv utan att någon märker det. - Rå mot renderad. Räkna orden i HTML:en utan JavaScript och jämför med den renderade sidan. Notera vilka block som saknas.
- Extraherbar struktur. En enda H1, rubrikhierarki utan hopp, varje avsnitt besvarar sin fråga i det första stycket, tabeller i stället för jämförande stycken.
- Identitet och strukturerad data. Giltig JSON-LD, verkliga datum, identifierbar författare,
OrganizationmedsameAs. - Mätning och upprepning. Separera AI-trafiken i din analys (assistenternas referrers går att identifiera) och upprepa granskningen efter varje driftsättning för att se före och efter.
Vad som INTE går att veta med säkerhet (och var skeptisk mot den som lovar det)
Ingen kan garantera dig en citering i ChatGPT, och ingen kan mäta "din position" i en svarsmotor på det sätt som man mäter en position i Google. Generativa svar är inte deterministiska: samma fråga, två gånger, kan citera olika källor, och leverantörerna publicerar varken något sökbart index eller något rankings-API. Varje "plats 3 i ChatGPT" är i bästa fall ett stickprov.
Det som går att mäta med stringens:
- Åtkomst: om en specifik bot kan eller inte kan ladda ned en specifik URL. Det är binärt och går att kontrollera.
- Extraherbarhet: hur mycket av ditt innehåll som finns utan JavaScript och hur det är strukturerat.
- Stickprovsbaserad förekomst: att ställa samma fråga N gånger och redovisa i hur stor andel av svaren ditt varumärke dyker upp, alltid med datum och antal upprepningar bredvid. Det är en indikator, inte en ranking.
Om ett verktyg eller en byrå lovar dig att "synas i ChatGPT" med en garanterad siffra är problemet inte verktyget: det är löftet.
Aeopro: samma kontroller, på en URL och i en rapport
Att göra de 7 stegen för hand för en sida tar ett par timmar; för en hel webbplats, dagar. Aeopro, AEO-granskningsappen från AIsToHire, automatiserar precis den sekvensen: du klistrar in en URL och får tillbaka 99 deterministiska kontroller med två poäng –AEO, som väger 70 % av helhetsresultatet, och klassisk SEO, 30 %– och vikterna för varje kategori publicerade inne i appen så att du kan följa var varje poäng kommer ifrån.
Det som motsvarar det du just har läst:
| Det som ska kontrolleras | Vad Aeopro gör |
|---|---|
robots.txt agent för agent | Korsar din robots.txt med 11 AI-botar, skiljer träningsbotarna från svarsbotarna och visar exakt vilken rad som orsakar varje blockering |
| Verkligt svar till en bot | Sonderar din webbplats med en bots user-agent för att hitta 403, WAF-murar och direktiven noindex/nosnippet |
| Rå mot renderad | Hämtar sidan två gånger (rå HTML och renderad DOM), talar om hur stor andel av innehållet som är tillgänglig utan hydrering och listar de block som saknas |
| Åtgärda det som inte fungerar | 44 av de 99 reglerna har en patch som går att generera: den kompletta JSON-LD:en, TL;DR och FAQ skrivna för ditt innehåll, avsnittet omskrivet i svaret-först-format, llms.txt och metataggarna. Patchen för robots.txt skapas utan AI, med en omkopplare för varje bot |
| Förekomst i svaren | Synlighetstest: tre redigerbara frågor i din bransch, ställda tre gånger vardera, med andelen förekomster för ditt varumärke, tonen och vilka konkurrenter som dyker upp i ditt ställe — alltid presenterat som ett stickprov med sitt datum, aldrig som ett absolut ja eller nej |
| Upprepa efter driftsättning | Ny analys med före och efter, och ett versionshanterat register över regelkatalogen så att poängen går att förklara månader senare |
Den deterministiska rapporten och den nya analysen förbrukar inga tokens: du kan granska och granska igen. Det är bara de åtgärder där AI:n skriver som kostar, och alltid en i taget, när du trycker på dem. Du kan se det på sidan om Aeopro, AIsToHires verktyg för AEO-granskning och synlighet i AI.
Vanliga frågor
Varför citerar ChatGPT inte min webbplats?
I ordning efter frekvens: för att din robots.txt blockerar OAI-SearchBot (ofta oavsiktligt, genom att "AI" blockeras i klump), för att din server eller din WAF returnerar 403 till botarnas user-agents, för att ditt innehåll bara finns efter att JavaScript har körts, för att det inte finns något stycke som besvarar frågan på ett fristående sätt, eller för att andra källor helt enkelt citeras oftare för det ämnet. De tre första orsakerna är tekniska och går att kontrollera på några minuter.
Slutar jag synas i ChatGPT om jag blockerar GPTBot?
Inte nödvändigtvis. GPTBot är träningscrawlern; den som indexerar för ChatGPT:s sökning är OAI-SearchBot. De är oberoende tokens i robots.txt, så du kan vägra mata träningen och ändå gå att citera. Det som tar bort dig ur svaren är att blockera OAI-SearchBot (OpenAIs dokumentation).
Behöver jag en llms.txt-fil?
Det är inte nödvändigt och i dag finns det inga offentliga belägg för att de stora leverantörerna använder den i produktion. Google uppger att textfiler för AI eller särskild markup inte behövs för att synas i deras AI-funktioner, och i januari 2026 dementerade John Mueller att Google stöder den. Att lägga till den skadar inte; att tro att du därmed har gjort AEO gör det.
Hur vet jag om min webbplats syns utan JavaScript?
Ladda ned den råa HTML:en med curl -sL https://tudominio.com | sed -e 's/<[^>]*>/ /g' | wc -w och jämför antalet ord med det du ser i webbläsaren. Om skillnaden är en storleksordning beror ditt innehåll på rendering på klientsidan. I Aeopro är den jämförelsen redan gjord, med de två texterna sida vid sida och listan över block som saknas.
Ersätter AEO SEO?
Nej. SEO är fortfarande grunden: om du inte är indexerad och inte är snabb eller användbar finns det ingen möjlig AEO. Google säger det med egna ord: god SEO-praxis gäller fortfarande för deras AI-funktioner och det finns inga ytterligare krav. AEO lägger till ett lager: åtkomst för andra botar än Googlebot, innehåll som går att extrahera utan JavaScript och fristående stycken.
Hur mycket trafik får jag om jag citeras i ChatGPT?
Mindre än du skulle vilja, och det är bäst att ta det för givet från början. Pew mätte att länkarna inne i en AI-sammanfattning från Google klickas vid 1 % av besöken, och Cloudflare uppskattade i juli 2025 att det är ungefär 750 gånger svårare att få ett besök via OpenAI än med den klassiska sökmotorn. Värdet av citeringen ligger mer i varumärket och preferensen än i det direkta klicket.
Går det att garantera att man syns i AI-svar?
Nej, och inget ärligt verktyg kommer att garantera det. Generativa svar varierar mellan körningar och leverantörerna visar ingen sökbar ranking. Det som går att garantera är att ta bort de tekniska blockeringar som i dag utesluter dig och att mäta förekomsten med stickprov, med datum och antal upprepningar.
Hur ofta bör jag upprepa granskningen?
Efter varje driftsättning som berör mallar, robots.txt, CDN eller WAF, och som grundlig översyn varannan månad eller varje månad: botarnas namn och direktiven ändras flera gånger om året. Under 2025 och 2026 har nya tokens tillkommit –OAI-SearchBot, Claude-SearchBot, OAI-AdsBot– som inte fanns när många skrev sin robots.txt.
Slutsats: ta först bort blockeringarna, skriv sedan för att bli citerad
AEO är i dag 20 % skrivande och 80 % att inte stå i vägen. Innan du skriver om ett enda stycke, kontrollera att botarna som citerar kan ladda ned din sida, att din server inte svarar 403 till dem och att ditt innehåll finns utan JavaScript; de tre sakerna förklarar de flesta fall av osynlighet som syns i en granskning. Därefter kommer de fristående styckena, tabellerna, ren JSON-LD och verkliga datum.
Om du vill ha hela bilden av en URL utan att lägga eftermiddagen på det gör Aeopro –AEO-granskningsverktyget från AIsToHire– alla 99 kontroller, visar dig exakt vilket utdrag av din HTML som orsakar varje problem och genererar, för 44 av dem, patchen färdig att klistra in: granska en webbplats med Aeopro.
Klistra in URL:en till din webbplats i Aeopro och se på under en minut om botarna som citerar källor kan läsa dig, vad som hindrar dem och exakt hur du åtgärdar det.
Klistra in URL:en till din webbplats i Aeopro och se på under en minut om botarna som citerar källor kan läsa dig, vad som hindrar dem och exakt hur du åtgärdar det.Läs vidare
Visa alla inlägg →
93 % av sökningarna i AI Mode genererar inte ens ett klick: vad det betyder för din webbplats 2026

Därför har din bilförsäkring stigit 2026: genomsnittspremie på 1 412 € och rekordnivå

Bråka på WhatsApp eller prata ut personligen: vad vetenskapen säger om parkonflikter via meddelanden
