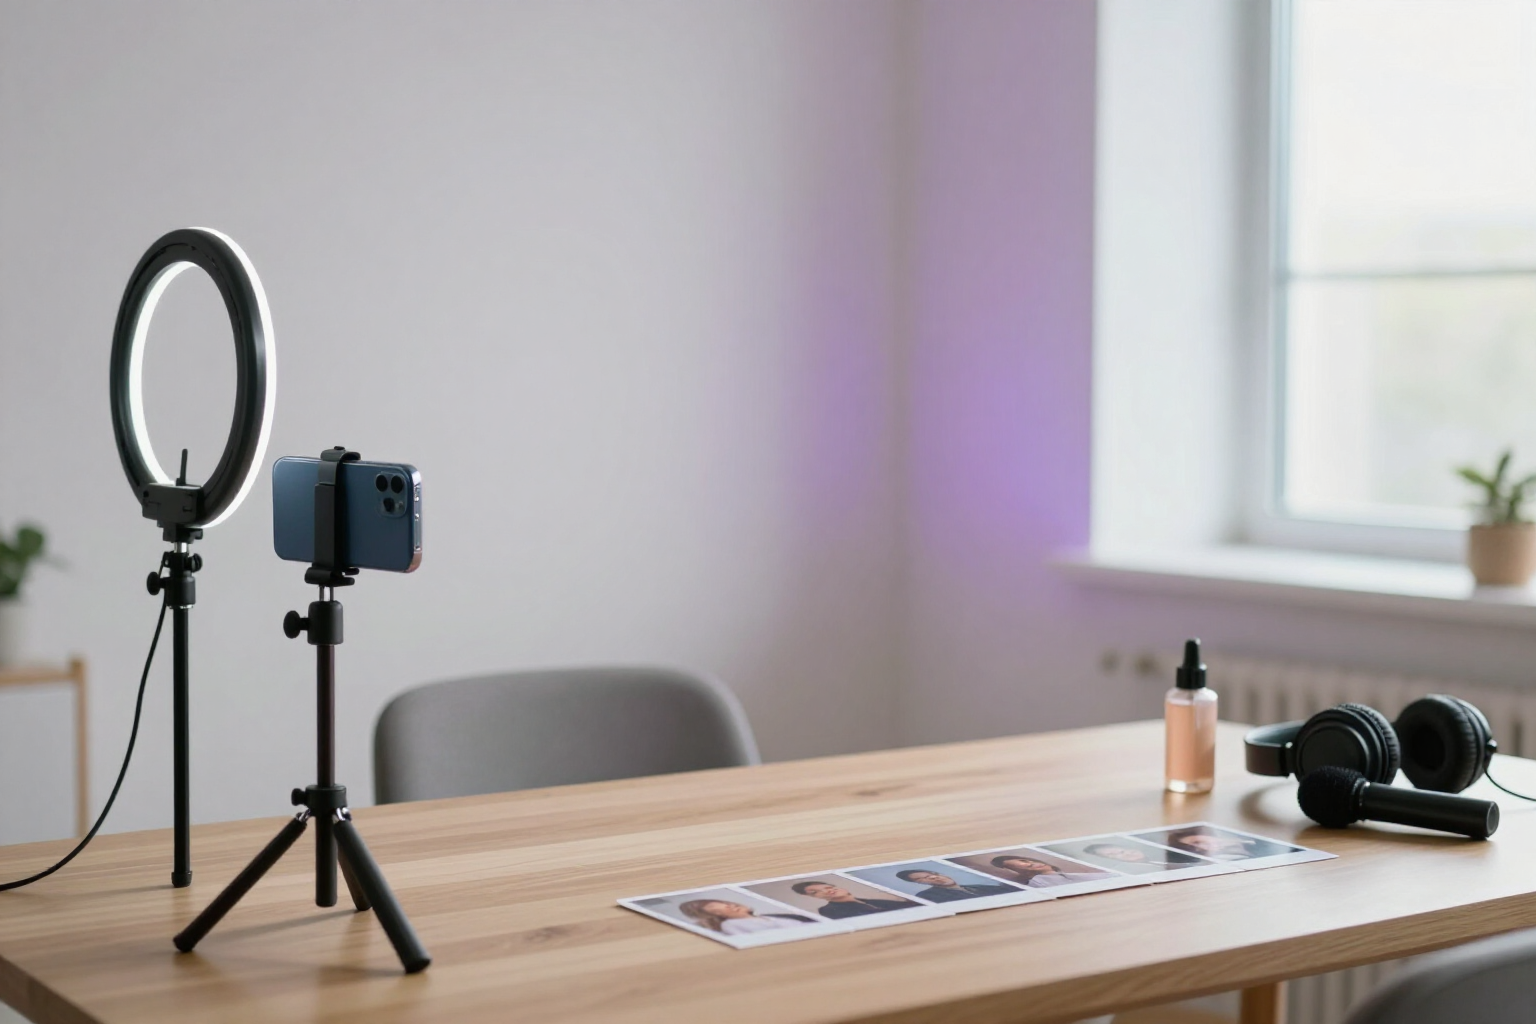
UGC Reels mit einem KI-Avatar, der in die Kamera spricht und mit nativer Stimme
Beschreibe deinen Avatar einmal, und Content Studio schreibt das Skript, erstellt das Storyboard Einstellung für Einstellung und liefert dir das bereits zusammengestellte vertikale Reel mit Stimme und Untertiteln.
UGC aufzunehmen kostet Zeit, eine Kamera und eine Person vor der Linse. Hier ist der Moderator dein eigener KI-Avatar, wiederverwendbar in all deinen Reels.
In Content Studio erstellst du zuerst deinen Avatar: Du lädst ein Foto hoch oder beschreibst ihn (Geschlecht, Alter, Stil, Aussehen und Stimmton) und die KI generiert sein Grundbild und ein 18-Zellen-Charakterblatt mit verschiedenen Gesichtern und Posen. Dieses Blatt sorgt dafür, dass derselbe Charakter in allen Einstellungen und in allen Reels, die du danach generierst, wiedererkennbar bleibt. Wenn du ein Produkt verkaufst, kannst du es mit bis zu sechs Referenzbildern hinzufügen und angeben, wie es auf dem Bildschirm erscheinen soll.
Sobald der Avatar bereit ist, schreibt die KI das Skript in drei Blöcken — Aufhänger, Entwicklung und Call-to-Action — mit kurzen, für die Vertonung konzipierten Sätzen, und wandelt es in ein Storyboard von bis zu zwölf Einstellungen um. Jede Einstellung enthält ihren genauen Text, ihren Kameraausschnitt, die Geste des Avatars und die Art der Aufnahme: Avatar spricht in die Kamera, oder alternative B-Roll- oder Produktaufnahme. Alles ist bearbeitbar: Du schreibst einen Satz um, änderst den Bildausschnitt, ordnest Einstellungen neu an, fügst sie hinzu oder löschst sie, oder lädst dein eigenes Bild für eine bestimmte Einstellung hoch.
Das Rendering erfolgt in zwei Phasen, damit du es überprüfen kannst, bevor du Geld für das Video ausgibst. Zuerst wird der Einzelbild-Frame jeder Einstellung generiert, nacheinander verkettet, wobei der vorherige als Referenz dient, damit die Szene nicht springt; du kannst jedes Bild mit einer Anweisung verfeinern, bevor du fortfährst. Danach wird jede Avatar-Einstellung in einen echten Videoclip umgewandelt mit nativer Stimme, generiert von Gemini Omni Flash (ca. acht Sekunden pro Einstellung), wobei jeder Clip mit dem vorherigen verknüpft wird, um dieselbe Person und dieselbe Stimme beizubehalten. Der Akzent der Stimme wird nach Sprache ausgewählt, mit Unterstützung für Spanisch, Englisch, Französisch, Deutsch, Italienisch, Portugiesisch, Niederländisch und Katalanisch.
Die endgültige Montage erfolgt durch den Server mit ffmpeg: Er extrahiert die native Stimme aus jedem Clip, vertonnt mit TTS die B-Roll-Einstellungen, die Text enthalten, normalisiert alles auf 1080x1920 vertikal bei 30 fps, brennt die Untertitel ein und mischt Hintergrundmusik aus dem Jamendo-Katalog mit der von dir gewählten Lautstärke. Das Ergebnis ist eine herunterladbare vertikale MP4-Datei, die in der Kreation gespeichert wird, bereit, in den Redaktionskalender übernommen und von dir auf Instagram, TikTok oder YouTube Shorts hochgeladen zu werden. Es ist Teil von Content Studio bei AIsToHire: https://aistohire.com/de/content-studio-soziale-medien-inhalte-ki-158
Vorteile von UGC Reels mit KI-Avatar
Ein eigener Moderator ohne Kamera
Du erstellst den Avatar aus einem Foto oder einer Beschreibung und verwendest ihn in all deinen Reels wieder, ohne Dreharbeiten, ohne Studio und ohne von jemandes Terminkalender abhängig zu sein.
Derselbe Charakter in allen Aufnahmen
Das Basisbild plus ein 18-Zellen-Charakterblatt dienen als Referenz in jedem Frame, und die Clips werden miteinander verknüpft generiert, damit sich Gesicht oder Stimme mitten im Reel nicht ändern.
Native Stimme mit dem Video generiert, nicht nachträglich eingefügt
Gemini Omni Flash produziert Bild und Sprache in einem Durchgang, wobei die Lippenbewegung vom Modell selbst gesteuert wird.
Skript und Storyboard für Kurzformat geschrieben
drei Blöcke: Hook, Entwicklung und Abschluss, und Sätze von weniger als zehn Sekunden, verteilt auf bis zu zwölf Aufnahmen, jede mit ihrer eigenen Einstellung und Geste.
Sie überprüfen, bevor Sie Geld für Video ausgeben
Das Rendering erfolgt in zwei Phasen, zuerst der Frame jeder Aufnahme und erst danach der Clip, so korrigieren Sie ein Bild, das Ihnen nicht gefällt, ohne das gesamte Video zu bezahlen.
b-roll und Produktaufnahmen
Wechseln Sie den sprechenden Avatar mit von KI generierten oder von Ihnen hochgeladenen unterstützenden Aufnahmen ab, und fügen Sie Ihr Produkt mit bis zu sechs Referenzbildern hinzu, damit es kohärent erscheint.
Reel fertig montiert und bereit zur Veröffentlichung
Der Server fügt Stimme, Musik und burned-in subtitles in einem vertikalen MP4 von 1080x1920 bei 30 fps zusammen, ohne einen Video-Editor öffnen zu müssen.
Eine Version pro Sprache
Sie wählen den Sprachakzent aus acht Sprachen und verwenden das Storyboard der Mastersprache wieder, um dasselbe Reel in den anderen Sprachen zu generieren.
Ihr Avatar ist bereit zum Aufnehmen
Beschreiben Sie Ihren Avatar, lassen Sie die KI das Skript schreiben und laden Sie Ihr vertikales Reel mit Stimme und Untertiteln herunter.