 AisDrive
Jak uspořádat soubory projektu: struktura složek, názvy a test 10 sekund
Tým AisDriveNapsáno s pomocí AI15 min čteníShrnutí
- Problém téměř nikdy není objem souborů, ale nejednoznačnost: pokud by dokument mohl být ve dvou různých složkách, dříve nebo později skončí v obou. Proto dobrá struktura není ta nejúplnější, ale ta, která nepřipouští pochybnosti.
- Stačí tři úrovně a každá úroveň musí odpovídat jedinému kritériu (kdo → co → kdy). Od čtvrté úrovně náklady na ukládání převyšují náklady na hledání.
- Dej datum na začátek a ve formátu ISO 8601 (
RRRR-MM-DD): je to jediný formát, ve kterém abecední řazení odpovídá chronologickému, bez jakéhokoli nastavování. - Vyhni se znakům, které Windows zakazuje (
< > : " / \ | ? *) a rezervovaným názvům (CON,PRN,AUX,NUL,COM1–COM9,LPT1–LPT9): soubor s takovým názvem nelze zkopírovat do počítače s Windows. - Pokud tvé soubory budou krmit AI, složka přestává být dekorací: v AisDrive rozhoduješ po složkách, co se indexuje, a chat cituje cestu ke složkám souboru, z něhož každou odpověď vzal.
Pokud jsi hledal „jak uspořádat soubory projektu“, je to proto, že problém už máš: složku Stažené s 400 věcmi, tři verze téhož rozpočtu a jistotu, že smlouva je uložená někde. Tento článek není seznam dobrých předsevzetí: je to konkrétní struktura, pravidla pojmenování, která můžeš použít ještě dnes, a test, jak ověřit, že fungují. Na konci uvidíš, jak se to sestaví v AisDrive, správci souborů s AI chatem od AIsToHire, který přidává nový rozměr: když asistent čte tvé dokumenty, organizace přestává být estetická a rozhoduje o tom, na co ti dokáže odpovědět.
Vše, co je o AisDrive popsáno, jsou implementované funkce a hodnoty ověřené v říjnu 2026. To, co aplikace nedělá, je také napsáno, ve vlastní sekci.
Proč své soubory nenajdeš, i když sis je uložil sám?
Protože problém není ve vyhledávání, ale v okamžiku ukládání. Pokaždé, když by soubor mohl jít na dvě rozumná místa, tvé dnešní já vybere jedno a tvé já za šest měsíců hledá na druhém. Tato nejednoznačnost opakovaná stokrát promění „logickou“ strukturu v bludiště.
Tři skutečné příčiny, podle četnosti:
- Smíšená kritéria na téže úrovni. Máš současně
Klienti/,2025/,Faktury/aCeka/visící z kořene. Jsou to čtyři různé osy (kdo, kdy, co, stav) soupeřící o totéž místo. Podepsaná smlouva klienta z roku 2025 pasuje do všech čtyř. - Přílišná hloubka. Když je potřeba šest kliknutí, aby ses něco uložil, neuloží se: nechá se „na chvilku“ na ploše.
- Názvy, které dávaly smysl jen v ten den.
nabidka_final_v2_DOBRA_ok.docxbyl v úterý, kdy jsi ho psal, naprosto jasný.
Důsledek není jen ztráta času. Je to duplikace: stejný dokument ve dvou složkách, upravený jen v jedné, a nikdo neví, který je platný.
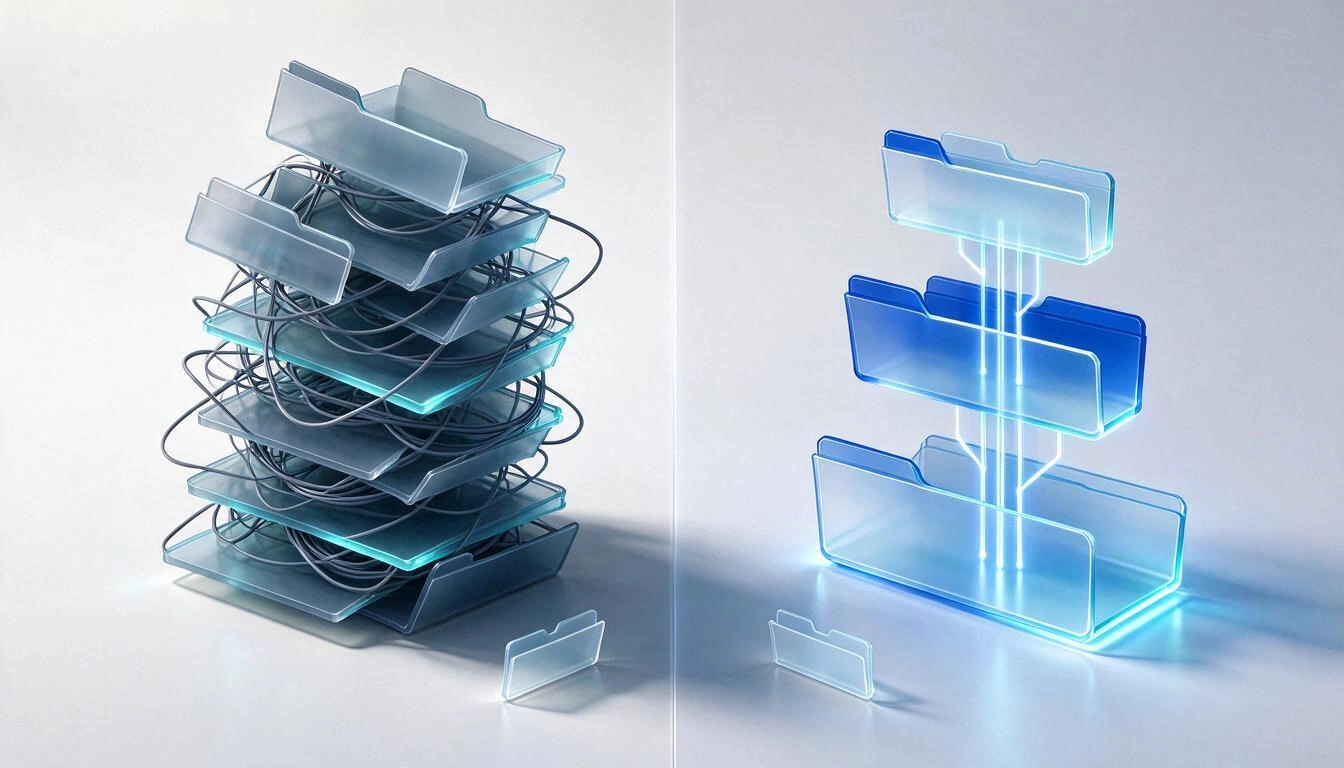
Struktura, která funguje: tři úrovně a jediné kritérium na úroveň
Pravidlo je jednoduché: jedno kritérium na úroveň, nanejvýš tři úrovně a čtvrtá úroveň se nahradí názvem souboru. Název souboru je zdarma a nekonečný; složka stojí jedno kliknutí při každém ukládání a další při každém hledání.
Kostra, která obstojí téměř v každé práci po projektech:
Klienti/
  2026-03 Klient ABC — Redesign webu/
    01-vstup/
    02-prace/
    03-predano/
  2026-05 Klient XYZ — Audit/
    01-vstup/
    02-prace/
    03-predano/
Administrativa/
  2026/
    faktury-vystavene/
    faktury-prijate/
Sablony/
Tři rozhodnutí, díky kterým to funguje:
- Úroveň 1 je „kdo nebo pro co“: klienti, administrativa, šablony. Málo složek, stabilních po léta.
- Úroveň 2 je projekt nebo rok a začíná datem, aby se řadila sama.
- Úroveň 3 je fáze, očíslovaná (
01-,02-,03-), aby pořadí odpovídalo práci, a ne abecedě. Vždy stejné tři složky ve všech projektech: díky tomu se můžeš pohybovat poslepu.
Jaké kritérium použít na první úrovni podle své práce
| Kritérium úrovně 1 | Kdy je správné | Kde selhává |
|---|---|---|
| Podle klienta | Pracuješ na zakázky pro třetí strany a každý má svou historii | Pokud stejnou práci sdílejí dva klienti |
| Podle projektu | Dlouhé projekty s týmem, málo opakující se | Když má klient 20 malých projektů |
| Podle roku | Účetní, daňová nebo právní dokumentace s ročním cyklem | U kreativní práce: to, co bylo v lednu, se v březnu zapomene |
| Podle typu dokumentu | Referenční archivy (šablony, předpisy, manuály) | Jako hlavní osa podnikání: všechno skončí v „Ostatní“ |
Nejběžnější chyba je používat podle typu dokumentu na úrovni 1 všeho. Funguje to pro referenční archivy; pro živou práci to nutí rozdělit jeden projekt mezi šest složek.
Složka 00-inbox a proč ji potřebuješ
Přidej do kořene složku 00-inbox a hoď tam všechno, co přijde a co v tu chvíli nechceš třídit. Je to schránka, ne sklad: podmínkou je vyprázdnit ji v pevném termínu (jednou týdně, deset minut). Bez schránky slouží jako schránka plocha a plocha se nikdy nevyprázdní.
Jak pojmenovat soubor, aby za tebe pracovalo abecední řazení
Dej datum na začátek a piš ho jako RRRR-MM-DD. Je to základní formát normy ISO 8601-1:2019 a má vlastnost, kterou nemá žádný jiný: seřazený abecedně je seřazený chronologicky. 2026-01-09 je před 2026-10-02 v jakémkoli systému, bez nastavování a bez nejednoznačnosti mezi evropským a americkým formátem.
Úplná šablona:
RRRR-MM-DD_projekt_typ_vNN.přípona
2026-03-14_abc-redesign_nabidka_v03.pdf
2026-05-02_xyz-audit_zprava_v01.docx
Pravidla, která předejdou 90 % problémů:
- Malá písmena a bez mezer. Používej pomlčky nebo podtržítka. Mezery vyžadují v terminálu uvozovky a v URL se mění na
%20. - Bez diakritiky v názvech, které budou putovat mezi systémy. macOS a Linux kódují háčky a čárky jinak (NFD oproti NFC) a objevují se duplicitní názvy, které vypadají identicky.
- Verze se dvěma číslicemi (
v01,v02…v10). S jednou číslicí sev10řadí předv2. - Nikdy „final“.
final,definitivniaDOBRAjsou názvy tří verzí před poslední. Pokud potřebuješ označit platnou, použij datum. - Od obecného ke konkrétnímu. Nejdřív to, co sdílí mnoho souborů (datum, projekt), nakonec to, co je odlišuje (typ, verze). Související soubory pak zůstanou pohromadě.
Znaky a názvy, které nemůžeš použít
Windows si rezervuje konkrétní seznam znaků a názvů. Soubor, který je používá, může existovat v Linuxu nebo macOS, ale nepůjde zkopírovat ani otevřít v počítači s Windows, což se zjistí vždy v nejhorší chvíli (při předávání složky klientovi).
| Co | Podrobnosti | Důsledek, když to ignoruješ |
|---|---|---|
| Znaky zakázané ve Windows | < > : " / \ ? *, svislá čára a řídicí znaky (0–31) | Soubor nelze ve Windows vytvořit ani zkopírovat |
| Rezervované názvy ve Windows | CON, PRN, AUX, NUL, COM1–COM9, LPT1–LPT9, s příponou i bez ní | Systém je chápe jako zařízení, ne jako soubory |
| Tečka nebo mezera na konci | zprava. nebo zprava | Windows je tiše odstraní: dva soubory pak mají stejný název |
| Délka celé cesty | Historický limit 260 znaků (MAX_PATH); Windows 10 verze 1607 a novější povolují dlouhé cesty, ale je nutné to zapnout a ne všechny aplikace to respektují | Složky, které nelze zkopírovat ani zkomprimovat |
| Délka názvu | 255 znaků na komponentu v NTFS, APFS a ext4 | Zkrácení při synchronizaci |
Zdroj: dokumentace Microsoftu „Naming Files, Paths, and Namespaces“, platná k říjnu 2026.
V macOS a Linuxu je seznam mnohem kratší (/ a nulový bajt), ale pokud někdy budeš složku sdílet, platí přísnější pravidlo: to z Windows.
Test 10 sekund: jak poznat, jestli ti struktura k něčemu je
Vezmi pět souborů, které jsi uložil před více než třemi měsíci, a zkus se dostat ke každému bez použití vyhledávání, za méně než 10 sekund a nanejvýš třemi kliknutími. Pokud neuspěješ u dvou z pěti, problém není v tvé paměti: je ve struktuře.
Je to test, který navrhuji jako praktické kritérium, ne jako oficiální standard. To, co měří, je ale objektivní: pokud potřebuješ něco najít vyhledáváním, znamená to, že hierarchie neodpovídá tomu, jak o svých souborech přemýšlíš.
Pět rychlých kontrol, v pořadí:
- Je nějaká složka s více než 50 volnými položkami? Chybí jí úroveň nebo kritérium.
- Je nějaká složka, která má uvnitř jen jednu položku? Je navíc: posuň soubor o úroveň výš.
- Existují dvě složky, které by mohly obsahovat stejný dokument? Sluč je, nebo písemně stanov, která platí.
- Dokážeš jednou větou říct, jaké kritérium odděluje složky téže úrovně? Pokud ne, kritérium je smíšené.
- Jsou názvy srozumitelné i mimo svou složku? Pokud po přesunutí souboru na plochu přestane být jasné, co to je, název závisí na cestě a to je křehké.
Co se mění, když tvé soubory čte AI: složka se stává rozhodnutím
Když AI asistent odpovídá o tvých dokumentech, složka přestává být šuplíkem a stává se rozsahem toho, co asistent může číst. V AisDrive je to doslovné: rozhoduješ, které soubory se indexují, můžeš označit celé složky, aby se automaticky indexovalo vše, co do nich nahraješ, a každá odpověď chatu cituje cestu ke složkám souboru, z něhož vzešla.
Tento detail mění to, jak je vhodné strukturu navrhovat:
- Název složky je citace. Pokud ti chat odpoví s odkazem na
Klienti/2026-03 Klient ABC — Redesign webu/01-vstup/zadani.pdf, název složky ti říká, jestli se na ten zdroj můžeš spolehnout. Složka s názvemveci/do odpovědi nepřináší nic. - Odděl to, na co se chceš moci ptát, od toho, na co ne. Smlouvy, zadání, zápisy a manuály ve složkách indexovaných; surová videa, mezivýstupy exportů a zálohy ve složkách bez indexace.
- Indexování není zadarmo, a proto je volitelné. V AisDrive se automatické indexování zapíná složku po složce (včetně kořene), nikdy globálně: indexování spotřebovává tokeny AI a počítá se do měsíčního limitu operací tvého plánu. Rozhodnutí je tvé a ukládá se po složkách.
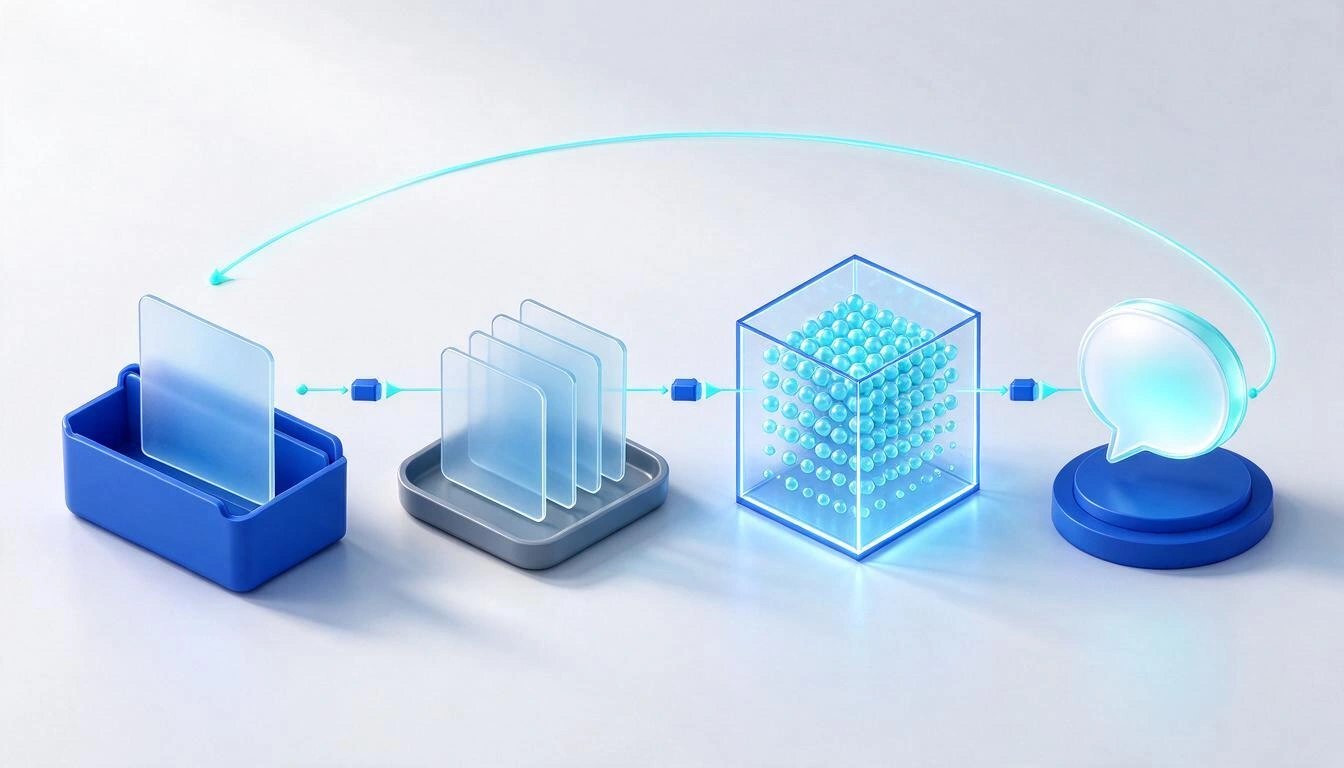
Co se stane se souborem, když ho indexuješ
Proces má čtyři kroky a probíhá na pozadí, ve frontě: nahraješ soubor, extrahuje se jeho text, text se rozdělí na části a každá část se převede na vektor. Mezitím soubor v seznamu zobrazuje stavovou značku (jantarová, dokud pracuje, zelená, když je hotový, červená, pokud selhal) a aplikace zjišťuje stav každých 5 sekund, dokud neskončí.
Skutečné parametry procesu v AisDrive, k říjnu 2026:
| Krok | Jak funguje |
|---|---|
| Dělení | Bloky po 400 slovech s 50 slovy překryvu mezi bloky, aby rozdělená věta stále vystupovala celá v nějakém úseku |
| Vektorizace | Model embeddingů gemini-embedding-001 |
| Vyhledávání | Chat vyhledá 6 úseků nejpodobnějších tvé otázce |
| Odpověď | Vytváří se pouze z těchto úseků, s pokynem nic nevymýšlet a citovat cestu ke složkám, nikdy interní cesty ani identifikátory |
| Zdroje | Každá odpověď uvede použité soubory; po kliknutí na jeden aplikace přejde do jeho složky |
Pokud není nic indexováno, chat to řekne, místo aby odpověď vymýšlel. Je to záměrné.
Které soubory lze indexovat a které spotřebovávají tokeny
AisDrive indexuje 18 přípon, rozdělených do tří způsobů extrakce textu. Rozdíl je důležitý, protože jen jeden ze tří potřebuje model vidění, což je ten, který spotřebovává tokeny za čtení kromě tokenů za vektorizaci.
| Režim | Přípony | Jak se extrahuje text | Náklady na čtení |
|---|---|---|---|
| Text | txt, md, csv, tsv, json, xml, html, htm, svg | Dekóduje se přímo na serveru | 0 tokenů |
| Kancelářské | docx, xlsx, pptx | Soubor se otevře a přečte se jeho vnitřní XML (listy a snímky se označují jeden po druhém) | 0 tokenů |
| Vidění | pdf, jpg, jpeg, png, webp, gif | Odešle se multimodálnímu modelu, který čte stránku | Spotřebovává tokeny |
Praktické důsledky:
.docxstojí za indexování méně než tentýž dokument exportovaný do PDF. Pokud máš kancelářský originál, nahraj originál.- Tabulka se indexuje se zachováním číselných hodnot a s označením každého listu, takže dotaz na konkrétní číslo funguje.
- Každá jiná přípona není indexovatelná a aplikace tu možnost ani nenabízí:
.zip,.mp4nebo.dwgse uloží a stáhnou normálně, ale chat je nečte. - Krok vektorizace tokeny spotřebovává vždy, i v režimech s nulovými náklady na čtení. „0 tokenů“ se týká extrakce, ne celého procesu.
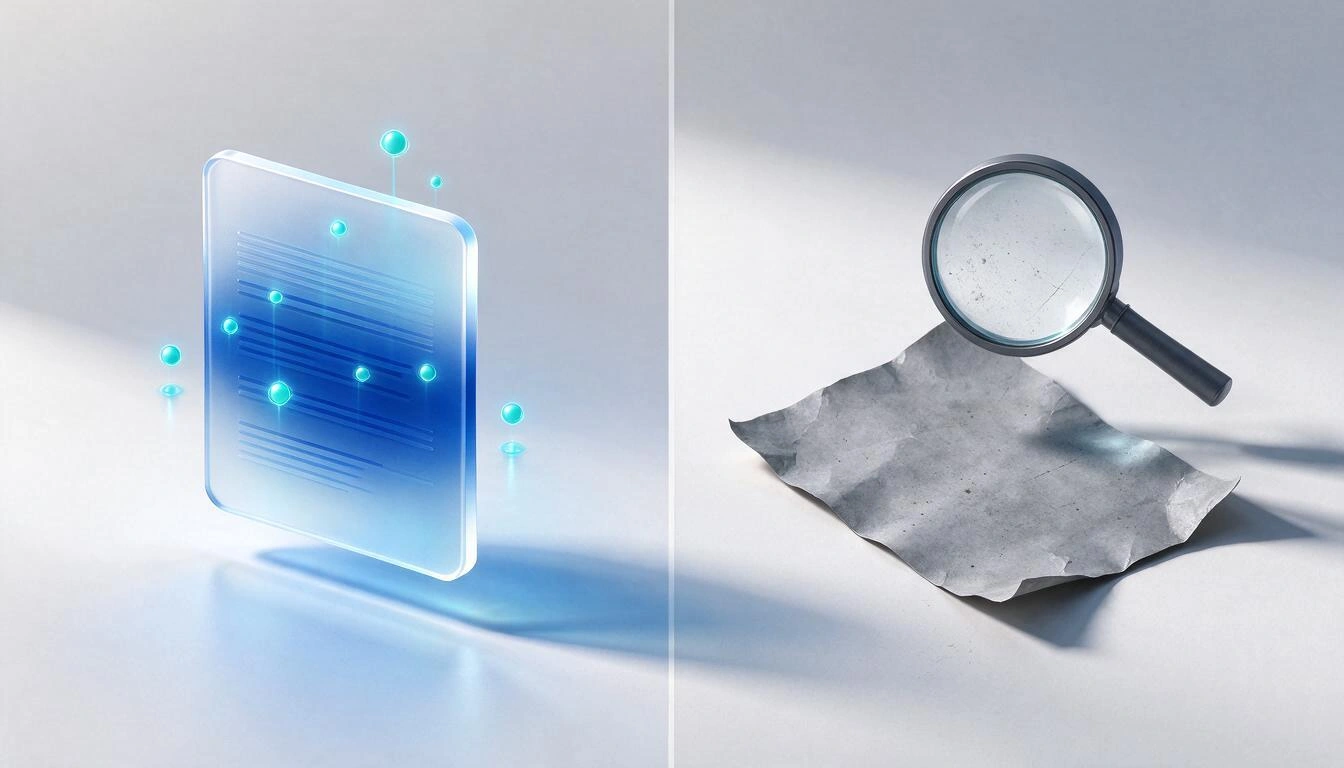
Proč naskenované PDF někdy zůstane červené
PDF, které je fotografií papíru, neobsahuje text: obsahuje obrázek. Model vidění ho může přečíst, pokud je sken čitelný, ale pokud je kvalita špatná, je nakřivo nebo jde o prázdnou stránku, extrakce vrátí nulový text. V tom případě AisDrive označí soubor jako chybu, ne jako hotový.
Je to vědomé rozhodnutí: soubor s nulou úseků, ale se zelenou značkou by vyvolal dojem, že ho chat může prohledávat, zatímco ho nikdy nenajde. Raději upřímná červená s možností zkusit znovu než zelená, která lže.
Skutečné limity AisDrive, než cokoli nahraješ
Vyplatí se je znát před návrhem struktury, protože některý z nich ovlivňuje, jak soubory rozdělíš:
| Limit | Hodnota | Co to znamená |
|---|---|---|
| Velikost na soubor | 20 MB | Video nebo velmi těžké PDF je třeba rozdělit nebo nechat stranou |
| Celkový prostor | Kvóta úložiště tvého plánu | Kontroluje se při každém nahrání; pokud se nevejde, nahrání se odmítne s jasným upozorněním |
| Mazání složek | Jen pokud jsou prázdné | Je nutné je nejdřív vyprázdnit; brání omylem přetáhnout stovky souborů do koše |
| Historie chatu | Neukládá se | Po obnovení stránky konverzace začíná od nuly (soubory a jejich indexace zůstávají) |
| Indexace | Asynchronní, ve frontě | Soubor je k dispozici okamžitě; dotazovat se na něj v chatu lze, až se dokončí indexace |
| AI chat | Vyžaduje dostupné tokeny plánu | Pokud nestačí, aplikace na to upozorní, než cokoli provede |
A dvě věci, které AisDrive nedělá, abys nebyl překvapen:
- V aplikaci není vyhledávání podle názvu souboru. Navigujeme po složkách, s cestou stále viditelnou nahoře, nebo se ptáme chatu na obsah. To je přesně důvod, proč tento článek tolik trvá na struktuře a názvech.
- Chat nečte to, co jsi neindexoval. Soubor nahraný bez indexace je soubor uložený, nic víc. Ve výchozím nastavení neexistují odpovědi „ze všeho na tvém disku“.
Jak převést nepořádnou složku na tuto strukturu za hodinu
Sedm kroků, v tomto pořadí. Pomalá část je čtvrtá; ostatní jsou minuty.
- Nejdřív vytvoř prázdnou kostru. Úroveň 1 (tři nebo čtyři složky) a uvnitř pilotního projektu tři fáze
01-vstup,02-prace,03-predano. Nevytvářej nic, o čem nevíš, že použiješ. - Nahrávej po dávkách, složku po složce. Můžeš vybrat více souborů najednou nebo je přetáhnout přímo na cílovou složku, i z plochy počítače.
- Přesuň, co je špatně umístěné. V počítači přetažením souboru na složku nebo na libovolný úsek cesty nahoře, abys ho posunul o úroveň výš. V mobilu volbou „Přesunout“ v nabídce každé položky, která otevře prohlížeč složek.
- Přejmenovávej při přesouvání, ne potom. Použij
RRRR-MM-DD_projekt_typ_vNN. Při přejmenování souboru se označí jen název, bez přípony, takže ji omylem neztratíš. - Označ pro automatické indexování jen složky s dokumenty, které chceš prohledávat. Typicky
01-vstupa03-predano; téměř nikdy02-prace, která je plná mezilehlých verzí, jež zašpiní odpovědi. - Ručně indexuj to, co už bylo nahráno, a zkontroluj stavové značky. U těch, které zůstanou červené, se podívej na název: téměř vždy jde o nečitelné skeny nebo prázdné soubory.
- Polož chatu kontrolní otázku. Něco, na co znáš odpověď, a ověř, že zdroj, který cituje, je správný soubor. Pokud citace není ta, kterou jsi čekal, problém bývá v tom, že jsou indexované dvě verze téhož dokumentu.
Užitečný detail na závěr: složka, ve které se nacházíš, se odráží v adrese prohlížeče, takže si můžeš uložit do záložek URL konkrétní složky a vrátit se k ní přímo.
Často kladené otázky
Kolik úrovní složek bych měl mít maximálně?
Tři. Úroveň 1 pro „kdo nebo pro co“, úroveň 2 pro projekt nebo rok, úroveň 3 pro fázi. Vše, co chceš přidat níž, se vejde do názvu souboru, který nestojí žádná kliknutí. AisDrive hloubku neomezuje — můžeš vnořovat, kolik chceš —, ale od čtvrté úrovně se ukládání stává tak drahým, že se přestane dělat.
Je lepší organizovat podle klienta, nebo podle data?
Podle klienta na první úrovni a podle data na druhé, pokud pracuješ na zakázky. Pro účetní, daňovou nebo právní dokumentaci naopak: rozhoduje rok, protože cyklus je roční. Skutečné pravidlo není, které si vybereš, ale že je nesmíchat na téže úrovni.
Jak pojmenovat soubor, aby neskončil duplikovaný?
RRRR-MM-DD_projekt_typ_vNN.přípona, malými písmeny, bez mezer a diakritiky, s verzí na dvě číslice. Datum na začátku způsobí, že abecední řazení je chronologické, a číslování verzí odstraňuje cyklus „final, definitivní, dobrá“. Nikdy nepoužívej slovo „final“: vždycky se objeví další verze.
Proč je moje PDF zobrazeno jako indexované, ale AI říká, že nic nenachází?
Nejpravděpodobněji je PDF sken bez čitelného textu. V AisDrive se soubor, z něhož nelze extrahovat text, označí červeně jako chyba, právě aby nevypadal prohledatelně. Pokud je zelený a přesto se nenachází, zkus se zeptat slovy, která v dokumentu jsou: chat vyhledává šest úseků nejpodobnějších tvé otázce a pokud je dokument dlouhý, relevantní úsek může zůstat mimo.
Mohu nahrát soubor o velikosti 50 MB?
Ne. Limit na soubor v AisDrive je 20 MB. Celkový dostupný prostor navíc závisí na kvótě úložiště tvého plánu, která se kontroluje při každém nahrání.
Musím indexovat všechny své soubory?
Ne, a obvykle to není žádoucí. Automatické indexování se zapíná složku po složce, takže je běžné indexovat složky s prohledávatelnými dokumenty (smlouvy, zadání, zprávy, manuály) a vynechat mezi verze, surové materiály a kopie. Indexování spotřebovává tokeny a počítá se do měsíčního limitu operací tvého plánu.
Čte AI soubory, které jsem neindexoval?
Ne. Chat odpovídá pouze z úseků souborů, které jsi indexoval; pokud žádný není, řekne to, místo aby odpověď vymýšlel. Soubor nahraný bez indexace se normálně uloží, otevře a stáhne, ale do odpovědí nevstupuje.
Ztratí se konverzace v chatu, když stránku obnovím?
Ano. Historie chatu žije jen po dobu, kdy je karta otevřená: po obnovení konverzace začíná od nuly. Neztratí se soubory ani jejich indexace, které zůstávají beze změny.
Které soubory lze přesně indexovat?
Osmnáct přípon: txt, md, csv, tsv, json, xml, html, htm, svg, docx, xlsx, pptx, pdf, jpg, jpeg, png, webp a gif. Ostatní lze nahrát a stáhnout, ale neindexují se a aplikace tu možnost ani nenabízí.
Mohu si uložit odkaz na konkrétní složku?
Ano. Složka, ve které se nacházíš, se odráží v adrese prohlížeče, takže si ji můžeš přidat do záložek a vrátit se k ní přímo. Pokud tato složka už neexistuje, aplikace otevře kořen místo toho, aby zobrazila chybu.
Co se stane, když smažu složku, která má uvnitř soubory?
Nesmaže se. AisDrive umožňuje mazat jen prázdné složky a upozorní, pokud mají obsah. Nejdřív je třeba přesunout nebo smazat to, co je uvnitř, což brání ztrátě stovek souborů jedním kliknutím.
Správné uspořádání souborů mělo vždy neurčitou odměnu: najít je dřív. Když je navíc čte asistent, odměna se stává konkrétní a měřitelnou, protože kvalita odpovědí závisí přímo na tom, které složky ses rozhodl indexovat a jak jsi věci pojmenoval. AisDrive je správce souborů od AIsToHire, který ti umožňuje organizovat dokumenty do složek a ptát se jich přirozeným jazykem: indexuješ soubory, které sám vybereš, ptáš se a každá odpověď ti řekne, z jakého souboru a z jaké složky vzešla. Najdeš ho na AisDrive – Správce souborů.
Vytvoř si strukturu složek v AisDrive, nahraj své dokumenty a označ jen ty složky, které chceš moci prohledávat: pak se ptej přirozeným jazykem a každá odpověď ti řekne, z jakého souboru a z jaké složky pochází. Začni zdarma.
Vytvoř si strukturu složek v AisDrive, nahraj své dokumenty a označ jen ty složky, které chceš moci prohledávat: pak se ptej přirozeným jazykem a každá odpověď ti řekne, z jakého souboru a z jaké složky pochází. Začni zdarma.Číst dál
Zobrazit všechny články →
Jak archivovat faktury před Verifactu 2027: doby uchovávání, formáty a co musíš umět najít při kontrole

Hádka přes WhatsApp, nebo rozhovor osobně: co říká věda o partnerských konfliktech přes zprávy

Myšlenková mapa, pojmová mapa a osnova: rozdíly a kdy použít kterou
